Java Kafka图像数据消费:解决反序列化与数据接收问题

Java Kafka图像数据消费:解决反序列化与数据接收问题

本文旨在提供一份专业的Java Kafka消费者教程,重点解决在消费二进制数据(如图像)时常见的ClassCastException和数据接收不完整问题。我们将深入探讨Kafka消费者配置,特别是值反序列化器的正确选择,以及如何优化消费循环逻辑和避免常见陷阱,确保高效、稳定地接收和处理Kafka消息中的图像数据。

1. Kafka消费者基础配置

在使用java kafka消费者接收消息时,正确的配置是关键。以下是一个典型的kafka消费者配置示例,其中包含了接收二进制数据(如图像)所需的核心属性。

import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.KafkaConsumer;import org.apache.kafka.common.serialization.StringDeserializer;import org.apache.kafka.common.serialization.ByteArrayDeserializer; // 导入ByteArrayDeserializerimport java.util.Properties;import java.util.Arrays;import java.time.Duration;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.ConsumerRecord;public class ImageConsumer {    private KafkaConsumer consumer;    private String topic;    public ImageConsumer(String bootstrapServers, String consumerId, String topic) {        Properties prop = new Properties();        // Kafka集群的连接地址        prop.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);        // 键的反序列化器,通常使用StringDeserializer        prop.setProperty(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());        // 值的反序列化器,对于图像等二进制数据,必须使用ByteArrayDeserializer        prop.setProperty(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, ByteArrayDeserializer.class.getName());        // 消费者组ID,用于管理消费者群组和偏移量        prop.setProperty(ConsumerConfig.GROUP_ID_CONFIG, consumerId);        // 当没有初始偏移量或当前偏移量无效时,如何重置偏移量        // "earliest"表示从最早的可用偏移量开始消费        prop.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest");        // 每次poll调用返回的最大记录数        // 默认值为500,如果设置为1,每次poll只会返回一条记录        prop.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, 500); // 建议设置为合理的值,或不设置使用默认值        this.consumer = new KafkaConsumer(prop);        this.topic = topic;        // 订阅指定主题,此操作通常在消费者初始化后执行一次        consumer.subscribe(Arrays.asList(topic));    }    // 示例:消费循环    public void startConsuming() {        System.out.println("Starting Kafka Consumer for topic: " + topic);        try {            while (true) { // 持续消费                // 轮询Kafka获取消息,设置超时时间                ConsumerRecords records = consumer.poll(Duration.ofMillis(100));                if (records.isEmpty()) {                    // System.out.println("No records received, polling again...");                    continue;                }                System.out.println("Received " + records.count() + " records.");                for (ConsumerRecord record : records) {                    System.out.println("Offset: " + record.offset() + ", Key: " + record.key() + ", Value length: " + record.value().length);                    // 处理接收到的图像数据 (byte[])                    byte[] imageData = record.value();                    // 这里可以添加图像处理逻辑,例如保存到文件或进行进一步分析                    // 例如:ImageIO.write(ImageIO.read(new ByteArrayInputStream(imageData)), "jpg", new File("image_" + record.offset() + ".jpg"));                }            }        } catch (Exception e) {            System.err.println("Error during consumption: " + e.getMessage());            e.printStackTrace();        } finally {            // 关闭消费者,释放资源            consumer.close();            System.out.println("Kafka Consumer closed.");        }    }    public static void main(String[] args) {        String bootstrapServers = "localhost:9092"; // 替换为你的Kafka服务器地址        String consumerId = "image-consumer-group";        String topicName = "image-topic"; // 替换为你的Kafka主题名        ImageConsumer imageConsumer = new ImageConsumer(bootstrapServers, consumerId, topicName);        imageConsumer.startConsuming();    }}

2. 核心问题:数据类型不匹配与反序列化器

在Kafka中,生产者发送的消息数据类型需要与消费者配置的反序列化器相匹配。原始问题中,消费者被声明为KafkaConsumer,这意味着它期望接收键为String、值为byte[]类型的消息。然而,初始的配置却将值的反序列化器设置为StringDeserializer.class.getName():

prop.setProperty(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());

当Kafka Broker发送的是二进制数据(例如图像的字节数组),而消费者尝试使用StringDeserializer去反序列化它时,就会发生类型不匹配。StringDeserializer期望接收UTF-8编码的字节序列并将其转换为字符串,而不是任意的二进制字节数组。因此,当consumer.poll()返回一个ConsumerRecord时,其value()方法返回的是一个String对象,而不是预期的byte[]。当尝试将这个String对象强制转换为byte[]时,就会抛出经典的java.lang.ClassCastException: class java.lang.String cannot be cast to class [B错误。

错误信息java.lang.String and [B are in module java.base of loader ‘bootstrap’清晰地表明,尝试将java.lang.String类型转换为[B(即byte[]的JVM内部表示)失败了。

3. 解决方案:使用ByteArrayDeserializer

解决ClassCastException的关键在于为值配置正确的反序列化器。对于图像或其他二进制数据,我们应该使用Kafka提供的ByteArrayDeserializer。它能够直接将接收到的原始字节数组作为byte[]返回,而无需进行任何字符串转换。

立即学习“Java免费学习笔记(深入)”;

正确的配置应为:

prop.setProperty(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, ByteArrayDeserializer.class.getName());

将此配置应用到消费者初始化代码中,即可解决ClassCastException。

4. 处理数据接收不完整问题

在解决了ClassCastException之后,原始问题中提到“第一个图像正确接收,但数组中其他元素为null”。这通常与消费循环的逻辑或MAX_POLL_RECORDS_CONFIG配置有关。
序列猴子开放平台 序列猴子开放平台

具有长序列、多模态、单模型、大数据等特点的超大规模语言模型

序列猴子开放平台 0 查看详情 序列猴子开放平台

主要原因分析:

MAX_POLL_RECORDS_CONFIG设置不当: 原始代码中存在一行配置:

prop.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, 1);

这个配置明确指示Kafka消费者在每次poll()调用时,最多只返回一条记录。这意味着,即使主题中有多个消息可用,consumer.poll(Duration.ofMillis(10))也只会返回一个ConsumerRecord。如果你的消费逻辑期望一次性处理多条记录并填充一个数组,而poll只返回一条,那么数组的其他位置自然会保持null或未赋值状态。

解决方案: 移除此配置,或者将其设置为一个更大的、合理的数值(例如500),以允许每次poll获取多条记录。默认情况下,MAX_POLL_RECORDS_CONFIG的值通常足以满足大多数场景。

消费循环逻辑:

consumer.subscribe(Collections.singletonList(Topic)); 在循环内部: 订阅操作应该在消费者初始化之后执行一次,而不是在每次循环迭代中重复执行。在循环内部重复订阅虽然可能不会直接导致错误,但会增加不必要的开销,并且在某些情况下可能影响消费者组的重新平衡。数组填充逻辑: 原始代码中的message_send[i]= java.util.Arrays.copyOf((byte[])record.value(), ((byte[])record.value()).length); 假设i会正确递增并且message_send数组足够大。如果MAX_POLL_RECORDS_CONFIG为1,那么每次poll只处理一个record,i在循环中只会递增一次,导致message_send数组只在[0]位置被填充。

改进建议:

将consumer.subscribe()移到消费者构造函数或初始化方法中,只执行一次。在处理ConsumerRecords时,遍历records集合,而不是依赖外部的计数器i,因为records集合的大小取决于MAX_POLL_RECORDS_CONFIG和实际可用的消息数量。

5. 最佳实践与注意事项

反序列化器与数据类型匹配: 始终确保ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG和ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG与你期望接收的键和值的数据类型相匹配。对于文本使用StringDeserializer,对于二进制数据使用ByteArrayDeserializer,对于自定义对象则需要实现自定义的反序列化器。MAX_POLL_RECORDS_CONFIG: 理解其作用,并根据应用程序的吞吐量需求和内存限制进行合理设置。过小会导致频繁的poll调用,增加网络开销;过大可能导致单次处理的数据量过大,增加内存压力。消费循环设计:subscribe()只调用一次。poll()方法是阻塞的,直到有数据或超时。确保设置合理的超时时间(Duration.ofMillis())。遍历ConsumerRecords时,直接使用for (ConsumerRecord record : records),而不是依赖外部索引。在处理完一批记录后,考虑手动提交偏移量(如果AUTO_COMMIT_OFFSET_CONFIG设置为false),以确保消息被正确消费。资源管理: 在应用程序关闭时,务必调用consumer.close()来关闭Kafka消费者,释放所有网络连接和系统资源。错误处理: 在消费循环中加入健壮的错误处理机制,例如使用try-catch块捕获消息处理过程中可能发生的异常,并决定是跳过当前消息、记录错误还是停止消费。

总结

在Java中通过Kafka消费者接收图像等二进制数据,核心在于正确配置VALUE_DESERIALIZER_CLASS_CONFIG为ByteArrayDeserializer,以避免ClassCastException。同时,优化消费循环逻辑,特别是对MAX_POLL_RECORDS_CONFIG的理解和合理设置,以及避免在循环中重复订阅主题,是确保数据完整且高效接收的关键。遵循这些最佳实践,可以构建稳定、高性能的Kafka图像数据消费应用程序。

以上就是Java Kafka图像数据消费:解决反序列化与数据接收问题的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/247063.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
DreamGen— 英伟达推出的新型机器人学习技术
上一篇 2026年10月7日 14:25:56
铁路12306怎么实名认证_铁路12306实名认证流程
下一篇 2025年11月26日 23:37:35

相关推荐

  • DreamGen— 英伟达推出的新型机器人学习技术

    DreamGen— 英伟达推出的新型机器人学习技术DreamGen— 英伟达推出的新型机器人学习技术DreamGen— 英伟达推出的新型机器人学习技术DreamGen— 英伟达推出的新型机器人学习技术

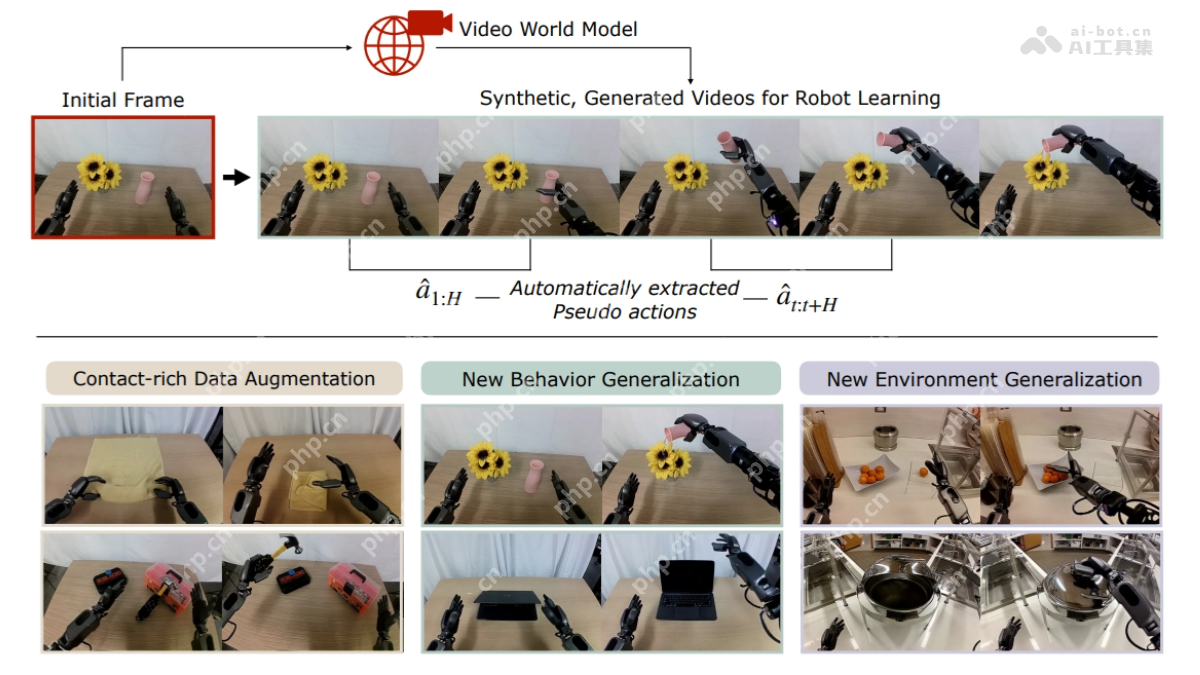
    DreamGen是什么 dreamgen是英伟达推出的创新的机器人学习技术,基于ai视频世界模型生成合成数据,让机器人能在梦境中学习新技能。dreamgen仅需少量现实视频数据,能生成大规模逼真的训练数据,实现机器人在新环境中的行为泛化和环境泛化。dreamgen的四步流程包括微调视频世界模型、生成…

    2026年10月7日 • 用户投稿
    000
  • Java分布式限流:基于Redis的滚动窗口与退避机制实现指南

    Java分布式限流:基于Redis的滚动窗口与退避机制实现指南Java分布式限流:基于Redis的滚动窗口与退避机制实现指南Java分布式限流:基于Redis的滚动窗口与退避机制实现指南Java分布式限流:基于Redis的滚动窗口与退避机制实现指南

    本文深入探讨了如何在Java应用中实现基于Redis的滚动窗口限流策略,并着重介绍了如何集成退避(Backoff)机制。我们将以Bucket4j库为例,详细阐述其配置、使用方法以及如何获取限流后的重试时间,帮助开发者构建健壮、响应式的分布式系统。 1. 引言:分布式限流的重要性 在现代高并发的分布式…

    2026年10月7日 • 用户投稿
    100
  • iPad分屏怎么用于儿童教育_iPad分屏学习与娱乐应用结合方法

    iPad分屏怎么用于儿童教育_iPad分屏学习与娱乐应用结合方法iPad分屏怎么用于儿童教育_iPad分屏学习与娱乐应用结合方法iPad分屏怎么用于儿童教育_iPad分屏学习与娱乐应用结合方法iPad分屏怎么用于儿童教育_iPad分屏学习与娱乐应用结合方法

    iPad分屏可提升儿童学习效率,通过合理搭配教育类与娱乐类App实现寓教于乐;设置方法为打开应用后从底部上滑调出Dock栏,拖拽第二个应用至侧边即可分屏;适合搭配如学习与绘画、阅读与笔记、编程与游戏等组合;家长可通过“屏幕使用时间”功能设置使用时长,约定规则并定期检查,防止沉迷;针对3-6岁以认知类…

    2026年10月7日 • 用户投稿
    000
  • Kotlin中Double类型字符串格式化:精确控制小数位与尾随零

    Kotlin中Double类型字符串格式化:精确控制小数位与尾随零Kotlin中Double类型字符串格式化:精确控制小数位与尾随零Kotlin中Double类型字符串格式化:精确控制小数位与尾随零Kotlin中Double类型字符串格式化:精确控制小数位与尾随零

    本文探讨在Kotlin中将Double类型转换为字符串时,如何有效保留尾随零。针对Double.toString()和DecimalFormat在处理不同小数位数时可能遇到的问题,我们将重点介绍如何利用String.format()方法,通过精确的格式化字符串,实现对小数位数和尾随零的完全控制,从而…

    2026年10月7日 • 用户投稿
    100
  • 如何在Mezzio中集成LaminasRouter:使用mezzio/mezzio-laminasrouter解决复杂路由管理难题

    如何在Mezzio中集成LaminasRouter:使用mezzio/mezzio-laminasrouter解决复杂路由管理难题如何在Mezzio中集成LaminasRouter:使用mezzio/mezzio-laminasrouter解决复杂路由管理难题如何在Mezzio中集成LaminasRouter:使用mezzio/mezzio-laminasrouter解决复杂路由管理难题如何在Mezzio中集成LaminasRouter:使用mezzio/mezzio-laminasrouter解决复杂路由管理难题

    可以通过以下地址学习Composer:学习地址 告别路由管理的“选择困难症”:Mezzio 与 Laminas Router 的完美融合 作为一名 PHP 开发者,我们都深知构建 Web 应用时路由的重要性。Mezzio 作为一款轻量级且高性能的 PSR-15 中间件框架,以其极高的灵活性和可插拔性…

    2026年10月7日 • 用户投稿
    100
  • MapStruct:处理列表内嵌对象属性名不一致的映射策略

    MapStruct:处理列表内嵌对象属性名不一致的映射策略MapStruct:处理列表内嵌对象属性名不一致的映射策略MapStruct:处理列表内嵌对象属性名不一致的映射策略MapStruct:处理列表内嵌对象属性名不一致的映射策略

    本文深入探讨了如何使用MapStruct高效地处理包含嵌套对象列表的复杂数据结构映射,特别是当源对象和目标对象的嵌套属性名称不一致时。我们将介绍两种核心策略:在主映射器中定义专用映射方法,以及通过@Mapper注解的uses属性引入独立的辅助映射器,从而避免繁琐的手动映射代码,提升代码的清晰度和可维…

    2026年10月7日 • 用户投稿
    700
  • 未经用户同意展示广告,谷歌被罚款 3.25 亿欧元

    未经用户同意展示广告,谷歌被罚款 3.25 亿欧元未经用户同意展示广告,谷歌被罚款 3.25 亿欧元未经用户同意展示广告,谷歌被罚款 3.25 亿欧元未经用户同意展示广告,谷歌被罚款 3.25 亿欧元

    法国国家信息和自由委员会(CNIL)周三宣布,对谷歌母公司Alphabet处以3.25亿欧元(约3.81亿美元)的罚款,原因是其在未获得用户明确同意的情况下,于Gmail服务中向用户账户持有人不当投放广告,并违规使用cookie进行追踪。 CNIL指出,谷歌需在六个月内整改相关做法,确保不再于未经用…

    2026年10月7日 • 用户投稿
    100
  • Java正则表达式在文本处理中的高级应用技巧

    Java正则表达式在文本处理中的高级应用技巧Java正则表达式在文本处理中的高级应用技巧Java正则表达式在文本处理中的高级应用技巧Java正则表达式在文本处理中的高级应用技巧

    掌握java正则表达式的高级技巧可显著提升文本处理效率。1. 使用分组与捕获提取信息,如通过括号 () 定义组并用 group() 提取时间戳和用户id;使用 (?:…) 可避免不必要的捕获。2. 后向引用 可确保前后匹配一致,命名组 (?…) 提升代码可读性与维护性。3. …

    2026年10月7日 • 用户投稿
    600
  • Composer如何处理fork的公开仓库依赖?

    Composer如何处理fork的公开仓库依赖?Composer如何处理fork的公开仓库依赖?Composer如何处理fork的公开仓库依赖?Composer如何处理fork的公开仓库依赖?

    首先需在composer.json中配置fork仓库为VCS源,确保type为git且url指向fork地址;接着在require中引用该包并指定分支,Composer将优先从配置的源拉取代码;若要替代原包,需保证fork的composer.json包名一致,并通过版本约束使用对应分支;最后应定期同…

    2026年10月7日 • 用户投稿
    100
  • 豆包AI如何翻译长文档?多语种处理方案

    豆包ai通过分段处理的方式翻译长文档,支持超过50种语言,并通过多层校验和后处理机制确保翻译质量和一致性。面对长文档翻译的挑战,豆包ai主要通过分段处理提高准确性和上下文一致性,支持的语言包括英语、汉语、日语等,确保翻译质量通过初步翻译、神经网络优化和人工智能校对,挑战包括保持长距离语境一致性、处理…

    2026年10月7日
    200
  • 《碧蓝幻想Versus Rising》Ver2.20版本更新于8月5日上线

    《碧蓝幻想Versus Rising》Ver2.20版本更新于8月5日上线《碧蓝幻想Versus Rising》Ver2.20版本更新于8月5日上线《碧蓝幻想Versus Rising》Ver2.20版本更新于8月5日上线《碧蓝幻想Versus Rising》Ver2.20版本更新于8月5日上线

    游戏策划·开发·运营为主营业务的 Cygames, Inc.(以下简称 Cygames)现已公开《Granblue FantasyVersus: Rising》(以下简称 GBVSR)的 Ver 2.20 版本更新于 8 月 5 日(周二)上线的消息。该作是由Cygames 发起,由 ARC SYS…

    2026年10月7日 • 用户投稿
    200
  • 《四海兄弟:故乡》PS5预载今日开启!大小容量曝光!

    《四海兄弟:故乡》PS5预载今日开启!大小容量曝光!《四海兄弟:故乡》PS5预载今日开启!大小容量曝光!《四海兄弟:故乡》PS5预载今日开启!大小容量曝光!《四海兄弟:故乡》PS5预载今日开启!大小容量曝光!

    《四海兄弟》系列全新力作《四海兄弟:故乡》即将于8月8日震撼上线,带你深入有组织犯罪的黑暗源头,亲身经历一段发生在1900年代西西里岛的血腥帮派传奇。这款沉浸式第三人称动作冒险游戏将让你化身主角恩佐·法瓦拉,在一个充满危险与背叛的时代中为生存而战,竭尽全力赢得家族的认可与尊重。 根据XboxEra与…

    2026年10月7日 • 用户投稿
    100
  • Elasticsearch全文检索详细配置与使用指南

    Elasticsearch全文检索详细配置与使用指南Elasticsearch全文检索详细配置与使用指南Elasticsearch全文检索详细配置与使用指南Elasticsearch全文检索详细配置与使用指南

    elasticsearch全文检索的核心配置主要包括分词器和映射。1. 分词器决定了文本如何被切分为词项,中文场景下常用ik analyzer的ik_smart(粗粒度)和ik_max_word(细粒度),索引时用ik_smart可节省空间,搜索时用ik_max_word可提高召回率;2. 映射定义…

    2026年10月7日 • 用户投稿
    200
  • 工信部等发布重大行动方案,加强高性能 AI 服务器等技术攻关力度

    工信部等发布重大行动方案,加强高性能 AI 服务器等技术攻关力度工信部等发布重大行动方案,加强高性能 AI 服务器等技术攻关力度工信部等发布重大行动方案,加强高性能 AI 服务器等技术攻关力度工信部等发布重大行动方案,加强高性能 AI 服务器等技术攻关力度

    9月4日,工业和信息化部与国家市场监督管理总局联合印发《电子信息制造业2025-2026年稳增长行动方案》(以下简称《行动方案》)。 《行动方案》明确指出,将加大在CPU、高性能人工智能服务器以及软硬件协同等关键领域的技术攻关投入,致力于提升整体计算能力,优化系统架构设计,为人工智能技术的广泛应用提…

    2026年10月7日 • 用户投稿
    100
  • 笔灵ai写出来的小说生硬吗

    笔灵ai写出来的小说生硬吗笔灵ai写出来的小说生硬吗笔灵ai写出来的小说生硬吗笔灵ai写出来的小说生硬吗

    笔灵ai生成的小说可能生硬,具体取决于训练数据质量、算法复杂性和上下文处理能力。1.训练数据质量高则生成小说流畅,反之则生硬。2.ai在处理复杂情节和情感时可能表现机械。3.使用ai生成初稿后需人工修改润色,以提高质量和注入个人风格。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量…

    2026年10月7日 • 用户投稿
    100
  • 硅心科技(aiXcoder)发布领域化程序分析平台

    硅心科技(aiXcoder)发布领域化程序分析平台硅心科技(aiXcoder)发布领域化程序分析平台硅心科技(aiXcoder)发布领域化程序分析平台硅心科技(aiXcoder)发布领域化程序分析平台

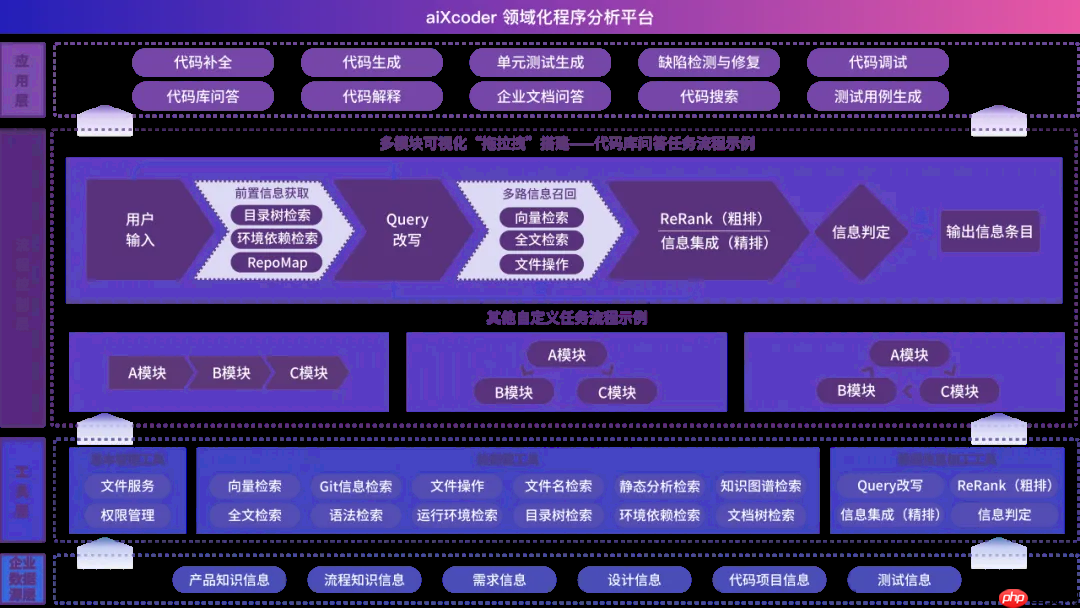
    aiXcoder领域化程序分析平台整体架构 硅心科技(aiXcoder)近日发布全新领域化程序分析平台,致力于通过上下文工程技术弥补大模型在企业级软件开发中领域知识不足的短板。该平台能够融合企业内部的代码库、设计文档、API接口规范等多样化数据源,借助动态化工作流机制,为AI模型提供高精度的上下文支…

    2026年10月7日 • 用户投稿
    100
  • 中国50万以上纯电车销量排名:理想MEGA拿下第二名

    近日,有机构公布了%ignore_a_1%1-7月起售价50万以上纯电车型销量排名: 第一名,小米SU7 Ultra,指导价格52.99万-62.99万,销量12618辆 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 第二名,理想MEGA,…

    2026年10月7日
    200
  • II-Agent— Intelligent Internet开源的通用AI Agent框架

    II-Agent— Intelligent Internet开源的通用AI Agent框架II-Agent— Intelligent Internet开源的通用AI Agent框架II-Agent— Intelligent Internet开源的通用AI Agent框架II-Agent— Intelligent Internet开源的通用AI Agent框架

    II-Agent是什么 ii-agent 是开源的agent框架,通过与大型语言模型(llm)的交互,简化和提升跨多个领域的工作流程。具备多种核心功能,包括研究与事实核查、内容生成、数据分析与可视化、软件开发、工作流自动化以及问题解决等。ii-agent 采用核心智能体架构与 llm 交互,能动态调…

    2026年10月7日 • 用户投稿
    200
  • 游戏和AI两手抓!开学装机必备华硕5060显卡

    游戏和AI两手抓!开学装机必备华硕5060显卡游戏和AI两手抓!开学装机必备华硕5060显卡游戏和AI两手抓!开学装机必备华硕5060显卡游戏和AI两手抓!开学装机必备华硕5060显卡

    对于即将迎来开学季的同学们而言,如何挑选一款性能全面的显卡成为关注焦点,尤其是计算机、设计、动画等创意类专业的学生,更需要一张高性能显卡来支撑学习与创作需求。一张强大的显卡不仅能助力专业软件流畅运行,还能搭建高效的深度学习环境,实现快速验算与模型优化! 华硕GeForce RTX5060系列显卡搭载…

    2026年10月7日 • 用户投稿
    100
  • Java游戏开发:多对象交互与碰撞检测的中央管理策略

    Java游戏开发:多对象交互与碰撞检测的中央管理策略Java游戏开发:多对象交互与碰撞检测的中央管理策略Java游戏开发:多对象交互与碰撞检测的中央管理策略Java游戏开发:多对象交互与碰撞检测的中央管理策略

    在Java游戏开发中,实现不同对象(如玩家与球体)间的交互与碰撞检测,关键在于避免创建独立的、非实际的对象实例进行判断。正确的做法是将碰撞检测的职责赋予一个中央管理类(如Game类),该类持有所有实际游戏对象的引用,并在其更新循环中协调它们的位置信息,从而高效准确地执行碰撞检测,确保游戏逻辑的正确性…

    2026年10月7日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信