mysql视频教程栏目介绍查询语句的操作
相关免费学习推荐:mysql视频教程
一.查询语句的基本操作
1.查询语句的基本操作 - select - from - where:约束条件 - group by:分组 - having:过滤 - distinct:去重 - order by:排序 - limit:限制查询记录的数量 - 聚合函数: count(计数) max(最大值) min(最小值) avg(平均值) sum(求和)
二.单表查询
1、前期表与数据准备
# 创建一张部门表create table emp( id int not null unique auto_increment, name varchar(20) not null, sex enum('male','female') not null default 'male', #大部分是男的 age int(3) unsigned not null default 28, hire_date date not null, post varchar(50), post_comment varchar(100), salary double(15,2), office int, # 一个部门一个屋子 depart_id int);# 插入记录# 三个部门:教学,销售,运营insert into emp(name,sex,age,hire_date,post,salary,office,depart_id) values('tank','male',17,'20170301','张江第一帅形象代言部门',7300.33,401,1), # 以下是教学部('egon','male',78,'20150302','teacher',1000000.31,401,1),('kevin','male',81,'20130305','teacher',8300,401,1),('jason','male',73,'20140701','teacher',3500,401,1),('owen','male',28,'20121101','teacher',2100,401,1),('jerry','female',18,'20110211','teacher',9000,401,1),('大饼','male',18,'19000301','teacher',30000,401,1),('sean','male',48,'20101111','teacher',10000,401,1),('歪歪','female',48,'20150311','sale',3000.13,402,2),# 以下是销售部门('丫丫','female',38,'20101101','sale',2000.35,402,2),('丁丁','female',18,'20110312','sale',1000.37,402,2),('星星','female',18,'20160513','sale',3000.29,402,2),('格格','female',28,'20170127','sale',4000.33,402,2),('张野','male',28,'20160311','operation',10000.13,403,3), # 以下是运营部门('程咬金','male',18,'19970312','operation',20000,403,3),('程咬银','female',18,'20130311','operation',19000,403,3),('程咬铜','male',18,'20150411','operation',18000,403,3),('程咬铁','female',18,'20140512','operation',17000,403,3);# PS:如果在windows系统中,插入中文字符,select的结果为空白,可以将所有字符编码统一设置成gbk- select * from emp; # 若数据比较多,比较凌乱,可以在表后面+ G- select * from empG
- select * from emp; # 若数据比较多,比较凌乱,可以在表后面+ G - select * from empG
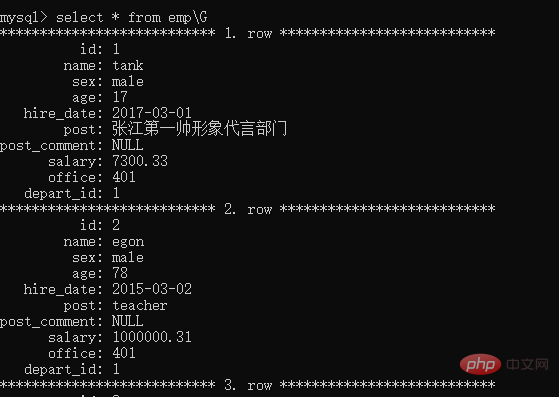
重点:
写SQL语句必须遵循两点: - 书写顺序:# 获取id为 4、5的两条记录select * from emp where id > 3 and id 3 and id 找到图书馆 - where ---> 找到书的位置 - select ---> 找到书本中的某一页 注意: 必须记住SQL语句的 书写顺序 与 执行顺序(*******);
1.where(约束条件)
# PS: 根据执行顺序来书写 SQL语句,一步一步来写;# 1.查询id大于等于3小于等于6的数据(and:与)select * from emp where id >= 3 and id SELECT * FROM EMP WHERE ID > 3 AND ID select * from emp where id between 3 and 6;+----+-------+--------+-----+------------+---------+--------------+---------+--------+-----------+| id | name | sex | age | hire_date | post | post_comment | salary | office | depart_id |+----+-------+--------+-----+------------+---------+--------------+---------+--------+-----------+| 3 | kevin | male | 81 | 2013-03-05 | teacher | NULL | 8300.00 | 401 | 1 || 4 | jason | male | 73 | 2014-07-01 | teacher | NULL | 3500.00 | 401 | 1 || 5 | owen | male | 28 | 2012-11-01 | teacher | NULL | 2100.00 | 401 | 1 || 6 | jerry | female | 18 | 2011-02-11 | teacher | NULL | 9000.00 | 401 | 1 |+----+-------+--------+-----+------------+---------+--------------+---------+--------+-----------+4 rows in set (0.00 sec)# 2.查询薪资是20000或者18000或者17000的数据# or: 或者select * from emp where salary=20000 or salary=18000 or salary=17000;# in: 在什么里select * from emp where salary in (20000, 18000, 17000);mysql> select * from emp where salary = 20000 or salary = 18000 or salary = 17000;+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+| id | name | sex | age | hire_date | post | post_comment | salary | office | depart_id |+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+| 15 | 程咬金 | male | 18 | 1997-03-12 | operation | NULL | 20000.00 | 403 | 3 || 17 | 程咬铜 | male | 18 | 2015-04-11 | operation | NULL | 18000.00 | 403 | 3 || 18 | 程咬铁 | female | 18 | 2014-05-12 | operation | NULL | 17000.00 | 403 | 3 |+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+3 rows in set (0.00 sec)# 也可以使用in(3,4,5,6) select * from emp where id in(3,4,5,6);+----+-------+--------+-----+------------+---------+--------------+---------+--------+-----------+| id | name | sex | age | hire_date | post | post_comment | salary | office | depart_id |+----+-------+--------+-----+------------+---------+--------------+---------+--------+-----------+| 3 | kevin | male | 81 | 2013-03-05 | teacher | NULL | 8300.00 | 401 | 1 || 4 | jason | male | 73 | 2014-07-01 | teacher | NULL | 3500.00 | 401 | 1 || 5 | owen | male | 28 | 2012-11-01 | teacher | NULL | 2100.00 | 401 | 1 || 6 | jerry | female | 18 | 2011-02-11 | teacher | NULL | 9000.00 | 401 | 1 |+----+-------+--------+-----+------------+---------+--------------+---------+--------+-----------+4 rows in set (0.00 sec)# 3.查询员工姓名中包含o字母 的 员工姓名和薪资# like: 模糊匹配# %: 匹配0个或多个任意字符(若前后都有%(%o%),查所有带有索引字符的记录,若头有%而尾没有(%o),则查所有尾带有索引字符的记录,若尾有%而头没有(o%),则查所有头带有索引字符的记录,若前后都没有%(o),则只会查询只有索引字符的字符)# _: 匹配一个任意字符select name, salary from emp where name like "%o%";+-------+------------+| name | salary |+-------+------------+| egon | 1000000.31 || jason | 3500.00 || owen | 2100.00 |+-------+------------+3 rows in set (0.00 sec)mysql> select name, salary from emp where name like "o";+------+--------+| name | salary |+------+--------+| o | NULL |+------+--------+1 row in set (0.00 sec)# 4.查找名字个数为3个的员工 名字 与 薪资select name, salary from emp where name like "___";+-----------+----------+| name | salary |+-----------+----------+| 程咬金 | 20000.00 || 程咬银 | 19000.00 || 程咬铜 | 18000.00 || 程咬铁 | 17000.00 |+-----------+----------+4 rows in set (0.00 sec)# 或者 # char_length(name): 计算名字字符的长度select name, salary from emp where char_length(name) = 4; mysql> select name, salary from emp where char_length(name) = 3;+-----------+----------+| name | salary |+-----------+----------+| 程咬金 | 20000.00 || 程咬银 | 19000.00 || 程咬铜 | 18000.00 || 程咬铁 | 17000.00 |+-----------+----------+4 rows in set (0.00 sec)# 5.查询id小于3或者大于6的数据# not in: 不再什么什么中select * from emp where id not in (3, 4, 5, 6);select * from emp where id not between 3 and 6;# 6.查询薪资不在20000,18000,17000范围的数据select * from emp where salary not in (20000, 18000, 17000); # 7.查询岗位描述为空的 员工名 与 岗位名 post_comment# 用等于号无法判定空字段select name, post from emp where post_comment = null;select * from emp where post_comment = null;Empty set (0.00 sec)# 注意: 针对null的值 需要使用 isselect name, post from emp where post_comment is null;select name, post_comment from emp where post_comment is null;+-----------+--------------+| name | post_comment |+-----------+--------------+| tank | NULL || egon | NULL || kevin | NULL || jason | NULL || owen | NULL || jerry | NULL || 大饼 | NULL || sean | NULL || 歪歪 | NULL || 丫丫 | NULL || 丁丁 | NULL || 星星 | NULL || 格格 | NULL || 张野 | NULL || 程咬金 | NULL || 程咬银 | NULL || 程咬铜 | NULL || 程咬铁 | NULL || o | NULL |+-----------+--------------+19 rows in set (0.00 sec)
2.group by(分组)
- 书写顺序: - select - from - where - group by - 执行顺序: - from - where - group by - select# 什么叫分组 # 比如: 一张员工表中有性别字段,可以根据性别分组,一组是男性,一组是女性,或者是根据部门分组,有教学部、销售部等... # 1.根据部门分组 # 非严格模式下可以获取 分组条件post 以外的字段数据select post, salary from emp group by post;# 设置严格模式:show variables like "%mode%";# 全局设置: 永久有效set global sql_mode="strict_trans_tables,only_full_group_by";"""设置sql_mode为only_full_group_by,意味着以后但凡分组,只能取到分组的依据,不应该在去取组里面的单个元素的值,那样的话分组就没有意义了,并且会报错,因为不分组就是对单个元素信息的随意获取"""mysql> select post, salary from emp group by post;ERROR 1046 (3D000): No database selected # 可以同聚合函数,间接获取其他字段数据 聚合函数: count: 计数 max: 最大值 min: 最小值 avg: 平均值 sum: 求和 group_concat(name): 可以将分组后的 所有名字获取并进行拼接 # 指定以:拼接select post, group_concat(name) from emp group by post;select post, group_concat(name, ':') from emp group by post; 2.获取每个 部门 的最高工资 select post,max(salary) from emp group by post;mysql> select post,max(salary) from emp group by post;+-----------------------------------+-------------+| post | max(salary) |+-----------------------------------+-------------+| NULL | NULL || operation | 20000.00 || sale | 4000.33 || teacher | 1000000.31 || 张江第一帅形象代言部门 | 7300.33 |+-----------------------------------+-------------+5 rows in set (0.00 sec)补充: as 别名: 可以给字段 加一个 别名select post as '部门', max(salary) as '薪资'from emp group by post;# 也可以简写,但是不推荐select post '部门', max(salary) '薪资'from emp group by post;mysql> select post as '部门', max(salary) as'薪资' -> from emp group by post;+-----------------------------------+------------+| 部门 | 薪资 |+-----------------------------------+------------+| NULL | NULL || operation | 20000.00 || sale | 4000.33 || teacher | 1000000.31 || 张江第一帅形象代言部门 | 7300.33 |+-----------------------------------+------------+5 rows in set (0.00 sec)3.每个部门的最低工资select post, min(salary) from emp group by post;4.每个部门的平均工资select post, avg(salary) from emp group by post;5.每个部门的工资总和select post, sum(salary) from emp group by post;6.每个部门的员工个数# count(): 括号中可以填任意非空值select post, count(salary) from emp group by post;select post, count(post_comment) from emp group by post;查询岗位名以及各岗位内包含的员工个数select post, count(id) from emp group by post;查询公司内男员工和女员工的个数select sex, count(*) from emp group by sex;查询男员工与男员工的平均薪资,女员工与女员工的平均薪资select sex, avg(salary) from emp group by sex;.统计各部门年龄在30岁以上的员工平均工资:# 步骤: 先找到表,再找年龄30岁以上,再根据部门分组,最后求平均薪资;select post, avg(salary) from emp where age > 30 group by post;
总结: 聚合函数,必须跟在group by 后面(执行顺序);
# 聚合函数: 若没有group by 分组,默认将查出来的数据当做一个分组, 也能使用;select max(salary) from emp;
# group_concat(name): 可以将分组后的 所有名字获取并进行拼接 # 默认以, 拼接select post, group_concat(name) from emp group by post; # 指定以:拼接select post, group_concat(name, ':') from emp group by post;# select post, group_concat('Name: ', name) from emp group by post;select post, group_coucat(name) from emp group by post;mysql> select post, group_concat(name) from emp group by post;+-----------------------------------+------------------------------------------------+| post | group_concat(name) |+-----------------------------------+------------------------------------------------+| NULL | o || operation | 程咬铁,程咬铜,程咬银,程咬金,张野 || sale | 格格,星星,丁丁,丫丫,歪歪 || teacher | sean,大饼,jerry,owen,jason,kevin,egon || 张江第一帅形象代言部门 | tank |+-----------------------------------+------------------------------------------------+5 rows in set (0.00 sec)# 给每个部门的员工名字前 + NB_select post, group_concat('NB_', name) from emp group by post;# 拼接部门员工名字+薪资select post, group_concat(name, ":", salary) from emp group by post;
补充:concat
# 4.补充concat(不分组时用)拼接字符串达到更好的显示效果 as语法并用select concat('Name: ', name) as '名字', concat('Sal: ', salary) as '薪资' from emp;mysql> select concat('name: ', name) as '名字',concat('sal: ',salary) as '薪资' from emp;+-----------------+-----------------+| 名字 | 薪资 |+-----------------+-----------------+| name: tank | sal: 7300.33 || name: egon | sal: 1000000.31 || name: kevin | sal: 8300.00 || name: jason | sal: 3500.00 || name: owen | sal: 2100.00 || name: jerry | sal: 9000.00 || name: 大饼 | sal: 30000.00 || name: sean | sal: 10000.00 || name: 歪歪 | sal: 3000.13 || name: 丫丫 | sal: 2000.35 || name: 丁丁 | sal: 1000.37 || name: 星星 | sal: 3000.29 || name: 格格 | sal: 4000.33 || name: 张野 | sal: 10000.13 || name: 程咬金 | sal: 20000.00 || name: 程咬银 | sal: 19000.00 || name: 程咬铜 | sal: 18000.00 || name: 程咬铁 | sal: 17000.00 || name: o | NULL |+-----------------+-----------------+19 rows in set (0.00 sec)
3.having(过滤)
1.having与where语法一样,只不过having必需要在group by后使用;2.where 不能使用聚合函数,但having可以; - 书写顺序: - select - from - where - group by - having - 执行顺序: - from - where - group by - having - select 1、统计各 部门 年龄在30岁以上的员工平均工资,并且保留平均工资大于10000的部门;select post, avg(salary) from emp where age > 30 group by post having avg(salary) > 10000;mysql> select post, avg(salary) from emp where age > 30 group by post having avg(salary) > 10000;+---------+---------------+| post | avg(salary) |+---------+---------------+| teacher | 255450.077500 |+---------+---------------+1 row in set (0.00 sec)
4.distinct(去重)
# distinct: 去重- 书写顺序: - select - distinct - from - where - group by - having执行顺序:- from- where - group by - having- select - distinct # 注意: 查询的字段值必须是重复的才有效,只要有一个字段值是不重复的就没有效果。# 若所查字段内有不重复的字段记录就不会去重select distinct id, post from emp;mysql> select distinct id, post from emp;+----+-----------------------------------+| id | post |+----+-----------------------------------+| 1 | 张江第一帅形象代言部门 || 2 | teacher || 3 | teacher || 4 | teacher || 5 | teacher || 6 | teacher || 7 | teacher || 8 | teacher || 9 | sale || 10 | sale || 11 | sale || 12 | sale || 13 | sale || 14 | operation || 15 | operation || 16 | operation || 17 | operation || 18 | operation || 19 | NULL |+----+-----------------------------------+19 rows in set (0.00 sec)select distinct post from emp;mysql> select distinct post from emp;+-----------------------------------+| post |+-----------------------------------+| 张江第一帅形象代言部门 || teacher || sale || operation || NULL |+-----------------------------------+5 rows in set (0.00 sec)
5.order by(排序)
- 书写顺序: - select - from - where - group by - having - order by执行顺序:- from- where - group by - having - select - order by # 通过select 查出来的数据再进行排序 # order by 默认升序# asc升序# desc降序# 1、根据薪资进行升序select name, salary from emp order by salary; # 默认升序mysql> select name, salary from emp order by salary;+-----------+------------+| name | salary |+-----------+------------+| o | NULL || 丁丁 | 1000.37 || 丫丫 | 2000.35 || owen | 2100.00 || 歪歪 | 3000.13 || 星星 | 3000.29 || jason | 3500.00 || 格格 | 4000.33 || tank | 7300.33 || kevin | 8300.00 || jerry | 9000.00 || sean | 10000.00 || 张野 | 10000.13 || 程咬铁 | 17000.00 || 程咬铜 | 18000.00 || 程咬银 | 19000.00 || 程咬金 | 20000.00 || 大饼 | 30000.00 || egon | 1000000.31 |+-----------+------------+19 rows in set (0.00 sec)2.select * from emp order by salary asc; # 指定升序3.select name, salary from emp order by salary desc; # 指定降序 mysql> select name, salary from emp order by salary desc;+-----------+------------+| name | salary |+-----------+------------+| egon | 1000000.31 || 大饼 | 30000.00 || 程咬金 | 20000.00 || 程咬银 | 19000.00 || 程咬铜 | 18000.00 || 程咬铁 | 17000.00 || 张野 | 10000.13 || sean | 10000.00 || jerry | 9000.00 || kevin | 8300.00 || tank | 7300.33 || 格格 | 4000.33 || jason | 3500.00 || 星星 | 3000.29 || 歪歪 | 3000.13 || owen | 2100.00 || 丫丫 | 2000.35 || 丁丁 | 1000.37 || o | NULL |+-----------+------------+19 rows in set (0.00 sec)# 先按照age升序,再按照salary降序select age, salary from emp order by age asc, salary desc;# 统计 各部门(分组) 年龄在10岁以上的员工平均工资,并且保留平均工资大于1000的部门,然后对平均工资进行升序序select post, avg(salary) from emp where age > 10 group by post having avg(salary) > 1000 order by avg(salary);
9.limit(限制查询记录的数量)
书写顺序: - select - from - order by - limit 执行顺序: - from - select - order by - limit # 1、从第一条开始,获取4条记录;select * from emp limit 4;mysql> select * from emp limit 4;+----+-------+------+-----+------------+-----------------------------------+--------------+------------+--------+-----------+| id | name | sex | age | hire_date | post | post_comment | salary | office | depart_id |+----+-------+------+-----+------------+-----------------------------------+--------------+------------+--------+-----------+| 1 | tank | male | 17 | 2017-03-01 | 张江第一帅形象代言部门 | NULL | 7300.33 | 401 | 1 || 2 | egon | male | 78 | 2015-03-02 | teacher | NULL | 1000000.31 | 401 | 1 || 3 | kevin | male | 81 | 2013-03-05 | teacher | NULL | 8300.00 | 401 | 1 || 4 | jason | male | 73 | 2014-07-01 | teacher | NULL | 3500.00 | 401 | 1 |+----+-------+------+-----+------------+-----------------------------------+--------------+------------+--------+-----------+4 rows in set (0.00 sec)# 2、limit可以有两个参数, 参数1:是限制的开始位置, 参数2:是从开始位置展示的条数;select * from emp limit 0, 4;select * from emp limit 4, 4;mysql> select * from emp limit 4, 4;+----+--------+--------+-----+------------+---------+--------------+----------+--------+-----------+| id | name | sex | age | hire_date | post | post_comment | salary | office | depart_id |+----+--------+--------+-----+------------+---------+--------------+----------+--------+-----------+| 5 | owen | male | 28 | 2012-11-01 | teacher | NULL | 2100.00 | 401 | 1 || 6 | jerry | female | 18 | 2011-02-11 | teacher | NULL | 9000.00 | 401 | 1 || 7 | 大饼 | male | 18 | 1900-03-01 | teacher | NULL | 30000.00 | 401 | 1 || 8 | sean | male | 48 | 2010-11-11 | teacher | NULL | 10000.00 | 401 | 1 |+----+--------+--------+-----+------------+---------+--------------+----------+--------+-----------+4 rows in set (0.00 sec)# 3、查询工资最高的人的详细信息select * from emp order by salary limit 1;mysql> select * from emp order by salary limit 1;+----+------+------+-----+------------+------+--------------+--------+--------+-----------+| id | name | sex | age | hire_date | post | post_comment | salary | office | depart_id |+----+------+------+-----+------------+------+--------------+--------+--------+-----------+| 19 | o | male | 28 | 0000-00-00 | NULL | NULL | NULL | NULL | NULL |+----+------+------+-----+------------+------+--------------+--------+--------+-----------+1 row in set (0.00 sec)
10.正则
# 在编程中,凡是看到reg开头的,基本上都是跟正则有关 # *: 代表 0 或 多个select * from emp where name regexp '^程.*(金|银|铜|铁)$';mysql> select * from emp where name regexp '^程.*(金|银|铜|铁)$';+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+| id | name | sex | age | hire_date | post | post_comment | salary | office | depart_id |+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+| 15 | 程咬金 | male | 18 | 1997-03-12 | operation | NULL | 20000.00 | 403 | 3 || 16 | 程咬银 | female | 18 | 2013-03-11 | operation | NULL | 19000.00 | 403 | 3 || 17 | 程咬铜 | male | 18 | 2015-04-11 | operation | NULL | 18000.00 | 403 | 3 || 18 | 程咬铁 | female | 18 | 2014-05-12 | operation | NULL | 17000.00 | 403 | 3 |+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+4 rows in set (0.00 sec)
三.多表查询
多表查询
 德语写作助手
德语助手旗下的AI智能写作平台,支持对德语文本进行语法词汇纠错、润色、扩写等AI功能。
 0 查看详情

-关联查询
-子查询
创建表与插入数据准备
#建表create table dep2(id int,name varchar(20) );create table emp2(id int primary key auto_increment,name varchar(20),sex enum('male','female') not null default 'male',age int,dep_id int);#插入数据insert into dep2 values(200,'技术'),(201,'人力资源'),(202,'销售'),(203,'运营');insert into emp2(name,sex,age,dep_id) values('tank','male',17,200),('egon','female',48,201),('kevin','male',38,201),('jason','female',28,202),('owen','male',18,200),('sean','female',18,204);mysql> select * from dep2;+------+--------------+| id | name |+------+--------------+| 200 | 技术 || 201 | 人力资源 || 202 | 销售 || 203 | 运营 |+------+--------------+4 rows in set (0.00 sec)mysql> select * from emp2;+----+-------+--------+------+--------+| id | name | sex | age | dep_id |+----+-------+--------+------+--------+| 1 | tank | male | 17 | 200 || 2 | egon | female | 48 | 201 || 3 | kevin | male | 38 | 201 || 4 | jason | female | 28 | 202 || 5 | owen | male | 18 | 200 || 6 | sean | female | 18 | 204 |+----+-------+--------+------+--------+# 指到了如何根据表关系对字段进行拆分,目的是为了更好的管理,表数据都存放在硬盘中,存不是目的,目的是为了取,所以我们将数据从硬盘读到内存中,接下来我们因应该将他们拼成一张表来查询更加合理;# 注意: 将拆分的表,再拼接到一起进行查询, 可以通过一张表查另一张表的数据;
1.关联查询
# 左表的一条记录与右表的一条记录都对应一遍称之为 --> "笛卡尔积" PS: 百度科普# 将所有的数据都对应了一遍,虽然不合理但是其中有合理的数据,现在我们需要做的就是找出合理的数据
举例:通过之前准备的数据进行多表操作 1、查询 员工 以及所在 部门 的信息;# 通过where 约束条件select * from emp2, dep2 where emp2.dep_id = dep2.id;2、查询 部门 为 技术部 的 员工 及 部门信息select * from emp2, dep2 where emp2.dep_id = dep2.id and dep2.name = '技术';
联表查询: -内链接:只去两张表有对应关系的记录select * from emp2 inner join dep2 on emp2.dep_id = dep2.id;mysql> select * from emp2 inner join dep2 on emp2.dep_id = dep2.id;+----+-------+--------+------+--------+------+--------------+| id | name | sex | age | dep_id | id | name |+----+-------+--------+------+--------+------+--------------+| 1 | tank | male | 17 | 200 | 200 | 技术 || 2 | egon | female | 48 | 201 | 201 | 人力资源 || 3 | kevin | male | 38 | 201 | 201 | 人力资源 || 4 | jason | female | 28 | 202 | 202 | 销售 || 5 | owen | male | 18 | 200 | 200 | 技术 |+----+-------+--------+------+--------+------+--------------+5 rows in set (0.05 sec)2、left join# 2、左连接: 在内连接的基础上保留左表没有对应关系的记录(以null补全)select * from emp2 left join dep2 on emp2.dep_id = dep2.id;mysql> select * from emp2 left join dep2 on emp2.dep_id = dep2.id;+----+-------+--------+------+--------+------+--------------+| id | name | sex | age | dep_id | id | name |+----+-------+--------+------+--------+------+--------------+| 1 | tank | male | 17 | 200 | 200 | 技术 || 5 | owen | male | 18 | 200 | 200 | 技术 || 2 | egon | female | 48 | 201 | 201 | 人力资源 || 3 | kevin | male | 38 | 201 | 201 | 人力资源 || 4 | jason | female | 28 | 202 | 202 | 销售 || 6 | sean | female | 18 | 204 | NULL | NULL |+----+-------+--------+------+--------+------+--------------+ # 3、右连接: 在内连接的基础上保留右表没有对应关系的记录select * from emp2 right join dep2 on emp2.dep_id = dep2.id;mysql> select * from emp2 right join dep2 on emp2.dep_id = dep2.id;+------+-------+--------+------+--------+------+--------------+| id | name | sex | age | dep_id | id | name |+------+-------+--------+------+--------+------+--------------+| 1 | tank | male | 17 | 200 | 200 | 技术 || 2 | egon | female | 48 | 201 | 201 | 人力资源 || 3 | kevin | male | 38 | 201 | 201 | 人力资源 || 4 | jason | female | 28 | 202 | 202 | 销售 || 5 | owen | male | 18 | 200 | 200 | 技术 || NULL | NULL | NULL | NULL | NULL | 203 | 运营 |+------+-------+--------+------+--------+------+--------------+6 rows in set (0.00 sec)- 全连接: union# 4、全连接: 在内连接的基础上 保留左、右表没有对应关系的记录select * from emp2 left join dep2 on emp2.dep_id = dep2.id union select * from emp2 right join dep2 on emp2.dep_id = dep2.id;
2.子查询
# 子查询就是将一个查询语句的结果用括号括起来,当做另一个查询语句的条件去用# 查询部门是技术或者人力资源的员工信息'''先获取技术部和人力资源的id号,再去员工表里根据前面的id筛选出符合要求的员工信息;'''select * from emp2 where dep_id in (select id from dep2 where name='技术' or name='人力资源'); # 2.每个部门最新入职的员工 思路:先查每个部门最新入职的员工,再按部门对应上联表查询 # 查第一张emp表# 第四步select t1.id, t1.name, t1.hire_date, t2.*from# 第二步# 拼接了 t1(emp) 与 t2(各部门最新入职的员工数据虚拟表)表的数据emp as t1inner join# 第一步# 子查询获取emp表中的 部门名称与最新入职的时间字段值 生成一张虚拟表(select post, max(hire_date) as max_date from emp group by post) as t2on# 若 t1.post 的值与 t2.post 条件成立,则拼接对应的记录;t1.post = t2.post# 第三步where t1.hire_date = t2.max_date;
以上就是掌握MySQL之查询语句的基本操作的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/354438.html
 微信扫一扫
 支付宝扫一扫