本篇文章给大家带来的内容是介绍redis的持久化和主从复制机制,有一定的参考价值,有需要的朋友可以参考一下,希望对你有所帮助。
Redis持久化
Redis 提供了多种不同级别的持久化方式:
RDB 持久化可以在指定的时间间隔内生成数据集的时间点快照(point-in-time snapshot)
AOF 持久化记录服务器执行的所有写操作命令,并在服务器启动时,通过重新执行这些命令来还原数据集。 AOF 文件中的命令全部以 Redis 协议的格式来保存,新命令会被追加到文件的末尾。 Redis 还可以在后台对 AOF 文件进行重写(rewrite),使得 AOF 文件的体积不会超出保存数据集状态所需的实际大小。
Redis 还可以同时使用 AOF 持久化和 RDB 持久化。 在这种情况下, 当 Redis 重启时, 它会优先使用 AOF 文件来还原数据集, 因为 AOF 文件保存的数据集通常比 RDB 文件所保存的数据集更完整。
你甚至可以关闭持久化功能,让数据只在服务器运行时存在。
RDB(Redis DataBase)
Rdb:在指定的时间间隔内将内存中的数据集快照写入磁盘,也就是行话讲的 snapshot 快照,它恢复时就是将快照文件直接读到内存里。
Redis 会单独的创建(fork) 一个子进程来进行持久化,会先将数据写入到一个临时文件中,待持久化过程结束了,再用这个临时文件替换上次持久化还的文件。整个过程总,主进程是不进行任何 IO 操作,这就确保了极高的性能,如果需要进行大规模的数据恢复,且对于数据恢复的完整性不是非常敏感,那 RDB 方法要比 AOF 方式更加的高效。RDB 的缺点是最后一次持久化后的数据可能丢失。
Fork 的作用是复制一个与当前进程一样的进程,新进程的所有数据(变量、环境变量、程序计数器等)数值都和原进程一致,但是是一个全新的进程,并作为原进程的子进程
隐患:若当前的进程的数据量庞大,那么 fork 之后数据量*2,此时就会造成服务器压力大,运行性能降低。
Rdb 保存的是 dump.rdb 文件
在测试:执行 flushAll 命令, 使用 shutDown 直接关闭进程时,第二次打开时 redis 会自动读取 dump.rdb 文件,但是恢复时,全为空。(此时的原因:在关闭时刻,redis 系统会保存空的 dump.rdb 替换原来的缓存文件。所以第二次打开的 redis系统时候,自动读取的是空值文件)
RDB save 操作
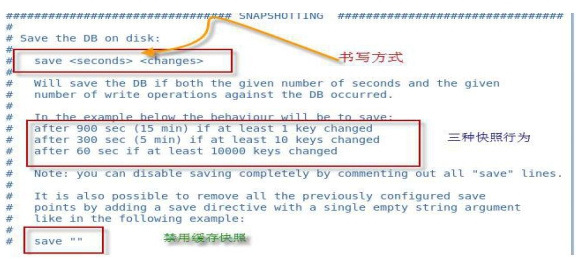
Rdb 是整个内存的压缩的 snapshot,RDB 的数据结构,可以配置符合快照触发条件,默认的是 1 分钟内改动 1 万次,或者 5 分钟改动 10 次,或者是 15 分钟改动一次;
Save 禁用:如果想禁用 RDB 持久化的策略,只要不设置任何 save 指令,或者是给 save 传入一个空字符串参数也可以。
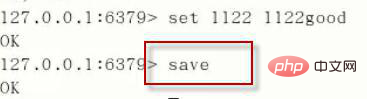
—–> save 指令:即刻保存操作对象
如何触发 RDB 快照
Save:save 时只管保存,其他不管,全部阻塞。
Bgsave:redis 会在后台进行快照操作,快照操作的同时还可以响应客户端的请求,可以通过 lastsave 命令获取最后一次成功执行快照的时间。
执行 fluhall 命令,也会产生 dump.rdb 文件,但里面是空的。
如何恢复:
将备份文件(dump.rdb)移动到 redis 安装目录并启动服务即可
Config get dir 命令可获取目录
如何停止
动态停止 RDB 保存规则的方法:redis -cli config set save “”
AOF(Append Only File)
以日志的形式俩记录每个写操作,将 redis 执行过的所有写指令记录下来(读操作不记录)。只许追加文件但不可以改写文件,redis 启动之初会读取该文件重新构建数据,换言之,redis重启的话就根据日志文件的内容将写指令从前到后执行一次一完成数据恢复工作。
======APPEND ONLY MODE=====
开启 aof :appendonly yes (默认是 no)
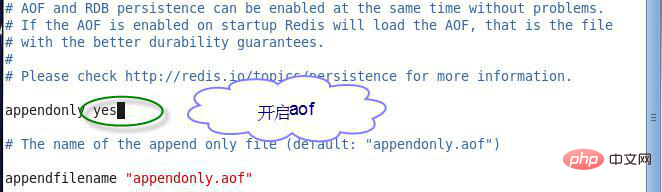
注意:
在实际工作生产的时候往往会出现:aof 文件损坏(网络传输或者其他问题导致 aof 文件破坏)
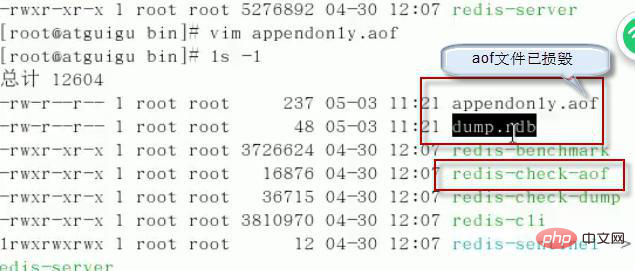
服务器启动报错(但是 dump.rdb 文件是完整的) 说明启动先加载 aof 文件
解决方案:执行命令 redis-check-aof –fix aof 文件 [自动检查删除不和 aof 语法的字段]
Aof策略
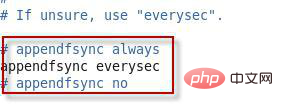
Appendfsync 参数:
Always 同步持久化 每次发生数据变更会被立即记录到磁盘,性能较差但数据完整性较好。
Everysec: 出厂默认推荐,异步操作,每秒记录,日过一秒宕机,有数据丢失
No:从不 fsync :将数据交给操作系统来处理。更快,也更不安全的选择。
Rewrite
概念:AOF 采用文件追加方式,文件会越来越来大为避免出现此种情况,新增了重写机制,aof 文件的大小超过所设定的阈值时,redis 就会自动 aof 文件的内容压缩,值保留可以恢复数据的最小指令集,可以使用命令 bgrewirteaof。
重写原理:aof 文件持续增长而大时,会 fork 出一条新进程来将文件重写(也就
是先写临时文件最后再 rename),遍历新进程的内存中的数据,每条记录有一条 set 语句,重写 aof 文件的操作,并没有读取旧的的 aof 文件,而是将整个内存的数据库内容用命令的方式重写了一个新的 aof 文件,这点和快照有点类似。
触发机制:redis 会记录上次重写的 aof 的大小,默认的配置当 aof 文件大小上次 rewrite 后大小的一倍且文件大于 64M 触发(3G)
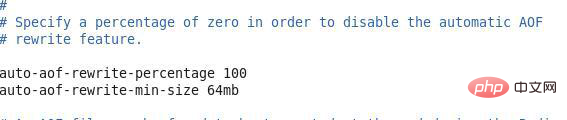
no-appendfsync-on-rewrite no : 重写时是否可以运用 Appendfsync 用默认 no 即可,保证数据安全
auto-aof-rewrite-percentage 倍数 设置基准值
auto-aof-rewrite-min-size 设置基准值大小
AOF优点
使用 AOF 持久化会让 Redis 变得非常耐久:你可以设置不同的 fsync 策略,比如无 fsync ,每秒钟一次 fsync ,或者每次执行写入命令时 fsync 。 AOF 的默认策略为每秒钟 fsync 一次,在这种配置下,Redis 仍然可以保持良好的性能,并且就算发生故障停机,也最多只会丢失一秒钟的数据( fsync 会在后台线程执行,所以主线程可以继续努力地处理命令请求)。
AOF 文件是一个只进行追加操作的日志文件(append only log), 因此对 AOF 文件的写入不需要进行 seek , 即使日志因为某些原因而包含了未写入完整的命令(比如写入时磁盘已满,写入中途停机,等等), redis-check-aof 工具也可以轻易地修复这种问题。
Redis 可以在 AOF 文件体积变得过大时,自动地在后台对 AOF 进行重写: 重写后的新 AOF 文件包含了恢复当前数据集所需的最小命令集合。 整个重写操作是绝对安全的,因为 Redis 在创建新 AOF 文件的过程中,会继续将命令追加到现有的 AOF 文件里面,即使重写过程中发生停机,现有的 AOF 文件也不会丢失。 而一旦新 AOF 文件创建完毕,Redis 就会从旧 AOF 文件切换到新 AOF 文件,并开始对新 AOF 文件进行追加操作。
AOF 文件有序地保存了对数据库执行的所有写入操作, 这些写入操作以 Redis 协议的格式保存, 因此 AOF 文件的内容非常容易被人读懂, 对文件进行分析(parse)也很轻松。 导出(export) AOF 文件也非常简单: 举个例子, 如果你不小心执行了 FLUSHALL 命令, 但只要 AOF 文件未被重写, 那么只要停止服务器, 移除 AOF 文件末尾的 FLUSHALL 命令, 并重启 Redis , 就可以将数据集恢复到 FLUSHALL 执行之前的状态。
AOF缺点
对于相同的数据集来说,AOF 文件的体积通常要大于 RDB 文件的体积。
根据所使用的 fsync 策略,AOF 的速度可能会慢于 RDB 。 在一般情况下, 每秒 fsync 的性能依然非常高, 而关闭 fsync 可以让 AOF 的速度和 RDB 一样快, 即使在高负荷之下也是如此。 不过在处理巨大的写入载入时,RDB 可以提供更有保证的最大延迟时间(latency)。
AOF 在过去曾经发生过这样的 bug : 因为个别命令的原因,导致 AOF 文件在重新载入时,无法将数据集恢复成保存时的原样。 (举个例子,阻塞命令 BRPOPLPUSH 就曾经引起过这样的 bug 。)
测试套件里为这种情况添加了测试: 它们会自动生成随机的、复杂的数据集,并通过重新载入这些数据来确保一切正常。虽然这种 bug 在 AOF 文件中并不常见, 但是对比来说, RDB 几乎是不可能出现这种 bug 的。
备份Redis 数据
一定要备份你的数据库!
 卡拉OK视频制作
,在几分钟内制作出你的卡拉OK视频
 178 查看详情

磁盘故障, 节点失效, 诸如此类的问题都可能让你的数据消失不见, 不进行备份是非常危险的。
Redis 对于数据备份是非常友好的, 因为你可以在服务器运行的时候对 RDB 文件进行复制: RDB 文件一旦被创建, 就不会进行任何修改。 当服务器要创建一个新的 RDB 文件时, 它先将文件的内容保存在一个临时文件里面, 当临时文件写入完毕时, 程序才使用 rename(2) 原子地用临时文件替换原来的 RDB 文件。
这也就是说, 无论何时, 复制 RDB 文件都是绝对安全的。
建议:
创建一个定期任务(cron job), 每小时将一个 RDB 文件备份到一个文件夹, 并且每天将一个 RDB 文件备份到另一个文件夹。
确保快照的备份都带有相应的日期和时间信息, 每次执行定期任务脚本时, 使用 find 命令来删除过期的快照: 比如说, 你可以保留最近 48 小时内的每小时快照, 还可以保留最近一两个月的每日快照。
至少每天一次, 将 RDB 备份到你的数据中心之外, 或者至少是备份到你运行 Redis 服务器的物理机器之外。
容灾备份
Redis 的容灾备份基本上就是对数据进行备份, 并将这些备份传送到多个不同的外部数据中心。
容灾备份可以在 Redis 运行并产生快照的主数据中心发生严重的问题时, 仍然让数据处于安全状态。
有的Redis 用户是创业者, 他们没有大把大把的钱可以浪费, 所以下面介绍的都是一些实用又便宜的容灾备份方法:
Amazon S3 ,以及其他类似 S3 的服务,是一个构建灾难备份系统的好地方。 最简单的方法就是将你的每小时或者每日 RDB 备份加密并传送到 S3 。 对数据的加密可以通过 gpg -c 命令来完成(对称加密模式)。 记得把你的密码放到几个不同的、安全的地方去(比如你可以把密码复制给你组织里最重要的人物)。 同时使用多个储存服务来保存数据文件,可以提升数据的安全性。
传送快照可以使用 SCP 来完成(SSH 的组件)。 以下是简单并且安全的传送方法: 买一个离你的数据中心非常远的 VPS(虚拟专用服务器) , 装上 SSH , 创建一个无口令的 SSH 客户端 key , 并将这个 key 添加到 VPS 的 authorized_keys 文件中, 这样就可以向这个 VPS 传送快照备份文件了。 为了达到最好的数据安全性,至少要从两个不同的提供商那里各购买一个 VPS 来进行数据容灾备份。
需要注意的是, 这类容灾系统如果没有小心地进行处理的话, 是很容易失效的。
最低限度下, 你应该在文件传送完毕之后, 检查所传送备份文件的体积和原始快照文件的体积是否相同。 如果你使用的是 VPS , 那么还可以通过比对文件的 SHA1 校验和来确认文件是否传送完整。
另外, 你还需要一个独立的警报系统, 让它在负责传送备份文件的传送器(transfer)失灵时通知你。
Redis主从复制
Redis 支持简单且易用的主从复制(master-slave replication)功能, 该功能可以让从服务器(slave server)成为主服务器(master server)的精确复制品。
以下是关于 Redis 复制功能的几个重要方面:
Redis 使用异步复制。 从 Redis 2.8 开始, 从服务器会以每秒一次的频率向主服务器报告复制流(replication stream)的处理进度。
一个主服务器可以有多个从服务器。
不仅主服务器可以有从服务器, 从服务器也可以有自己的从服务器, 多个从服务器之间可以构成一个图状结构。
复制功能不会阻塞主服务器: 即使有一个或多个从服务器正在进行初次同步, 主服务器也可以继续处理命令请求。
复制功能也不会阻塞从服务器: 只要在 redis.conf 文件中进行了相应的设置, 即使从服务器正在进行初次同步, 服务器也可以使用旧版本的数据集来处理命令查询。
不过, 在从服务器删除旧版本数据集并载入新版本数据集的那段时间内, 连接请求会被阻塞。
你还可以配置从服务器, 让它在与主服务器之间的连接断开时, 向客户端发送一个错误。
复制功能可以单纯地用于数据冗余(data redundancy), 也可以通过让多个从服务器处理只读命令请求来提升扩展性(scalability): 比如说, 繁重的 SORT 命令可以交给附属节点去运行。
可以通过复制功能来让主服务器免于执行持久化操作: 只要关闭主服务器的持久化功能, 然后由从服务器去执行持久化操作即可。
关闭主服务器持久化时,复制功能的数据安全。
当配置Redis复制功能时,强烈建议打开主服务器的持久化功能。 否则的话,由于延迟等问题,部署的服务应该要避免自动拉起。
案例:
假设节点A为主服务器,并且关闭了持久化。 并且节点B和节点C从节点A复制数据
节点A崩溃,然后由自动拉起服务重启了节点A. 由于节点A的持久化被关闭了,所以重启之后没有任何数据
节点B和节点C将从节点A复制数据,但是A的数据是空的, 于是就把自身保存的数据副本删除。
在关闭主服务器上的持久化,并同时开启自动拉起进程的情况下,即便使用Sentinel来实现Redis的高可用性,也是非常危险的。 因为主服务器可能拉起得非常快,以至于Sentinel在配置的心跳时间间隔内没有检测到主服务器已被重启,然后还是会执行上面的数据丢失的流程。
无论何时,数据安全都是极其重要的,所以应该禁止主服务器关闭持久化的同时自动拉起。
从服务器配置
配置一个从服务器非常简单, 只要在配置文件中增加以下的这一行就可以了:
slaveof 192.168.1.1 6379
另外一种方法是调用 SLAVEOF 命令,输入主服务器的 IP 和端口,然后同步就会开始
127.0.0.1:6379> SLAVEOF 192.168.1.1 10086
OK
只读从服务器
从 Redis 2.6 开始, 从服务器支持只读模式, 并且该模式为从服务器的默认模式。
只读模式由 redis.conf 文件中的 slave-read-only 选项控制, 也可以通过 CONFIG SET 命令来开启或关闭这个模式。
只读从服务器会拒绝执行任何写命令, 所以不会出现因为操作失误而将数据不小心写入到了从服务器的情况。
另外,对一个从属服务器执行命令 SLAVEOF NO ONE 将使得这个从属服务器关闭复制功能,并从从属服务器转变回主服务器,原来同步所得的数据集不会被丢弃。
利用『 SLAVEOF NO ONE 不会丢弃同步所得数据集』这个特性,可以在主服务器失败的时候,将从属服务器用作新的主服务器,从而实现无间断运行。
从服务器相关配置:
如果主服务器通过 requirepass 选项设置了密码, 那么为了让从服务器的同步操作可以顺利进行, 我们也必须为从服务器进行相应的身份验证设置。
对于一个正在运行的服务器, 可以使用客户端输入以下命令:
config set masterauth
要永久地设置这个密码, 那么可以将它加入到配置文件中:
masterauth
主服务器只在有至少 N 个从服务器的情况下,才执行写操作
从 Redis 2.8 开始, 为了保证数据的安全性,可以通过配置, 让主服务器只在有至少 N 个当前已连接从服务器的情况下, 才执行写命令。
不过, 因为 Redis 使用异步复制, 所以主服务器发送的写数据并不一定会被从服务器接收到, 因此, 数据丢失的可能性仍然是存在的。
以下是这个特性的运作原理:
从服务器以每秒一次的频率 PING 主服务器一次, 并报告复制流的处理情况。
主服务器会记录各个从服务器最后一次向它发送 PING 的时间。
用户可以通过配置, 指定网络延迟的最大值 min-slaves-max-lag , 以及执行写操作所需的至少从服务器数量 min-slaves-to-write 。
如果至少有 min-slaves-to-write 个从服务器, 并且这些服务器的延迟值都少于 min-slaves-max-lag 秒, 那么主服务器就会执行客户端请求的写操作。
另一方面, 如果条件达不到 min-slaves-to-write 和 min-slaves-max-lag 所指定的条件, 那么写操作就不会被执行, 主服务器会向请求执行写操作的客户端返回一个错误。
以下是这个特性的两个选项和它们所需的参数:
min-slaves-to-write min-slaves-max-lag
以上就是本篇文章的全部内容,希望能对大家的学习有所帮助。更多精彩内容大家可以关注创想鸟相关教程栏目!!!
以上就是Redis的持久化和主从复制机制介绍的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/375907.html
 微信扫一扫
 支付宝扫一扫