史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

多年来,语言模型一直是自然语言处理(NLP)技术的核心。鉴于模型背后的商业价值巨大,最先进模型的技术细节一直未公开。

现在,真·完全开源的大模型来了!

来自艾伦人工智能研究所、华盛顿大学、耶鲁大学、纽约大学和卡内基梅隆大学的研究人员,最近合作发表了一项重要的工作,这个工作将成为AI开源社区的重要里程碑。

他们几乎将从零开始训练一个大模型过程中的一切数据和资料都开源了!

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

论文:https://allenai.org/olmo/olmo-paper.pdf

权重:https://huggingface.co/allenai/OLMo-7B

代码:https://github.com/allenai/OLMo

数据:https://huggingface.co/datasets/allenai/dolma
码上飞 码上飞

码上飞(CodeFlying) 是一款AI自动化开发平台,通过自然语言描述即可自动生成完整应用程序。

码上飞 138 查看详情 码上飞

评估:https://github.com/allenai/OLMo-Eval

适配:https://github.com/allenai/open-instruct
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

具体来说,艾伦人工智能研究所推出的这个开放大语言模型(Open Language Model,OLMo)实验和训练平台,则提供了一个完全开源的大模型,以及所有和训练开发这个模型有关的数据和技术细节——

训练和建模:它包括完整的模型权重、训练代码、训练日志、消融研究、训练指标和推理代码。

预训练语料:一个包含了高达3T token的预训练开源语料库,以及产生这些训练数据的代码。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

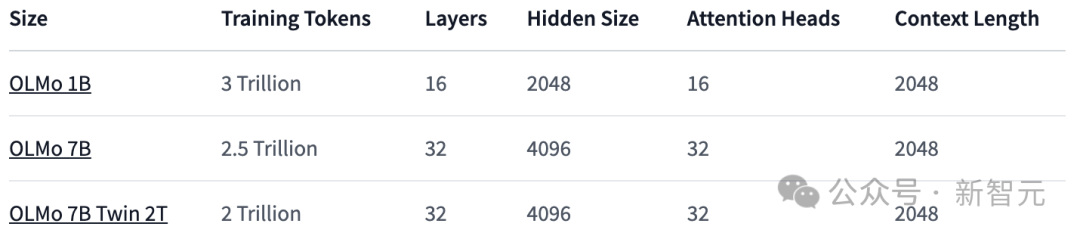
模型参数:OLMo框架提供了四个不同架构、优化器和训练硬件体系下的7B大小的模型,以及一个1B大小的模型,所有模型都在至少2T token上进行了训练。

同时,也提供了用于模型推理的代码、训练过程的各项指标以及训练日志。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

7B:OLMo 7B、OLMo 7B (not annealed)、OLMo 7B-2T、OLMo-7B-Twin-2T

评估工具:公开了开发过程中的评估工具套件,包括每个模型训练过程中每1000 step中包含的超过500个的检查点以及评估代码。

所有数据都在apache 2.0下授权使用(免费商用)。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

如此彻底的开源,似乎是给开源社区打了个样——以后不像我这样开源的,就别说自己是开源模型了。

性能评估

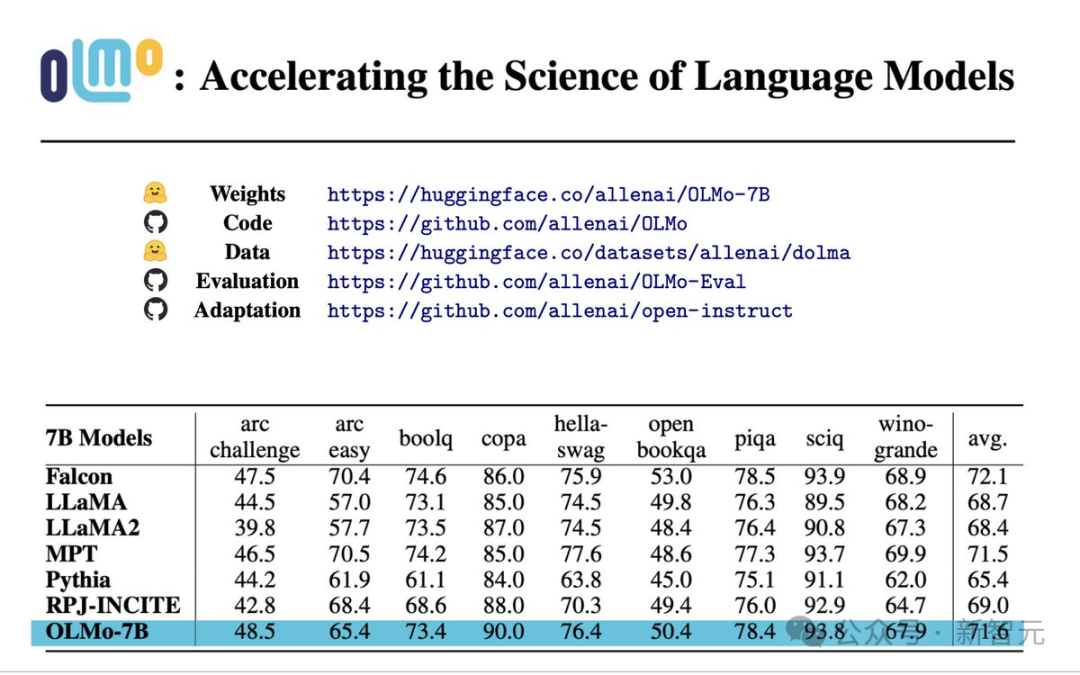
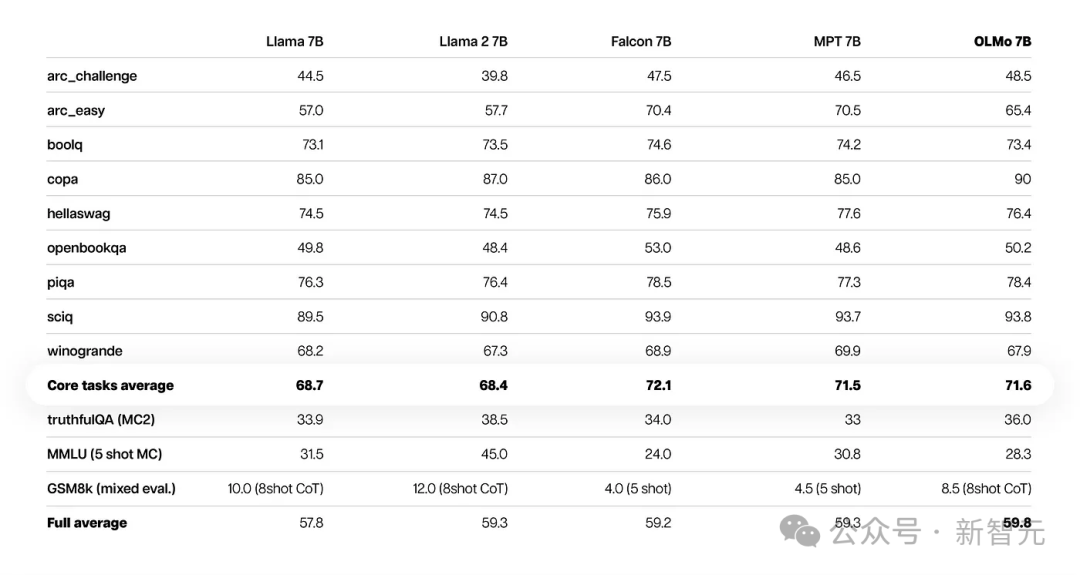
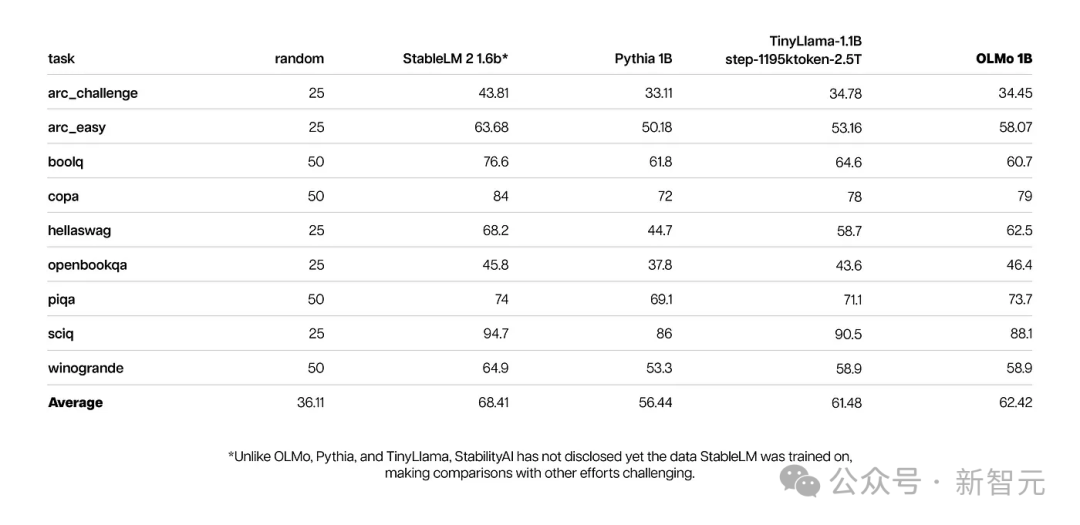
从核心的评估结果来看,OLMo-7B与同类开源模型相比略胜一筹。

在前9项评测中,OLMo-7B有8项排名前三,其中有2项超越了其他所有模型。

在很多生成任务或阅读理解任务(例如truthfulQA)上,OLMo-7B都超过了Llama 2,但在一些热门的问答任务(如MMLU或Big-bench Hard)上表现则要差一些。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

前9个任务是研究人员对预训练模型的内部评估标准,而下面三个任务则是为了完善HuggingFace Open LLM排行榜而加入的

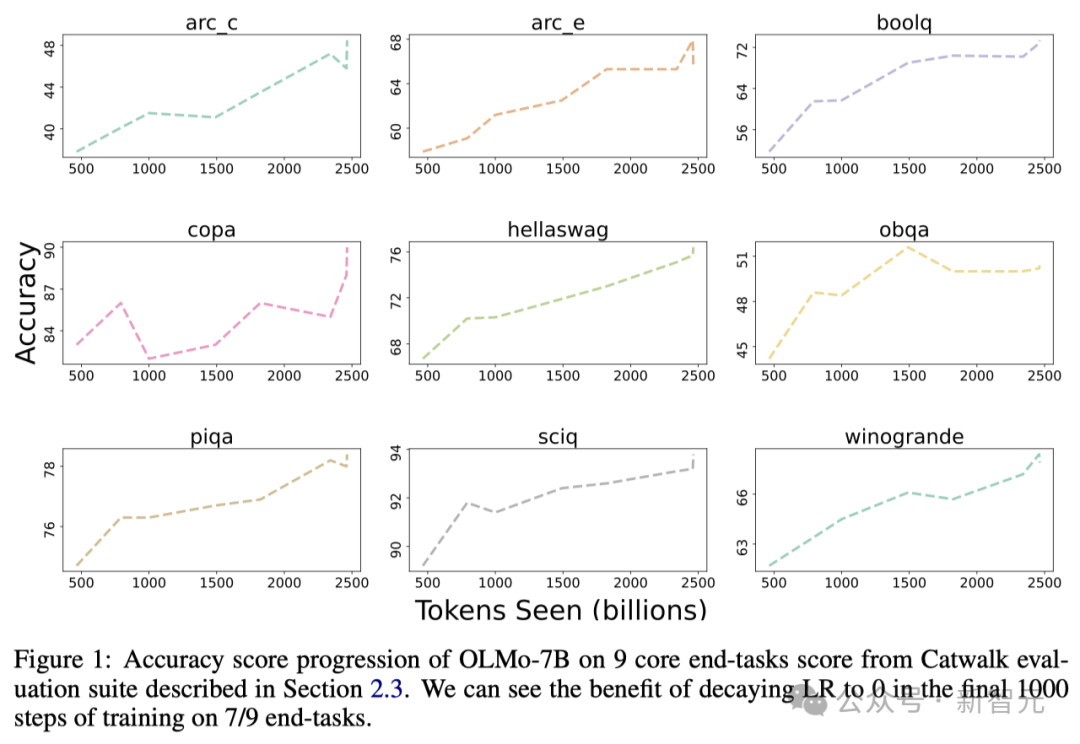
下图展示了9个核心任务准确率的变化趋势。

除了OBQA外,随着OLMo-7B接受更多数据的训练,几乎所有任务的准确率都呈现上升趋势。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

与此同时,OLMo 1B与其同类模型的核心评估结果表明,OLMo与它们处于同一水平。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

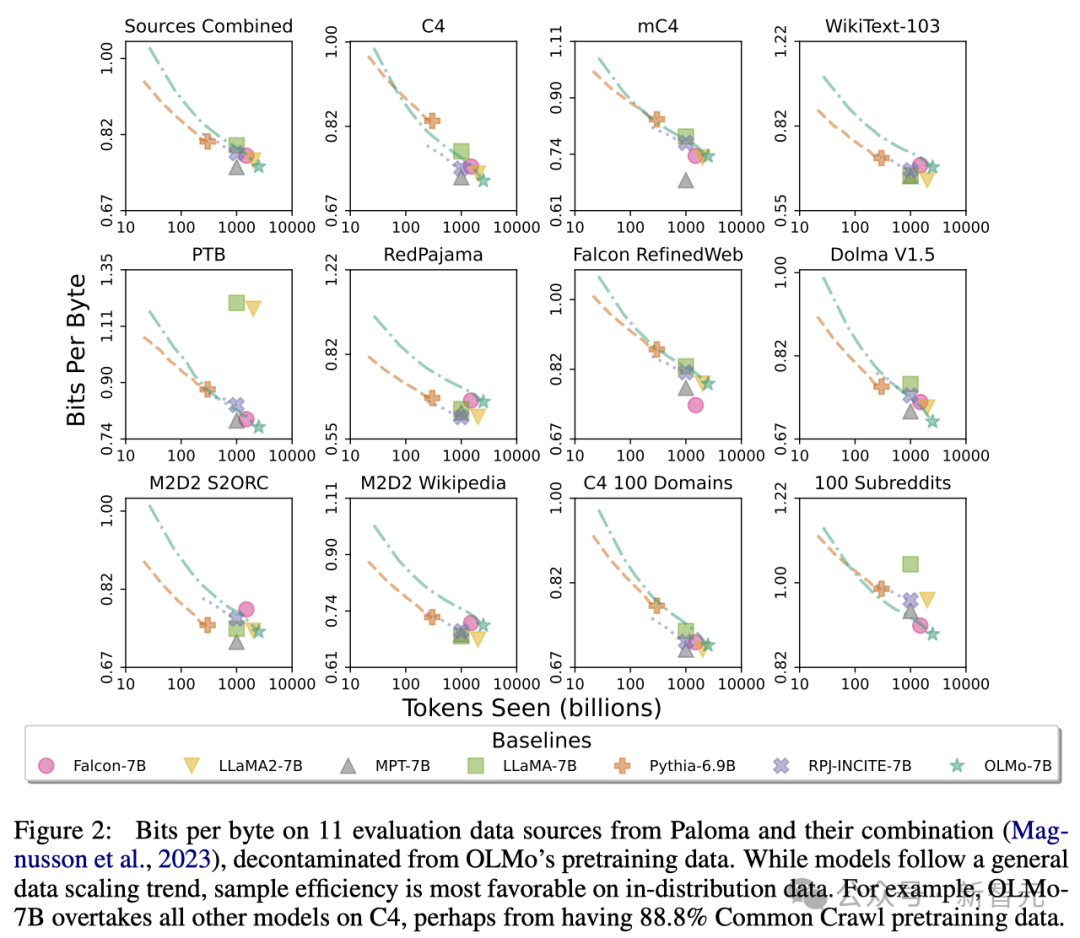
通过使用艾伦AI研究所的Paloma(一个基准测试)和可获取的检查点,研究人员分析了模型预测语言能力与模型规模因素(例如训练的token数量)之间的关系。

可以看到,OLMo-7B在性能上与主流模型持平。其中,每字节比特数(Bits per Byte)越低越好。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

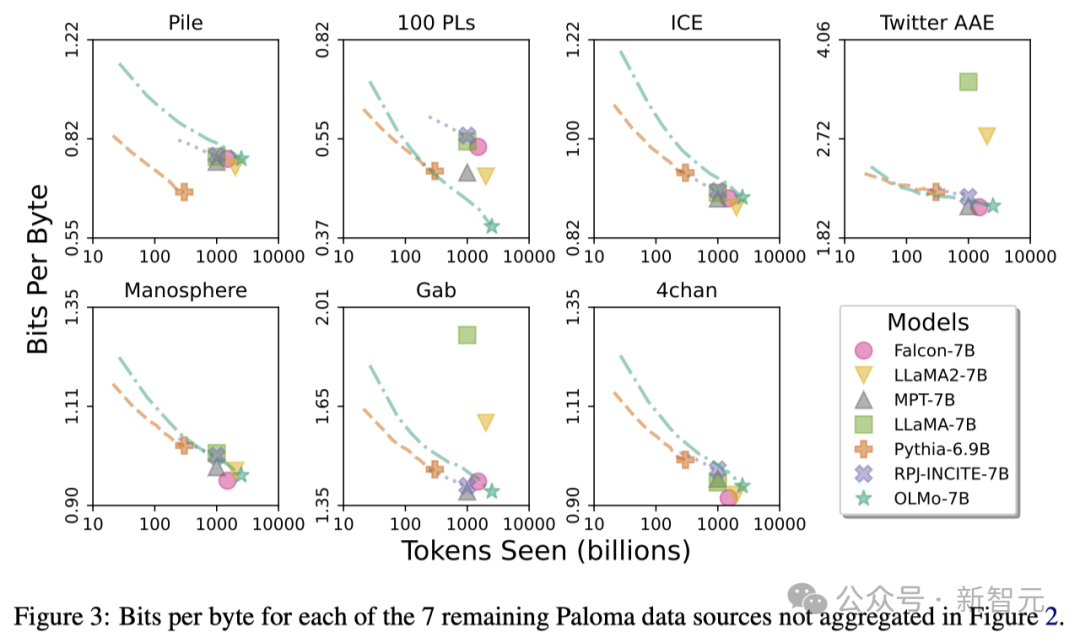
通过这些分析,研究人员发现模型在处理不同数据源时的效率差异较大,这主要取决于模型训练数据与评估数据的相似度。

特别地,OLMo-7B在主要基于Common Crawl的数据源上表现出色(比如C4)。

不过,在与网络抓取文本关系不大的数据源上,如WikiText-103、M2D2 S2ORC和M2D2 Wikipedia,OLMo-7B与其他模型相比效率较低。

RedPajama的评估也体现了相似的趋势,可能是因为它的7个领域中只有2个来源于Common Crawl,且Paloma对每个数据源中的各个领域给予了相同的权重。

鉴于像Wikipedia和arXiv论文这样的精选数据源提供的异质数据远不如网络抓取文本丰富,随着预训练数据集的不断扩大,维持对这些语言分布的高效率会很更加困难。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

OLMo架构

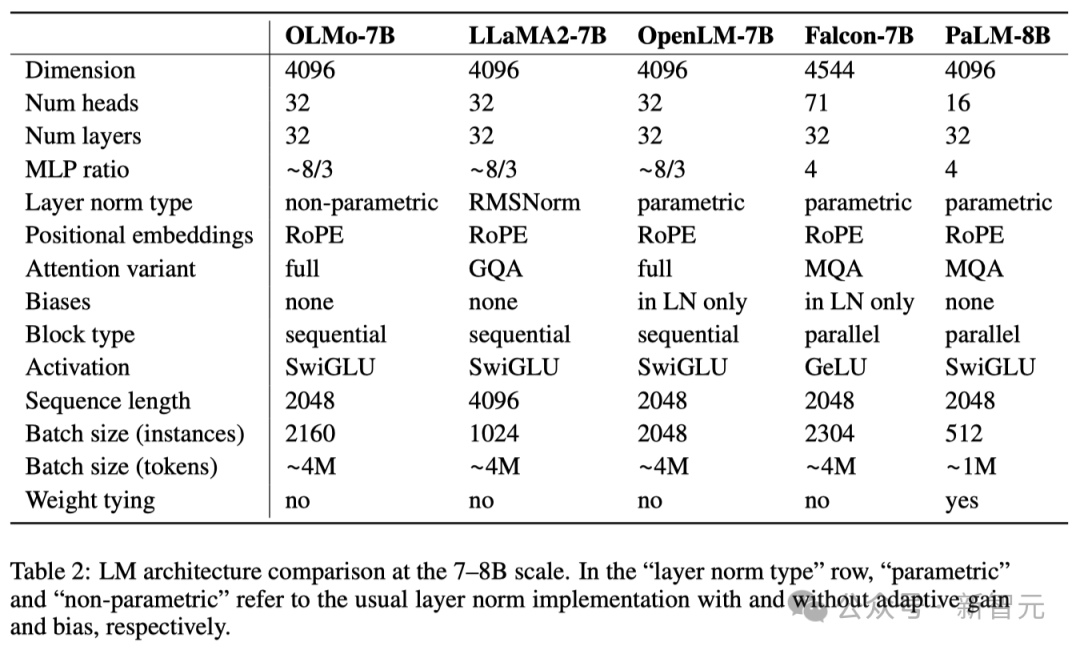
在模型的架构方面,团队基于的是decoder-only的Transformer架构,并采用了PaLM和Llama使用的SwiGLU激活函数,引入了旋转位置嵌入技术(RoPE),并改进了GPT-NeoX-20B的基于字节对编码(BPE)的分词器,以减少模型输出中的个人可识别信息。

此外,为了保证模型的稳定性,研究人员没有使用偏置项(这一点与PaLM的处理方式相同)。

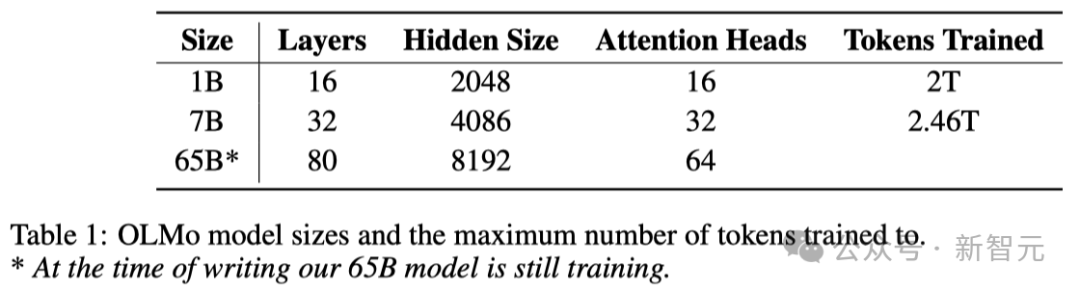
如下表所示,研究人员已经发布了1B和7B两个版本,同时还计划很快推出一个65B的版本。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

下表详细比较了7B架构与这些其他模型在相似规模下的性能。

史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

预训练数据集:Dolma

虽然研究人员在获取模型参数方面取得了一定的进展,但开源社区目前预训练数据集的开放程度还远远不够。

之前的预训练数据往往不会随着模型的开源而公开(闭源模型就更不用说了)。

而且有关这些数据的说明文档也常常缺乏足够的细节,但是这些细节对于想要复现研究或完全理解相关工作至关重要。

这一情况加大了语言模型研究的难度——比如,了解训练数据如何影响模型能力和其局限性。

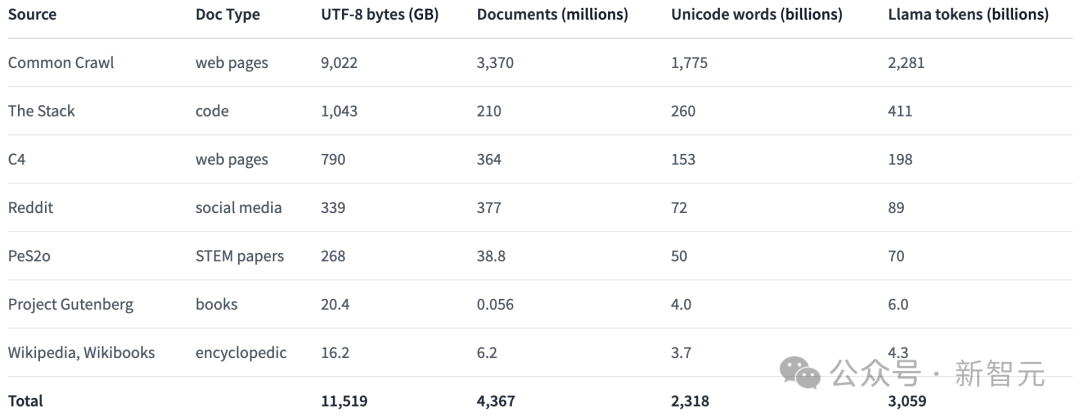
为了推动语言模型预训练领域的开放研究,研究人员构建并公开了预训练数据集Dolma。

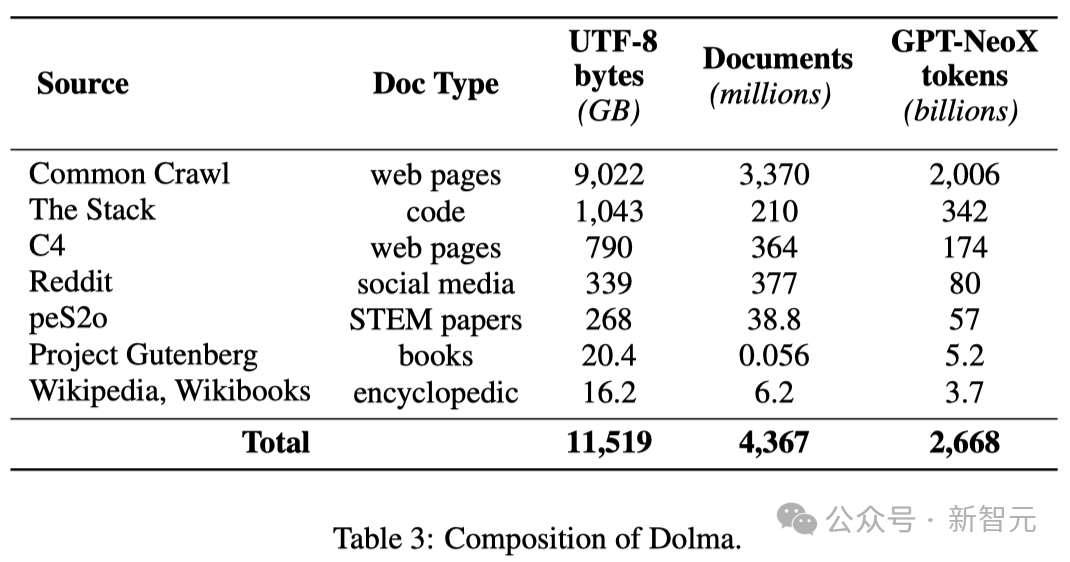
这是一个包含了从 7 种不同数据来源获取的3万亿个token的多样化、多源语料库。

这些数据源一方面在大规模语言模型预训练中常见,另一方面也能被普通大众所接触。

下表给出了来自各个数据源的数据量的概览。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

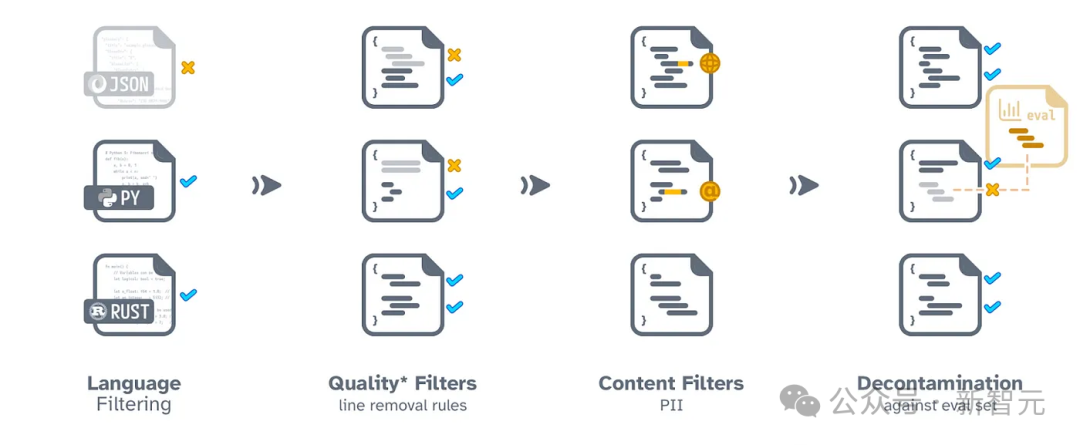
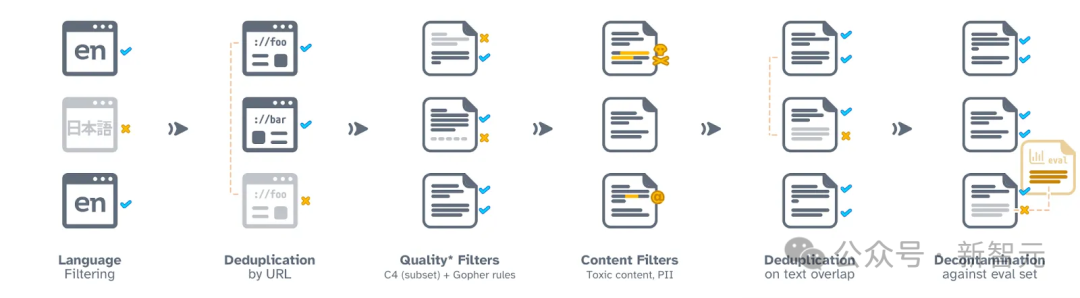
Dolma的构建过程包括六个步骤:语言过滤、质量过滤、内容过滤、去重、多源混合和token化。

在整理和最终发布Dolma过程中,研究人员确保各数据源的文档保持独立。

他们还开源了一套高效的数据整理工具,这套工具能够帮助进一步研究Dolma、复制成果,并简化预训练语料库的整理工作。

此外,研究人员也开源了WIMBD工具,以助于数据集分析。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

网络数据处理流程

史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

代码处理流程

训练OLMo

分布式训练框架

研究人员利用PyTorch的FSDP框架和ZeRO优化器策略来训练模型。这种方法通过将模型的权重和它们对应的优化器状态在多个GPU中进行分割,从而有效减少了内存的使用量。

在处理高达7B规模的模型时,这项技术使研究人员能够在每个GPU上处理4096个token的微批大小,以实现更高效的训练。

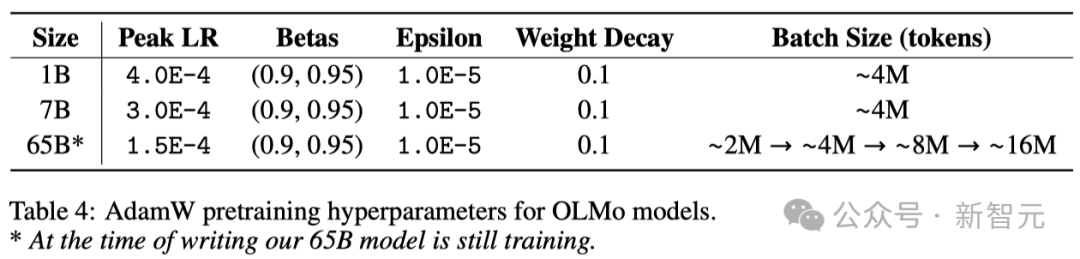
对于OLMo-1B和7B模型,研究人员固定使用大约4M token(2048个数据实例,每个实例包含2048个token的序列)的全局批大小。

而对于目前正在训练中的OLMo-65B模型,研究人员采用了一个批大小预热策略,起始于大约2M token(1024个数据实例),之后每增加100B token,批大小翻倍,直至最终达到大约16M token(8192个数据实例)的规模。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

为了加快模型训练的速度,研究人员采用了混合精度训练的技术,这一技术是通过FSDP的内部配置和PyTorch的amp模块来实现的。

这种方法特别设计,以确保一些关键的计算步骤(例如softmax函数)始终以最高精度执行,以保证训练过程的稳定性。

与此同时,其他大部分计算则使用一种称为bfloat16的半精度格式,以减少内存使用并提高计算效率。

在特定配置中,每个GPU上的模型权重和优化器状态都以最高精度保存。

只有在执行模型的前向传播和反向传播,即计算模型的输出和更新权重时,每个Transformer模块内的权重才会临时转换为bfloat16格式。

此外,各个GPU间同步梯度更新时,也会以最高精度进行,以确保训练质量。

优化器

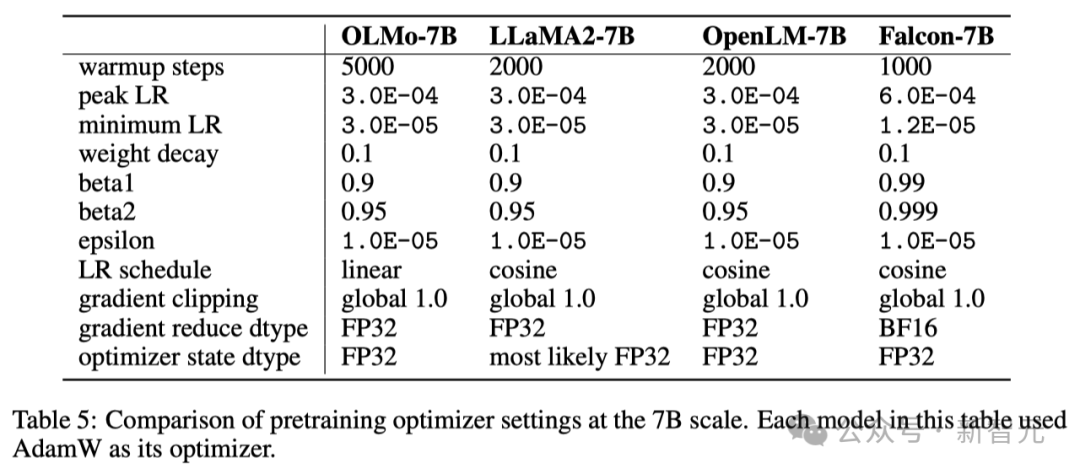
研究人员采用了AdamW优化器来调整模型参数。

无论模型规模大小如何,研究人员都会在训练初期的5000步(大约处理21B个token)内逐渐增加学习率,这一过程称为学习率预热。

预热结束后,学习率将按线性规律逐渐减少,直到降至最高学习率的十分之一。

此外,研究人员还会对模型参数的梯度进行裁剪,确保其总的 L1 范数不会超过 1.0。

在下表中,研究人员将自己在7B模型规模下的优化器配置与近期其他使用AdamW优化器的大型语言模型进行了对比。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

数据集

研究人员利用开放数据集Dolma中的一个2T token的样本,构建了他们的训练数据集。

研究人员将每篇文档的token连接起来,每篇文档的末尾都会加上一个特殊的 EOS token,接着将这些 token 分成每组 2048 个,形成训练样本。

这些训练样本在每次训练时都会以同样的方式进行随机打乱。研究人员还提供了一些工具,使得任何人都可以复原每个训练批次的具体数据顺序和组成。

研究人员已经发布的所有模型至少都经过了一轮(2T token)的训练。其中一些模型还进行了额外的训练,即在数据上进行第二轮训练,但采用了不同的随机打乱顺序。

根据之前的研究,这样重复使用少量数据的影响是微乎其微的。

英伟达和AMD都要YES!

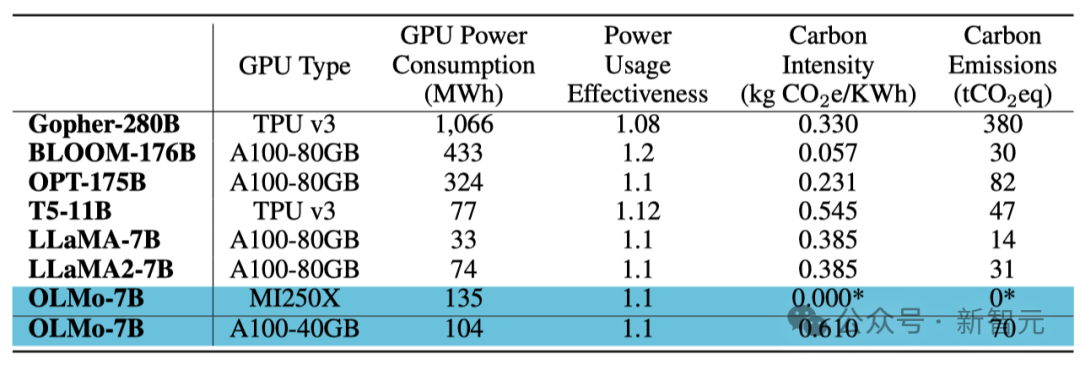
为了确保代码库能够同时在英伟达和AMD的GPU上都能高效运行,研究人员选择了两个不同的集群进行了模型训练测试:

利用LUMI超级计算机,研究人员部署了最多256个节点,每个节点搭载了4张AMD MI250X GPU,每张GPU 拥有128GB内存和800Gbps的数据传输速率。

通过MosaicML (Databricks) 的支持,研究人员使用了27个节点,每个节点配备了8张英伟达A100 GPU,每张GPU拥有40GB内存和800Gbps的数据传输速率。

虽然研究人员为了提高训练效率对批大小进行了微调,但在完成2T token的评估后,两个集群的性能几乎没有差异。
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

训练能耗

总结

与以往大多数仅仅提供模型权重和推理代码的模型不同,研究人员开源了OLMo的全部内容,包括训练数据、训练和评估代码,以及训练日志、实验结果、重要发现以及Weights & Biases的记录等等。

此外,团队正在研究如何通过指令优化和不同类型的强化学习(RLHF)来改进OLMo。而这些微调代码、数据和经过微调后的模型也都会被开源。

研究人员致力于持续支持和发展OLMo及其框架,推动开放语言模型(LM)的发展,助力开放研究社区的发展。为此,研究人员计划引入更多不同规模的模型、多种模态、数据集、安全措施和评估方法,丰富OLMo家族。

他们希望通过今后持续进行的彻底开源工作,增强开源研究社区的力量,并引发新一轮的创新浪潮。

团队介绍

Yizhong Wang(王义中)
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

Yizhong Wang是华盛顿大学Paul G. Allen计算机科学与工程学院的博士生,导师是Hannaneh Hajishirzi和Noah Smith。同时,也是艾伦人工智能研究所的兼职研究实习生。

此前,他曾在Meta AI、微软研究院和百度NLP进行实习。此前,他在北京大学获得了硕士学位,在上海交通大学获得了学士学位。

他的研究方向是自然语言处理(Natural Language Processing)、机器学习(Machine Learning),以及大语言模型(LLM)。

– LLM的适应性:如何更有效地构建和评估能够跟随指令的模型?在微调这些模型时,我们应该考虑哪些因素,它们又如何影响到模型的通用性?哪种类型的监督方式既有效又能扩展?

– LLM的持续学习:预训练和微调之间的界限在哪里?有哪些架构和学习策略能够让LLM在预训练之后继续进化?模型内部已有的知识如何与新学的知识相互作用?

– 大规模合成数据的应用:在生成模型迅速产生数据的今天,这些数据对我们的模型开发乃至整个互联网和社会有何影响?我们如何确保能够在大规模下生成多样且高质量的数据?我们能否区分这些数据与人类生成的数据?

Yuling Gu
史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训

Yuling Gu是艾伦人工智能研究所(AI2)Aristo团队的一位研究员。

2020年,她在纽约大学(NYU)获得学士学位。除了主修的计算机科学外,她还辅修了一个跨学科专业——语言与心智,这个专业结合了语言学、心理学和哲学。随后,她在华盛顿大学(UW)获得了硕士学位。

她对机器学习的技术和认知科学的理论的融合应用充满了热情。

以上就是史上首个100%开源大模型重磅登场!破纪录公开代码/权重/数据集/训练全过程,AMD都能训的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/428353.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
MAMP+ThinkPHP连接MySQL
上一篇 2025年11月7日 12:37:40
使用PowerShell管理和修改Windows域密码策略
下一篇 2025年11月7日 12:37:45

相关推荐

  • deepseek官方社区网址_加入deepseek官方社区官网交流

    deepseek官方社区网址是https://chat.deepseek.com/,该平台提供互动交流、模型更新、技术文档、多语言支持及开源项目协作,同时支持实时对话、多终端同步与API集成。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ …

    2026年9月10日
    600
  • Java 函数中的布尔类型返回值

    本文详细讲解了如何在 java 中创建和使用返回布尔类型的函数,以判断一个数是否为质数为例,展示了如何避免变量初始化问题,并提供了优化后的代码示例,帮助开发者编写更简洁高效的 java 代码。 在 Java 编程中,经常需要编写函数来执行特定的任务并返回一个结果。布尔类型(boolean)是一种常用…

    2026年9月10日
    100
  • vivo X90 Pro+充电慢 vivo X90 Pro+快充优化

    首先确认使用原装80W闪充套装并检查锁屏是否显示“闪充”,若无则排查充电设备、清洁接口、开启“默认超快充电模式”,避免边充边玩,注意散热与环境温度。 vivo X90 Pro+充电慢,通常不是单一原因造成的。想恢复快充速度,需要从硬件、设置和使用习惯多方面入手。重点先确认是否使用了原装80W双电芯闪…

    2026年9月9日
    000
  • 特斯拉 FSD 加入大量全新渲染模型 玩滑板的人都能识别

    近日,有汽车领域博主爆料,特斯拉的fsd(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。 这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、…

    2026年9月8日
    100
  • 用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐

    用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐

    aixiv专栏:北京交通大学adam团队探索系统2对齐,提升大模型安全性 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 北京交通大学ADaM团队长期关注AI安全领域,此前已开源o1复现项目o1-Coder (https://www.php.…

    2026年9月7日 用户投稿
    000
  • Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释

    Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释

    deepseek开源大模型的横空出世,引发美国ai巨头恐慌,meta首当其冲。 近期,Meta员工在Teamblind匿名论坛爆料,DeepSeek一系列低成本高性能的模型发布,让Meta生成式AI团队面临巨大压力,其高昂预算的合理性受到质疑。 爆料帖原文指出,DeepSeek-V3在基准测试中超越…

    2026年9月7日 用户投稿
    000
  • DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录

    DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录

    darwin 1.5:一款基于语言接口的材料发现与设计ai模型 材料科学的核心挑战在于高效地寻找理想的材料成分和结构。传统的计算方法,例如高通量筛选和机器学习,通常依赖于复杂的、特定任务的描述符,这些描述符难以泛化,且与真实材料特性存在偏差,限制了实际应用。为了克服这些局限,GreenDynamic…

    2026年9月6日 用户投稿
    000
  • 实现5Å全原子RMSD,普渡大学深度学习方法准确预测RNA三级结构,登Nature子刊

    实现5Å全原子RMSD,普渡大学深度学习方法准确预测RNA三级结构,登Nature子刊实现5Å全原子RMSD,普渡大学深度学习方法准确预测RNA三级结构,登Nature子刊实现5Å全原子RMSD,普渡大学深度学习方法准确预测RNA三级结构,登Nature子刊实现5Å全原子RMSD,普渡大学深度学习方法准确预测RNA三级结构,登Nature子刊

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 编辑 | 萝卜皮 非编码 RNA 在各种生物功能中发挥着调控作用,并且与人类健康、药物设计等领域息息相关。 了解功能的机械机制需要三级结构信息,然而,通过实验确定 RNA 三维结构成本高昂且耗时…

    2026年9月5日 用户投稿
    100
  • 求第n个质数:如何用埃筛法优化代码,降低内存消耗?

    高效求解第n个质数:埃拉托斯特尼筛法优化 本文探讨如何利用埃拉托斯特尼筛法(埃筛法)优化求解第n个质数的代码,有效降低内存消耗。 原始方法中,循环判断质数导致内存溢出,而埃筛法提供了一种更高效的解决方案。 埃拉托斯特尼筛法原理 埃筛法是一种经典的素数筛选算法。其基本思想是从2开始,依次标记每个数的倍…

    2026年9月5日
    100
  • 如何优化质数判断代码以降低内存占用?

    高效寻找第n个质数:内存优化策略 寻找第n个质数的算法通常涉及大量数字的质数判定,直接使用嵌套循环的朴素方法会导致内存占用过高。本文介绍一种基于埃拉托斯特尼筛法的优化方法,有效降低内存消耗。 埃拉托斯特尼筛法是一种高效的质数筛选算法。它首先创建一个布尔数组,初始时所有元素都标记为质数(true)。然…

    2026年9月5日
    100
  • 致敬DeepSeek:以国产GPU为基,燎原中国AI生态之火

    deepseek开源模型(v3、r1系列等)在多语言理解和复杂推理任务中表现出色,极大促进了ai技术发展,为开发者提供了重要资源。deepseek不仅技术领先,更积极回馈开源社区。 摩尔线程高效部署DeepSeek 国产GPU创新企业摩尔线程已高效部署DeepSeek蒸馏模型推理服务,助力开发者基于…

    2026年9月5日
    400
  • 质数与素数的定义解析

    1、 null 2、 质数,也称素数,是指大于1且仅能被1和自身整除的自然数,例如2、3、5、7等。这类数字有无穷多个,是数论研究中的核心内容之一。 3、 数量统计 4、 对于任意一个大于1的数a与它的两倍之间,必然至少存在一个质数。 5、 存在任意长度的由连续质数组成的等差数列。 6、 每个偶数都…

    2026年9月2日
    100
  • 为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家

    为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家

    deepseek风靡一时,但并非人人可用。 众多ai云服务商抓住机遇,纷纷上线deepseek模型,并推出优惠活动吸引用户。然而,免费token往往难以顺利调用deepseek-r1,可用性堪忧。 这凸显了选择可靠大厂的重要性。 火山引擎上线DeepSeek-R1模型(含完整版及蒸馏版),并赠送50…

    2026年9月2日 用户投稿
    100
  • 苹果选择通义,肯定阿里的同时,也否定了阿里

    苹果ai订单尘埃落定:阿里通义千问胜出,生态安全成关键 历时两年的苹果AI订单争夺战最终以阿里巴巴胜出告终。2月11日消息,苹果已选择阿里巴巴为中国版iPhone开发人工智能功能。 自2023年起,苹果便在测试多家中国AI模型,竞争者包括百度、字节跳动等巨头,以及百川智能、月之暗面和DeepSeek…

    2026年9月1日
    000
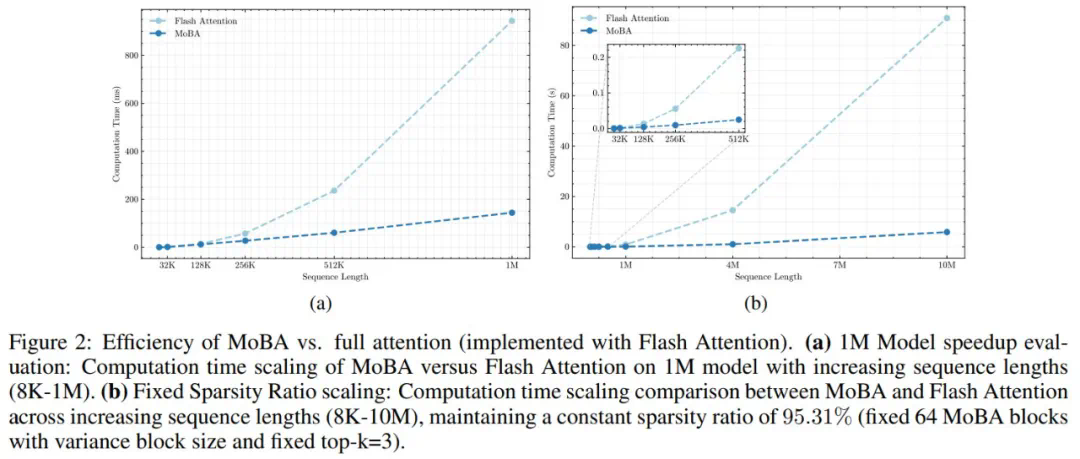
  • 撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开

    撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开

    月之暗面发布moba注意力机制,高效处理超长文本!近日,月之暗面团队公开了一种名为moba(mixture of block attention,块注意力混合)的全新注意力机制,该机制巧妙地将混合专家(moe)原理应用于注意力机制,并在长文本处理方面展现出显著优势。这与deepseek同期发布的ns…

    2026年8月31日 用户投稿
    200
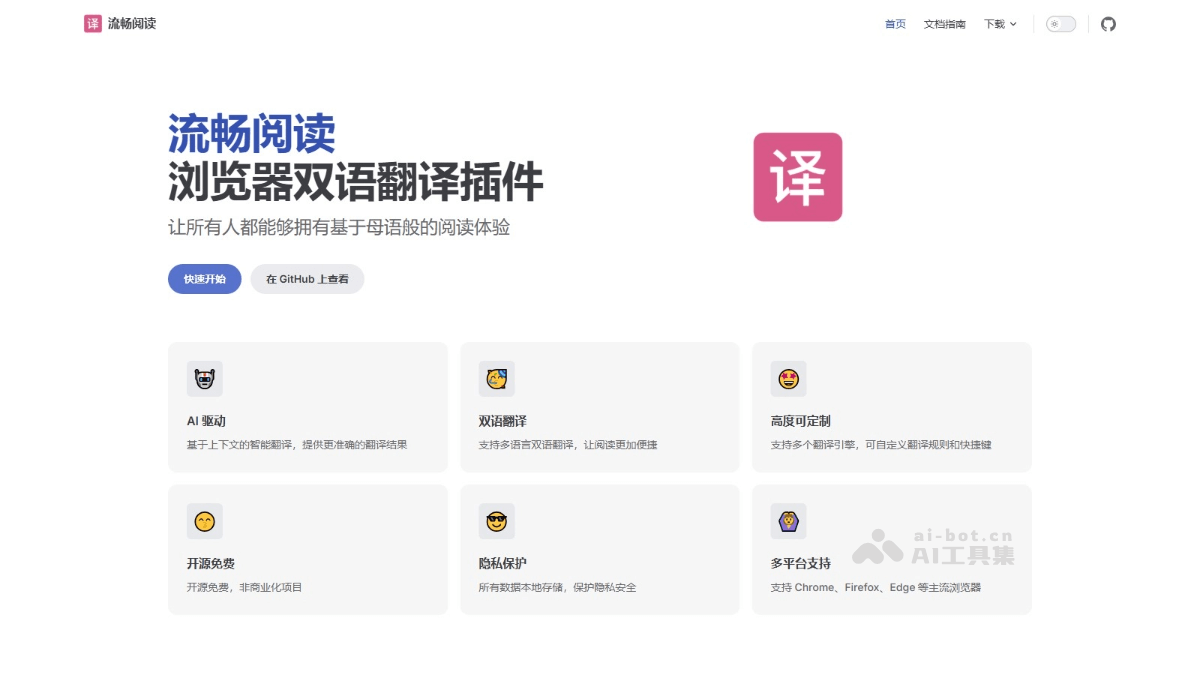
  • 流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示

    流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示

    fluentread:你的浏览器翻译利器,助你畅享无障碍阅读体验! FluentRead是一款开源浏览器翻译插件,它利用先进的AI技术,旨在为你提供如同母语般流畅的阅读体验。支持多种翻译引擎,包括传统的机器翻译和强大的AI大模型,并且允许你自定义翻译服务。其核心功能包含智能翻译、便捷的双语对照显示以…

    2026年8月29日 用户投稿
    200
  • 完美世界入选“2025高品质消费品牌TOP100”榜单

    7月10日,南方都市报联合广东连锁经营协会发布“2025高品质消费品牌top100”榜单,完美世界股份有限公司成功入选,并荣获“年度十大消费科技创新品牌”奖项,彰显其在高品质兴趣消费领域的引领地位。 在数字经济时代,数字内容产品已成为大众文化精神生活的重要组成部分。以数字游戏、电子竞技、影视作品为代…

    2026年8月29日
    000
  • OpenAI等AI公司竞相利用“蒸馏”技术 构建低成本模型

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 全球领先的人工智能公司,包括OpenAI、微软和Meta,正积极采用“模型蒸馏”技术,致力于打造更经济实惠的AI模型,惠及消费者和企业。 DeepSeek公司在中国利用这项技术,基于Meta和阿…

    2026年8月28日
    100
  • 为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理

    为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理为什么Qwen能自我改进推理,Llama却不行?斯坦福找到了原理

    深度解析:大模型的自我改进能力为何参差不齐?斯坦福大学最新研究揭秘 近期,斯坦福大学的一项研究深入探讨了大型语言模型(LLM)自我改进能力背后的机制,解释了为何有些模型能够有效利用额外计算资源提升性能,而另一些则停滞不前。该研究的核心在于模型的初始“认知行为”。 研究人员选取了Qwen-2.5-3B…

    2026年8月27日 用户投稿
    200
  • Meta发布AI新模型系列 Llama 4,首次采用“混合专家”架构

    meta发布全新多模态ai模型系列llama 4,引领开源ai发展! 该系列包含llama 4 scout、llama 4 maverick和llama 4 behemoth三个模型,能够处理文本、视频、图像和音频等多种数据类型,并在不同格式间实现内容转换。 ☞☞☞AI 智能聊天, 问答助手, AI…

    2026年8月26日
    000

发表回复

登录后才能评论
关注微信