对MySQL配置参数 my.ini/my.cnf的详细解析

今天我们今天主要向大家描述的是MySQL配置参数 my.ini/my.cnf,以下的文章就是对其实际操作的具体内容的详细解析

以下的文章主要描述的是对MySQL配置参数 my.ini/my.cnf的详细解析,我们主要是以实例演示的方式来对MySQL配置参数 my.ini/my.cnf的实际操作步骤进行说明,以下就是相关内容的具体描述。

1.获取当前配置参数

要优化MySQL配置参数,首先要了解当前的配置参数以及运行情况。使用下列命令可以获得目前服务器使用的配置参数:
代码如下:
mysqld –verbose –help
mysqladmin variables extended-status –u root –p

在MySQL控制台里面,运行下列命令可以获取状态变量的值:
代码如下:
mysql> SHOW STATUS; 如果只要检查某几个状态变量,可以使用下列命令:
mysql> SHOW STATUS LIKE ‘[匹配模式]’; ( 可以使用%、?等 )

2.优化参数
参数优化基于一个前提,就是在我们的数据库中通常都使用InnoDB表,而不使用MyISAM表。在优化MySQL时,有两个MySQL配置参数是最重要的,即table_cache和key_buffer_size。

table_cache

table_cache指定表高速缓存的大小。每当MySQL访问一个表时,如果在表缓冲区 中还有空间,该表就被打开并放入其中,这样可以更快地访问表内容。通过检查峰值时间的状态值Open_tables和Opened_tables,可以决 定是否需要增加table_cache的值。如果你发现 open_tables等于table_cache,并且opened_tables在不断增长,那么你就需要增加table_cache的值了(上述状 态值可以使用SHOW STATUS LIKE ‘Open%tables’获得)。注意,不能盲目地把table_cache设置成很大的值。如果设置得太高,可能会造成文件描述符不足,从而造成性能 不稳定或者连接失败。

对于有1G内存的机器,推荐值是128-256。

案例1:该案例来自一个不是特别繁忙的服务器
代码如下:
table_cache – 512
open_tables – 103
opened_tables – 1273
uptime – 4021421 (measured in seconds)

该案例中table_cache似乎设置得太高了。在峰值时间,打开表的数目比table_cache要少得多。

案例2:该案例来自一台开发服务器。

代码如下:
table_cache – 64
open_tables – 64
opened-tables – 431
uptime – 1662790 (measured in seconds)

虽然open_tables已经等于table_cache,但是相对于服务器运行时间来说,opened_tables的值也非常低。因此,增加table_cache的值应该用处不大。

案例3:该案例来自一个upderperforming的服务器

代码如下:
table_cache – 64
open_tables – 64
opened_tables – 22423
uptime – 19538

该案例中table_cache设置得太低了。虽然运行时间不到6小时,open_tables达到了最大值,opened_tables的值也非常高。这样就需要增加table_cache的值。

key_buffer_size

key_buffer_size指定索引缓冲区的大小,它决定索引处理的速度,尤其是索引读 的速度。通过检查状态值 Key_read_requests和Key_reads,可以知道key_buffer_size设置是否合理。比例key_reads / key_read_requests应该尽可能的低,至少是1:100,1:1000更好(上述状态值可以使用SHOW STATUS LIKE ‘key_read%’获得)。

key_buffer_size只对MyISAM表起作用。即使你不使用MyISAM表,但是内部的临时磁盘表是MyISAM表,也要使用该值。可以使用检查状态值created_tmp_disk_tables得知详情。

对于1G内存的机器,如果不使用MyISAM表,推荐值是16M(8-64M)。

案例1:健康状况
代码如下:
key_buffer_size – 402649088 (384M)
key_read_requests – 597579931
key_reads – 56188

案例2:警报状态

代码如下:
key_buffer_size – 16777216 (16M)
key_read_requests – 597579931
key_reads – 53832731

案例1中比例低于1:10000,是健康的情况;案例2中比例达到1:11,警报已经拉响。

优化query_cache_size

从4.0.1开始,MySQL配置参数提供了查询缓冲机制。使用查询缓冲,MySQL将SELECT语句和查询结果存放在缓冲区中,今后对于同样的SELECT语句(区分大小写),将直接从缓冲区中读取结果。根据MySQL用户手册,使用查询缓冲最多可以达到238%的效率。

通过检查状态值Qcache_*,可以知道query_cache_size设置是否合理 (上述状态值可以使用SHOW STATUS LIKE ‘Qcache%’获得)。如果Qcache_lowmem_prunes的值非常大,则表明经常出现缓冲不够的情况,如果Qcache_hits的值也 非常大,则表明查询缓冲使用非常频繁,此时需要增加缓冲大小;

如果Qcache_hits的值不大,则表明你的查询重复率很低,这种情况下使用查询缓冲反 而会影响效率,那么可以考虑不用查询缓冲。此外,在SELECT语句中加入SQL_NO_CACHE可以明确表示不使用查询缓冲。

与查询缓冲有关的参数还有query_cache_type、 query_cache_limit、 query_cache_min_res_unit。query_cache_type指定是否使用查询缓冲,可以设置为0、1、2,该变量是 SESSION级的变量。

query_cache_limit指定单个查询能够使用的缓冲区大小,缺省为1M。 query_cache_min_res_unit是在4.1版本以后引入的,它指定分配缓冲区空间的最小单位,缺省为4K。检查状态值 Qcache_free_blocks,如果该值非常大,则表明缓冲区中碎片很多,这就表明查询结果都比较小,此时需要减小 query_cache_min_res_unit。

开启二进制日志( Binary Log )

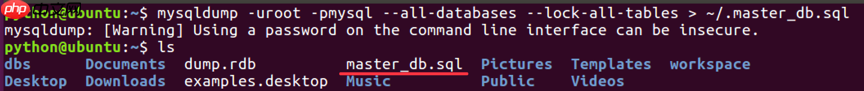
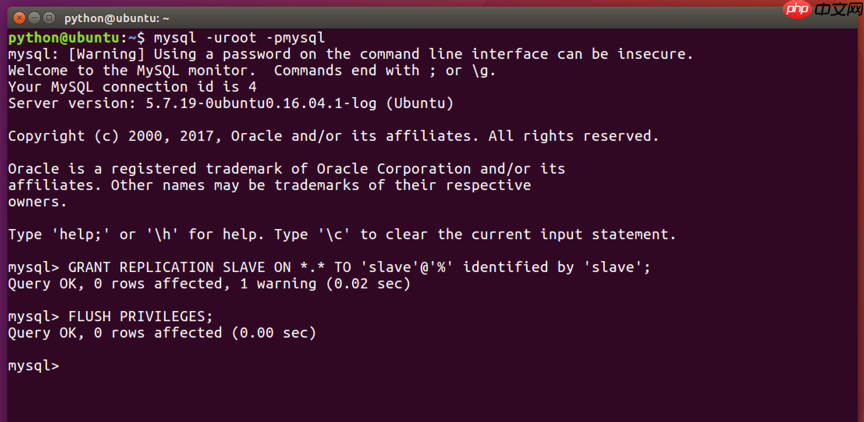
二进制日志包含所有更新数据的语句,其目的是在恢复数据库时用它来把数据尽可能恢复到最后的状态。另外,如果做同步复制( Replication )的话,也需要使用二进制日志传送修改情况。

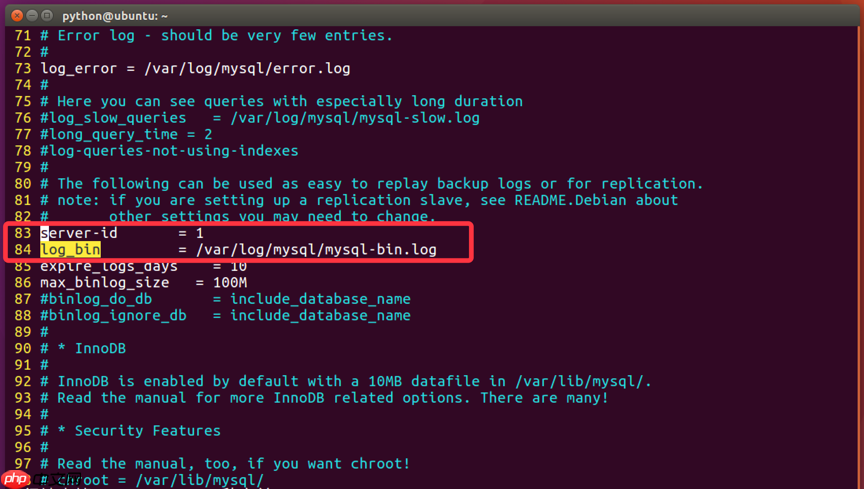
开启二进制日志,需要设置参数log-bin。log_bin指定日志文件,如果不提供文件名,MySQL将自己产生缺省文件名。MySQL会在文件名后面自动添加数字索引,每次启动服务时,都会重新生成一个新的二进制文件。

此外,使用log-bin-index可以指定索引文件;使用binlog-do-db可以 指定记录的数据库;使用binlog-ignore- db可以指定不记录的数据库。注意的是:binlog-do-db和binlog-ignore-db一次只指定一个数据库,指定多个数据库需要多个语 句。而且,MySQL会将所有的数据库名称改成小写,在指定数据库时必须全部使用小写名字,否则不会起作用。

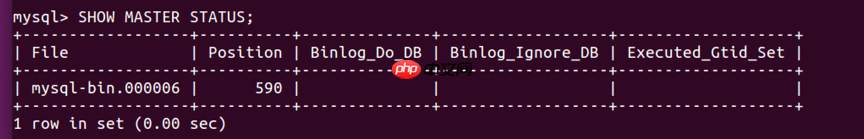
在MySQL中使用SHOW MASTER STATUS命令可以查看目前的二进制日志状态。

开启慢查询日志( slow query log )

慢查询日志对于跟踪有问题的查询非常有用。它记录所有查过long_query_time的查询,如果需要,还可以记录不使用索引的记录。下面是一个慢查询日志的例子:

开启慢查询日志,需要设置参数log_slow_queries、 long_query_times、log-queries-not-using -indexes。log_slow_queries指定日志文件,如果不提供文件名,MySQL将自己产生缺省文件名。 long_query_times指定慢查询的阈值,缺省是10秒。log-queries-not-using-indexes是4.1.0以后引入的 参数,它指示记录不使用索引的查询。

配置InnoDB

相对于MyISAM表来说,正确MySQL配置参数对于InnoDB表更加关键。其中,最重要的参数是 innodb_data_file_path。它指定表数据和索引存储的空间,可以是一个或者多个文件。最后一个数据文件必须是自动扩充的,也只有最后一 个文件允许自动扩充。这样,当空间用完后,自动扩充数据文件就会自动增长(以8MB为单位)以容纳额外的数据。例如:
代码如下:
innodb_data_file_path=/disk1/ibdata1:900M;/disk2/ibdata2:50M:autoextend

两个数据文件放在不同的磁盘上。数据首先放在ibdata1中,当达到900M以后,数据就放在ibdata2中。一旦达到50MB,ibdata2将以8MB为单位自动增长。

如果磁盘满了,你需要在另外的磁盘上面增加一个数据文件。为此,你需要查看最后一个文件的尺寸,然后计算最接近的整数(MB)。然后手工修改该文件的大小,并添加新的数据文件。例如:假设ibdata2已经有109MB数据,那么可以修改如下:

代码如下:
innodb_data_file_path=/disk1/ibdata1:900M;/disk2/ibdata2:109M;/disk3/ibdata3:500M:autoextend
flush_time

如果系统有问题并且经常锁死或重新引导,应将该变量设置为非零值,这将导致服务器按flush_time 秒来刷新表的高速缓存。用这种方法来写出对表的修改将降低性能,但可减少表讹误或数据丢失的机会。

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/447851.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
java 数组怎么赋值
上一篇 2025年11月7日 21:39:22
laravel表格增删改查
下一篇 2025年11月7日 21:39:27

相关推荐

  • 如何在Sublime运行PHP代码|本地服务器配置图文详解

    如何在Sublime运行PHP代码|本地服务器配置图文详解如何在Sublime运行PHP代码|本地服务器配置图文详解如何在Sublime运行PHP代码|本地服务器配置图文详解如何在Sublime运行PHP代码|本地服务器配置图文详解

    在 sublime text 中无法直接运行 php 代码,需配置本地服务器环境。安装 xampp 或 wamp(xampp 跨平台,wamp 仅限 windows)后启动 apache 和 mysql 服务,并将 php 文件置于 htdocs 目录下即可运行。可通过方法一手动复制文件至 htdo…

    2026年10月1日 • 用户投稿
    000
  • 如何实现MySQL中的事务处理?

    如何实现MySQL中的事务处理?如何实现MySQL中的事务处理?如何实现MySQL中的事务处理?如何实现MySQL中的事务处理?

    如何实现MySQL中的事务处理? 事务是数据库中重要的概念之一,能够保证数据的一致性和完整性,确保在并发操作中数据的正确性。MySQL作为一种常用的关系型数据库,也提供了事务处理的机制。 一、事务的特点 事务具有以下四个特点,通常用ACID来概括:原子性(Atomicity)、一致性(Consist…

    2026年10月1日 • 用户投稿
    200
  • 如何通过提升MySQL数据库技能来拓宽就业机会?

    如何通过提升MySQL数据库技能来拓宽就业机会?如何通过提升MySQL数据库技能来拓宽就业机会?如何通过提升MySQL数据库技能来拓宽就业机会?如何通过提升MySQL数据库技能来拓宽就业机会?

    如何通过提升MySQL数据库技能来拓宽就业机会? 随着信息技术的飞速发展,数据库管理技能已经成为许多企业和组织中不可或缺的一部分。MySQL作为一种备受青睐的开源关系型数据库管理系统,越来越受到企业的青睐和采用。因此,提升MySQL数据库技能可以为个人在求职市场上创造更多就业机会。下面将介绍一些提升…

    2026年10月1日 • 用户投稿
    100
  • 修改my.cnf配置文件解决MySQL存储乱码问题

    mysql存储中文出现乱码问题,主要原因是字符集未正确配置。1. 在my.cnf中将默认字符集设为utf8mb4,确保客户端和服务器端使用utf8mb4;2. 检查并修改数据库、表及字段的字符集为utf8mb4;3. 应用连接mysql时指定字符集为utf8mb4;4. 注意重启服务、工具连接方式、…

    2026年10月1日
    100
  • MySQL如何排序查询结果 多列排序与自定义排序规则

    MySQL如何排序查询结果 多列排序与自定义排序规则MySQL如何排序查询结果 多列排序与自定义排序规则MySQL如何排序查询结果 多列排序与自定义排序规则MySQL如何排序查询结果 多列排序与自定义排序规则

    mysql排序查询结果的核心是使用order by子句,它支持按一个或多个列进行升序(asc)或降序(desc)排序。1. 多列排序时,优先级从左到右依次递减,即先按第一个列排序,相同值时再按第二个列排序,依此类推;2. 自定义排序可通过field()函数或case语句实现,field()根据字段值…

    2026年10月1日 • 用户投稿
    400
  • 大数据技术领域,MySQL和Oracle的对比与选择建议。

    大数据技术领域,MySQL和Oracle的对比与选择建议。大数据技术领域,MySQL和Oracle的对比与选择建议。大数据技术领域,MySQL和Oracle的对比与选择建议。大数据技术领域,MySQL和Oracle的对比与选择建议。

    大数据技术领域,MySQL和Oracle的对比与选择建议 摘要:随着大数据时代的到来,数据库管理系统起着至关重要的作用。在大数据技术领域,MySQL和Oracle是两个常见的选择。本文将对这两种数据库管理系统的特点进行对比,并给出在不同场景下的选择建议。 关键词:大数据,数据库管理系统,MySQL,…

    2026年10月1日 • 用户投稿
    000
  • 大数据时代,MySQL与Oracle哪个更受欢迎?如何选择适合自己的数据库技术?

    大数据时代,MySQL与Oracle哪个更受欢迎?如何选择适合自己的数据库技术?大数据时代,MySQL与Oracle哪个更受欢迎?如何选择适合自己的数据库技术?大数据时代,MySQL与Oracle哪个更受欢迎?如何选择适合自己的数据库技术?大数据时代,MySQL与Oracle哪个更受欢迎?如何选择适合自己的数据库技术?

    大数据时代,MySQL与Oracle哪个更受欢迎?如何选择适合自己的数据库技术? 随着大数据时代的到来,数据库成为了企业和个人处理和管理海量数据的重要工具。在数据库市场中,MySQL和Oracle作为两个领先的品牌备受关注。那么在这两者之间,哪个更受欢迎呢?如何选择适合自己的数据库技术? MySQL…

    2026年10月1日 • 用户投稿
    200
  • 技术同学须知的MySQL设计规约,为你的数据库开发保驾护航!

    技术同学须知的MySQL设计规约,为你的数据库开发保驾护航!技术同学须知的MySQL设计规约,为你的数据库开发保驾护航!技术同学须知的MySQL设计规约,为你的数据库开发保驾护航!技术同学须知的MySQL设计规约,为你的数据库开发保驾护航!

    技术同学须知的MySQL设计规约,为你的数据库开发保驾护航! MySQL作为一种常用的关系型数据库管理系统,被广泛应用于各种应用场景中。在数据库设计和开发过程中,良好的规约是确保数据库系统高效、可靠运行的关键。本文将为技术同学提供一份MySQL设计规约,帮助你保驾护航你的数据库开发。 一、命名规约 …

    2026年9月30日 • 用户投稿
    300
  • MySQL如何实现字段自增步长 非1自增步长设置技巧

    MySQL如何实现字段自增步长 非1自增步长设置技巧MySQL如何实现字段自增步长 非1自增步长设置技巧MySQL如何实现字段自增步长 非1自增步长设置技巧MySQL如何实现字段自增步长 非1自增步长设置技巧

    mysql字段自增步长非1的实现方法主要有两种:一是通过设置auto_increment_increment和auto_increment_offset系统变量,例如set auto_increment_increment=5; set auto_increment_offset=10; 可使id从…

    2026年9月30日 • 用户投稿
    600
  • MySQL怎样合并多个表 多表联合查询与数据合并

    MySQL怎样合并多个表 多表联合查询与数据合并MySQL怎样合并多个表 多表联合查询与数据合并MySQL怎样合并多个表 多表联合查询与数据合并MySQL怎样合并多个表 多表联合查询与数据合并

    mysql合并多个表的常见方法有联合查询(join)和数据合并(union或insert select)。1. join用于逻辑连接表,按关联列组合行,包括inner join(仅匹配行)、left join(左表全显示)、right join(右表全显示)及通过left+right join模拟的…

    2026年9月30日 • 用户投稿
    200
  • Ubuntu下MySQL主从同步配置步骤

    Ubuntu下MySQL主从同步配置步骤Ubuntu下MySQL主从同步配置步骤Ubuntu下MySQL主从同步配置步骤Ubuntu下MySQL主从同步配置步骤

    1)在ubuntu中安装mysql,并使用docker安装另一台mysql 为了确保主从同步时多台MySQL的版本一致,假设Ubuntu中已安装的MySQL版本为5.7.22,以下是获取相同版本的Docker镜像的步骤: docker image pull mysql:5.7.22 或 docker…

    2026年9月30日 • 用户投稿
    100
  • MySQL如何压缩数据库 表空间压缩与备份压缩方案

    MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案

    mysql数据库压缩需求评估需先明确数据类型与业务场景。1.文本数据压缩率高,图片、视频等二进制数据压缩效果差;2.频繁读写数据压缩可能影响性能,冷数据压缩收益更高;3.通过查询information_schema分析大表与低频更新表;4.使用监控工具评估压缩前后性能影响。表空间压缩方法包括:1.使…

    2026年9月30日 • 用户投稿
    200
  • Sublime进行数据库索引优化分析_提升数据查询性能与响应速度

    Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度

    使用sublime text辅助数据库索引优化分析,一、通过慢查询日志定位瓶颈,利用多行选择和正则表达式筛选耗时sql;二、结合执行计划判断索引使用情况,关注type和extra字段;三、检查表结构与索引定义,优化复合索引顺序及删除冗余索引。 在处理大量数据时,数据库的查询性能直接影响到系统的响应速…

    2026年9月30日 • 用户投稿
    100
  • 服务器上安装Mysql8.0

    服务器上安装Mysql8.0服务器上安装Mysql8.0服务器上安装Mysql8.0服务器上安装Mysql8.0

    本教程适用于社区版mysql,供日常学习交流使用,不得用于商业用途。如需商业用途,请通过官方渠道购买正版产品。 第一步,准备好连接工具。我直接使用了控制台的远程连接。如果不是在自己电脑上操作,通常会使用xshell进行连接,操作流程基本相同。 连接到ECS后,需移除默认的MariaDB数据库: yu…

    2026年9月30日 • 用户投稿
    500
  • sublime如何优化SQL编写体验 sublime数据库查询的高效技巧

    sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧

    安装package control后,通过其安装sqltools及对应数据库驱动插件以实现语法高亮、代码片段和数据库连接;2. 配置sqltools用户设置中的数据库连接信息,并利用内置或自定义代码片段快速生成sql语句;3. 安装sql beautifier进行代码格式化,结合sublimelin…

    2026年9月30日 • 用户投稿
    400
  • Linux下MySQL 8.0 二进制安装

    mysql社区版:开源且免费,但不提供技术支持,需搭配其他开源工具使用。 MySQL企业版:与社区版代码相同,通过插件提供额外功能,如线程插件、审计插件等。 MySQL Cluster CGE集群商业版:实时开源事务数据库,设计用于高吞吐量环境下快速、持久地访问数据。支持并行分布式查询引擎、自动分区…

    2026年9月30日
    100
  • 如何在Red Hat 8上配置MySQL高可用集群的详细步骤?

    如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?

    配置MySQL高可用集群,说白了就是让你的数据库扛得住压力,不怕宕机。Red Hat 8上搞这个,其实挺考验运维功底的,但也不是啥高不可攀的事儿。 解决方案 准备环境: 至少三台Red Hat 8服务器。 别想着一台机器玩转高可用,那是耍流氓。确保服务器之间网络互通,防火墙放行MySQL和集群通信端…

    2026年9月30日 • 用户投稿
    100
  • MySQL如何实现跨库事务 XA分布式事务处理方案

    MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案

    有,更轻量级方案包括柔性事务,如1.tcc(try-confirm-cancel)由应用层实现,通过预扣、确认或回滚操作处理分布式事务;2.saga模式将事务拆分为多个本地事务并配有补偿机制;3.基于消息队列实现最终一致性,这些方案以牺牲强一致性换取性能与可用性提升。 MySQL实现跨库事务,通常会…

    2026年9月30日 • 用户投稿
    100
  • 如何在mysql中创建数据库 mysql数据库创建方法详解

    在 mysql 中创建数据库的命令是 create database mydatabase;。1. 数据库名大小写不敏感,除非使用引号,且不能包含空格和特殊字符。2. 可以指定字符集和排序规则,如 create database mydatabase character set utf8mb4 co…

    2026年9月30日
    100
  • Sublime结合命令行自动执行数据任务_构建轻量化分析流水线

    Sublime结合命令行自动执行数据任务_构建轻量化分析流水线Sublime结合命令行自动执行数据任务_构建轻量化分析流水线Sublime结合命令行自动执行数据任务_构建轻量化分析流水线Sublime结合命令行自动执行数据任务_构建轻量化分析流水线

    sublime text在数据任务自动化中扮演高效的幕后推手角色,它作为轻量级代码编辑与管理界面,提供快速启动、多光标编辑、多文件管理及丰富的插件生态(如anaconda增强python开发),使用户能高效编写模块化脚本(如clean_data.py、run_pipeline.sh);随后通过命令行…

    2026年9月30日 • 用户投稿
    1000

发表回复

登录后才能评论
关注微信