该方案针对2021广东工业智造创新大赛瓷砖瑕疵检测任务,基于Paddle2.2及PaddleDetection套件的FasterRCNN模型实现。处理初赛白板瓷砖数据(含15230张训练图、1762张测试图),将标注转为COCO格式,划分训练集与验证集,经训练、评估后,生成符合竞赛要求的预测提交文件,以实现瓷砖瑕疵的定位与分类。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
天池大赛-2021广东工业智造创新大赛—智能算法赛FasterRCNN方案
赛题背景
佛山作为国内最大的瓷砖生产制造基地之一,拥有众多瓷砖厂家和品牌。经前期调研,瓷砖生产环节一般(不同类型砖工艺不一样,这里以抛釉砖为例)经过原材料混合研磨、脱水、压胚、喷墨印花、淋釉、烧制、抛光,最后进行质量检测和包装。得益于产业自动化的发展,目前生产环节已基本实现无人化。而质量检测环节仍大量依赖人工完成。一般来说,一条产线需要配2~6名质检工,长时间在高光下观察瓷砖表面寻找瑕疵。这样导致质检效率低下、质检质量层次不齐且成本居高不下。瓷砖表检是瓷砖行业生产和质量管理的重要环节,也是困扰行业多年的技术瓶颈。
本赛场聚焦瓷砖表面瑕疵智能检测,要求选手开发出高效可靠的计算机视觉算法,提升瓷砖表面瑕疵质检的效果和效率,降低对大量人工的依赖。要求算法尽可能快与准确的给出瓷砖疵点具体的位置和类别,主要考察疵点的定位和分类能力。
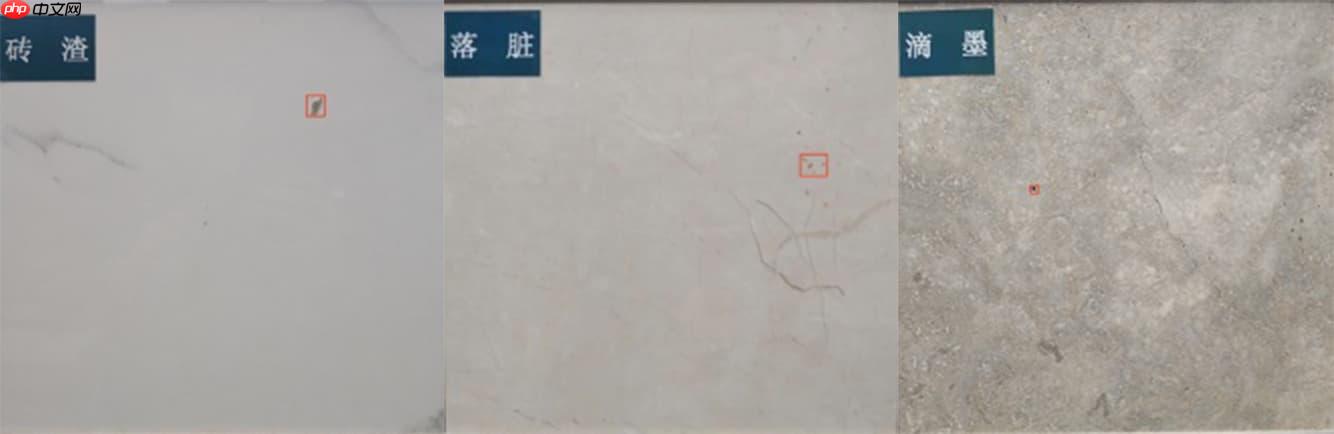
赛题数据说明: 大赛深入到佛山瓷砖知名企业,在产线上架设专业拍摄设备,实地采集生产过程真实数据,解决企业真实的痛点需求。大赛数据覆盖到了瓷砖产线所有常见瑕疵,包括粉团、角裂、滴釉、断墨、滴墨、B孔、落脏、边裂、缺角、砖渣、白边等。实拍图示例如下:
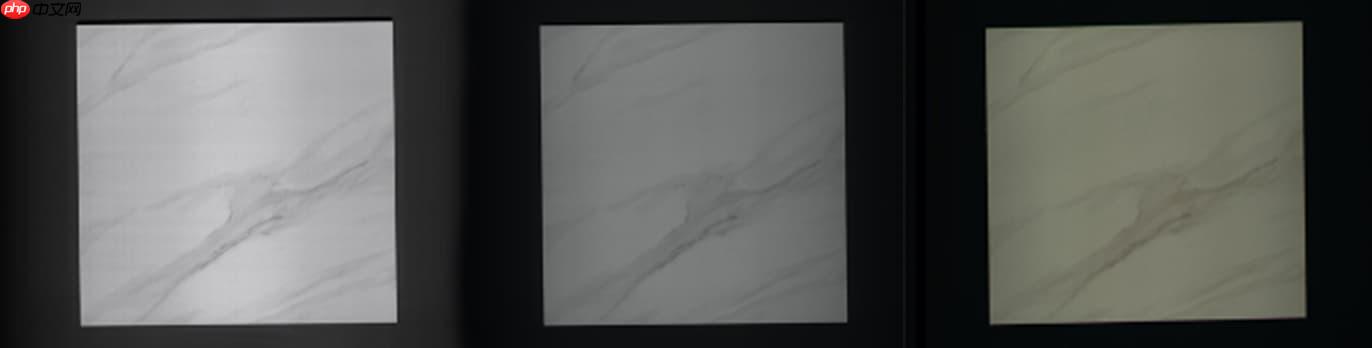
针对某些缺陷在特定视角下的才能拍摄到,每块砖拍摄了三张图,包括低角度光照黑白图、高角度光照黑白图、彩色图,示例如下:
数据主要分为两种:
白板瓷砖。花色简单,数量总共约12000张,包含训练集和测试集,用于初赛。复杂瓷砖。花色相对复杂,并提供相应的模板图片(同花色且无瑕疵图片),数量总共约12000张,包含训练集和测试集,用于复赛。
初赛数据集: 白板数据包含有瑕疵图片、无瑕疵图片和标注数据。标注数据标注瑕疵位置和类别信息。训练集共15230张,测试集A共1762张
└── dataset ├── Readme.md ├── train_annos.json └── train_imgs
环境准备
In [1]
!pip install scikit-image
In [2]
#安装至全局,如果重启项目,这几个依赖和库需要重新安装%cd /home/aistudio/cocoapi/PythonAPI!make install%cd ../..
In [4]
#解压paddle的目标检测套件源码!unzip /home/aistudio/data/data113827/PaddleDetection-release-2.2_tile.zip -d work/
In [5]
#安装依赖%cd /home/aistudio/work/PaddleDetection-release-2.2!pip install -r requirements.txt!python setup.py install
In [6]
#解压数据集,训练集先放work路径下,后面划分验证集时候在弄到paddledetection下,测试集直接放过去# 该过程需要3mins多钟!unzip /home/aistudio/data/data66771/tile_round1_train_20201231.zip -d /home/aistudio/work/dataset!unzip /home/aistudio/data/data66771/tile_round1_testA_20201231.zip -d /home/aistudio/work/PaddleDetection-release-2.2/dataset/coco
In [7]
#注意路径要正确,大部分已经改成绝对路径%cd ..
/home/aistudio/work
分析数据
类别不均衡,类别: {‘0’: 0, ‘1’: 576, ‘2’: 2151, ‘3’: 2174, ‘4’: 1112, ‘5’: 8886, ‘6’: 331}图片像素尺寸比较大:图片平均高5562.212738017071,图片平均宽7474.7293499671705In [ ]
#调用一些需要的第三方库import numpy as npimport pandas as pdimport shutilimport jsonimport osimport cv2import globfrom PIL import Image
In [ ]
path = "/home/aistudio/work/dataset/tile_round1_train_20201231/train_imgs/220_146_t20201124140430373_CAM1.jpg"img1=cv2.imread(path)print(img1.shape)img2=Image.open(path)print(img2.size)
(6000, 8192, 3)(8192, 6000)
In [ ]
#统计一下类别path = "/home/aistudio/work/dataset/tile_round1_train_20201231/train_annos.json"dict_class = { "0":0, "1":0, "2":0, "3":0, "4":0, "5":0, "6":0}id_s = 0image_width,image_height = 0,0with open(path,"r") as f: files = json.load(f) #遍历标注文件 for file_img in files: id_s += 1 #统计类别 file_class = file_img["category"] dict_class[str(file_class)] += 1 #统计图片平均像素 image_height += file_img["image_height"] image_width += file_img["image_width"] if id_s % 1000 is 0: print("处理到第{}个标注".format(id_s))print("类别:",dict_class)print("图片平均高{},图片平均宽{}".format(image_height/id_s,image_width/id_s))
将数据标注转为coco格式
paddledetection支持coco格式和voc格式,原数据标注不是这2种格式其中0类也就是背景类是没有数据的,所以可以去了,类别是1-6,共6个类别,当然如果用rcnn需要加上背景类,用yolo就不需要In [ ]
class Fabric2COCO: def __init__(self, is_mode = "train" ): self.images = [] self.annotations = [] self.categories = [] self.img_id = 0 self.ann_id = 0 self.is_mode = is_mode if not os.path.exists("/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/{}".format(self.is_mode)): os.makedirs("/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/{}".format(self.is_mode)) def to_coco(self, anno_file,img_dir): self._init_categories() anno_result= pd.read_json(open(anno_file,"r")) if self.is_mode == "train": anno_result = anno_result.head(int(anno_result['name'].count()*0.9))#取数据集前百分之90 elif self.is_mode == "val": anno_result = anno_result.tail(int(anno_result['name'].count()*0.1)) name_list=anno_result["name"].unique()#返回唯一图片名字 for img_name in name_list: img_anno = anno_result[anno_result["name"] == img_name]#取出此图片的所有标注 bboxs = img_anno["bbox"].tolist()#返回list defect_names = img_anno["category"].tolist() assert img_anno["name"].unique()[0] == img_name img_path=os.path.join(img_dir,img_name) #img =cv2.imread(img_path) #h,w,c=img.shape #这种读取方法更快 img = Image.open(img_path) w, h = img.size #h,w=6000,8192 self.images.append(self._image(img_path,h, w)) self._cp_img(img_path)#复制文件路径 if self.img_id % 200 is 0: print("处理到第{}张图片".format(self.img_id)) for bbox, label in zip(bboxs, defect_names): annotation = self._annotation(label, bbox) self.annotations.append(annotation) self.ann_id += 1 self.img_id += 1 instance = {} instance['info'] = 'fabric defect' instance['license'] = ['none'] instance['images'] = self.images instance['annotations'] = self.annotations instance['categories'] = self.categories return instance def _init_categories(self): #1,2,3,4,5,6个类别 for v in range(1,7): print(v) category = {} category['id'] = v category['name'] = str(v) category['supercategory'] = 'defect_name' self.categories.append(category) def _image(self, path,h,w): image = {} image['height'] = h image['width'] = w image['id'] = self.img_id image['file_name'] = os.path.basename(path)#返回path最后的文件名 return image def _annotation(self,label,bbox): area=(bbox[2]-bbox[0])*(bbox[3]-bbox[1]) points=[[bbox[0],bbox[1]],[bbox[2],bbox[1]],[bbox[2],bbox[3]],[bbox[0],bbox[3]]] annotation = {} annotation['id'] = self.ann_id annotation['image_id'] = self.img_id annotation['category_id'] = label annotation['segmentation'] = []# np.asarray(points).flatten().tolist() annotation['bbox'] = self._get_box(points) annotation['iscrowd'] = 0 annotation["ignore"] = 0 annotation['area'] = area return annotation def _cp_img(self, img_path): shutil.copy(img_path, os.path.join("/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/{}".format(self.is_mode), os.path.basename(img_path))) def _get_box(self, points): min_x = min_y = np.inf max_x = max_y = 0 for x, y in points: min_x = min(min_x, x) min_y = min(min_y, y) max_x = max(max_x, x) max_y = max(max_y, y) '''coco,[x,y,w,h]''' return [min_x, min_y, max_x - min_x, max_y - min_y] def save_coco_json(self, instance, save_path): import json with open(save_path, 'w') as fp: json.dump(instance, fp, indent=1, separators=(',', ': '))#缩进设置为1,元素之间用逗号隔开 , key和内容之间 用冒号隔开
In [ ]
'''转换有瑕疵的样本为coco格式'''#训练集,划分90%做为训练集img_dir = "/home/aistudio/work/dataset/tile_round1_train_20201231/train_imgs"anno_dir="/home/aistudio/work/dataset/tile_round1_train_20201231/train_annos.json"fabric2coco = Fabric2COCO()train_instance = fabric2coco.to_coco(anno_dir,img_dir)if not os.path.exists("/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/annotations/"): os.makedirs("/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/annotations/")fabric2coco.save_coco_json(train_instance, "/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/annotations/"+'instances_{}.json'.format("train"))
In [ ]
'''转换有瑕疵的样本为coco格式'''#验证集,划分10%做为验证集img_dir = "/home/aistudio/work/dataset/tile_round1_train_20201231/train_imgs"anno_dir="/home/aistudio/work/dataset/tile_round1_train_20201231/train_annos.json"fabric2coco = Fabric2COCO(is_mode = "val")train_instance = fabric2coco.to_coco(anno_dir,img_dir)if not os.path.exists("/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/annotations/"): os.makedirs("/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/annotations/")fabric2coco.save_coco_json(train_instance, "/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/annotations/"+'instances_{}.json'.format("val"))
模型训练
配置文件已经放在work下,work/faster_rcnn_r50_fpn_2x.yml。 –eval参数表示在训练过程中在验证集上验证模型。
在某个模型基础上继续训练加上如 -r output/faster_rcnn_r50_fpn_2x/12.pdparams的参数。
In [8]
#开始训练%cd /home/aistudio/work/PaddleDetection-release-2.2/#%env CUDA_VISIBLE_DEVICES=0!python tools/train.py -c /home/aistudio/work/faster_rcnn_r50_fpn_2x.yml -r /home/aistudio/work/PaddleDetection-release-2.2/output/faster_rcnn_r50_fpn_2x/12.pdparams --eval
模型评估
模型评估需要指定被评估模型,如-o weights=output/faster_rcnn_r50_fpn_2x/best_model.pdparams:
In [9]
#模型评估%cd /home/aistudio/work/PaddleDetection-release-2.2/!python tools/eval.py -c /home/aistudio/work/faster_rcnn_r50_fpn_2x.yml -o weights=/home/aistudio/work/PaddleDetection-release-2.2/output/faster_rcnn_r50_fpn_2x/best_model.pdparams
模型预测
模型预测调用tools/infer.py文件,需要指定模型路径、被预测的图像路径如–infer_img=dataset/coco/val/235_7_t20201127123214965_CAM2.jpg、预测结果输出目录如–output_dir=infer_output/等:
预测结果会直接画在图像上保存在output_dir目录下。
In [11]
#模型预测%cd /home/aistudio/work/PaddleDetection-release-2.2/!python -u tools/infer.py -c /home/aistudio/work/faster_rcnn_r50_fpn_2x.yml --output_dir=infer_output/ --save_txt=True -o weights=/home/aistudio/work/PaddleDetection-release-2.2/output/faster_rcnn_r50_fpn_2x/best_model.pdparams --infer_img=/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/val/235_7_t20201127123214965_CAM2.jpg
生成提交文件(json文件)
注意:该处是用eval生成的,PaddleDetection配置文件中读取验证集需要先读取img和标注(这里把img路径改成测试集的,标注随便弄个json文件,将save_prediction_only=True)
将测试集生成标注文件代码如下,生成的测试集标注文件存放在dataset/coco/annotations/instances_test.json:
In [38]
#生成个test标注文件(无效的)import os, sys, zipfileimport urllib.requestimport shutilimport numpy as npimport skimage.io as ioimport pandasimport matplotlib.pyplot as pltimport pylabimport jsonimport tqdmfrom PIL import Image#generate test def test_from_dir(pic_path): pics = os.listdir(pic_path) meta = {} images = [] annotations = [] categories=[] for v in range(1,7): category = {} category['id'] = v category['name'] = str(v) category['supercategory'] = 'defect_name' categories.append(category) num = 0 for im in pics: num += 1 annotation = { "area": 326.1354999999996, "iscrowd": 0, "image_id": num, "bbox": [ 1654.76, 2975, 22, 15 ], "category_id": 5, "ignore": 0, "segmentation": [], "id": num } img = os.path.join(pic_path,im) img = Image.open(img) images_anno = {} images_anno['file_name'] = im images_anno['width'] = img.size[0] images_anno['height'] = img.size[1] images_anno['id'] = num images.append(images_anno) annotations.append(annotation) meta['images'] = images meta['categories'] = categories meta['annotations'] = annotations print(len(annotations)) json.dump(meta,open('/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/annotations/instances_test.json','w'),indent=4, ensure_ascii=False)
In [39]
#生成测试集标注(伪标注,无效的)pic_path='/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/tile_round1_testA_20201231/testA_imgs'test_from_dir(pic_path)
1762
运行模型评估,数据集指向测试集。本案例为大家提供了修改完数据配置的配置文件faster_rcnn_r50_fpn_2x_test.yml:
In [40]
#模型评估(预测),标注在生成的bbox.json文件中,注意要把read配置文件中的eval部分的batch_size改成1,不然会报错,这边已经改好了# 该过程大概需要一个半小时%cd /home/aistudio/work/PaddleDetection-release-2.2!python tools/eval.py -c /home/aistudio/work/faster_rcnn_r50_fpn_2x_test.yml -o weights=/home/aistudio/work/PaddleDetection-release-2.2/output/faster_rcnn_r50_fpn_2x/best_model.pdparams save_prediction_only=True
In [41]
#将评估预测的结果按照我们生成的测试集伪标注格式保存bbox = '/home/aistudio/work/PaddleDetection-release-2.2/bbox.json'test_path = '/home/aistudio/work/PaddleDetection-release-2.2/dataset/coco/annotations/instances_test.json'sub_path = '/home/aistudio/work/PaddleDetection-release-2.2/results.json'def make_submittion(sub_path,bbox,test_path): meta = {} with open(bbox) as f: bbox = json.load(f) with open(test_path) as f: test_ann = json.load(f) meta['images'] = test_ann['images'] meta['annotations'] = bbox json.dump(meta,open(sub_path,'w'),indent=4) make_submittion(sub_path,bbox,test_path)
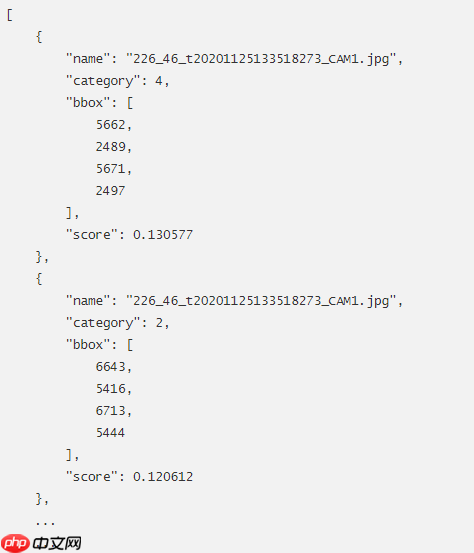
按照标注提交格式生成预测结果final_results.json
In [42]
final_path = '/home/aistudio/work/PaddleDetection-release-2.2/final_results.json'results_path = '/home/aistudio/work/PaddleDetection-release-2.2/results.json'def final_result(final_path, results_path): with open(results_path,"r") as f: test_result = json.load(f) #获取图片id对应的图片名字字典 imgs = test_result["images"] dict_img = {} for img in imgs: img_name = img["file_name"] img_id = img["id"] dict_img[str(img_id)] = img_name #print("*******",dict_img) #按照提交格式对应字段 final_results = [] annotations = test_result["annotations"] for ann in annotations: dict_ann = {} #设置图片name #将图片id对应为name ann_name_id = str(ann["image_id"]) dict_ann["name"] = dict_img[ann_name_id] #设置类别category dict_ann["category"] = ann["category_id"] #设置bbox #之前预测的bbox中格式为【左上角横坐标x,左上角纵坐标y,框的高h,框的宽w】 #提交格式要求的bbox格式为【左上角横坐标,左上角纵坐标,右下角横坐标,右下角纵坐标】 bbox = ann["bbox"] bbox = [bbox[0],bbox[1],bbox[0]+bbox[2],bbox[1]+bbox[3]] dict_ann["bbox"] = bbox #设置置信度score dict_ann["score"] = ann["score"] final_results.append(dict_ann) #print(final_results[0]) json.dump(final_results,open(final_path,'w'),indent=4) final_result(final_path, results_path)
通过上面的代码得到了竞赛提交文件final_results.json。
以上就是2021广东工业智造创新大赛-瓷砖瑕疵检测方案的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/45936.html
 微信扫一扫
 支付宝扫一扫