将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

预训练大语言模型(LLM)在特定任务上的性能不断提高,随之而来的是,假如 prompt 指令得当,其可以更好的泛化到更多任务,很多人将这一现象归功于训练数据和参数的增多,然而最近的趋势表明,研究者更多的集中在更小的模型上,不过这些模型是在更多数据上训练而成,因而在推理时更容易使用。

举例来说,参数量为 7B 的 LLaMA 在 1T token 上训练完成,尽管平均性能略低于 GPT-3,但参数量是后者的 1/25。不仅如此,当前的压缩技术还能将这些模型进一步压缩,在保持性能的同时还能大幅减少内存需求。通过这样的改进,性能良好的模型可以在终端用户设备(如笔记本)上进行部署。

然而,这又面临另一个挑战,即想要将这些模型压缩到足够小的尺寸以适应这些设备,怎样才能兼顾生成质量。研究表明,尽管压缩后的模型生成的答案准确率还可以,但现有的 3-4 位量化技术仍然会让准确性降低。由于 LLM 生成是顺序进行的,依赖于先前生成的 token,小的相对误差不断累积并导致严重的输出损坏。为了确保可靠的质量,关键是设计出低位宽的量化方法,与 16 位模型相比不会降低预测性能。

然而,将每个参数量化到 3-4 位通常会导致中等程度、甚至是高等程度的准确率损失,特别是那些非常适合边缘部署的 1-10B 参数范围内的较小模型。

为了解决准确性问题,来自华盛顿大学、苏黎世联邦理工学院等机构的研究者提出了一种新的压缩格式和量化技术 SpQR(Sparse-Quantized Representation,稀疏 – 量化表征),首次实现了 LLM 跨模型尺度的近无损压缩,同时达到了与以前方法相似的压缩水平。

SpQR 通过识别和隔离异常权重来工作,这些异常权重会导致特别大的量化误差,研究者将它们以更高的精度存储,同时将所有其他权重压缩到 3-4 位,在 LLaMA 和 Falcon LLMs 中实现了不到 1% 的困惑度相对准确率损失。从而可以在单个 24GB 的消费级 GPU 上运行 33B 参数的 LLM,而不会有任何性能下降,同时还能提高 15% 的速度。

SpQR 算法高效,既可以将权重编码为其他格式,也可以在运行时进行有效地解码。具体来说,该研究为 SpQR 提供了一种高效的 GPU 推理算法,可以比 16 位基线模型更快地进行推理,同时实现了超过 4 倍的内存压缩收益。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

论文地址:https://arxiv.org/pdf/2306.03078.pdf项目地址:https://github.com/Vahe1994/SpQR

方法

该研究提出一种混合稀疏量化的新格式 —— 稀疏量化表征(SpQR),可以将精确预训练的 LLM 压缩到每个参数 3-4 位,同时保持近乎无损。

具体来说,该研究将整个过程分为两步。第一步是异常值检测:该研究首先孤立了异常值权重,并证明其量化会导致高误差:异常值权重保持高精度,而其他权重以低精度(例如 3 位的格式)存储。然后,该研究以非常小的组大小实现分组量化(grouped quantization)的变体,并表明量化尺度本身可以被量化为 3 位表征。

SpQR 极大地减少了 LLM 的内存占用,而不会降低准确性,同时与 16 位推理相比,LLM 的生成速度快了 20%-30%。

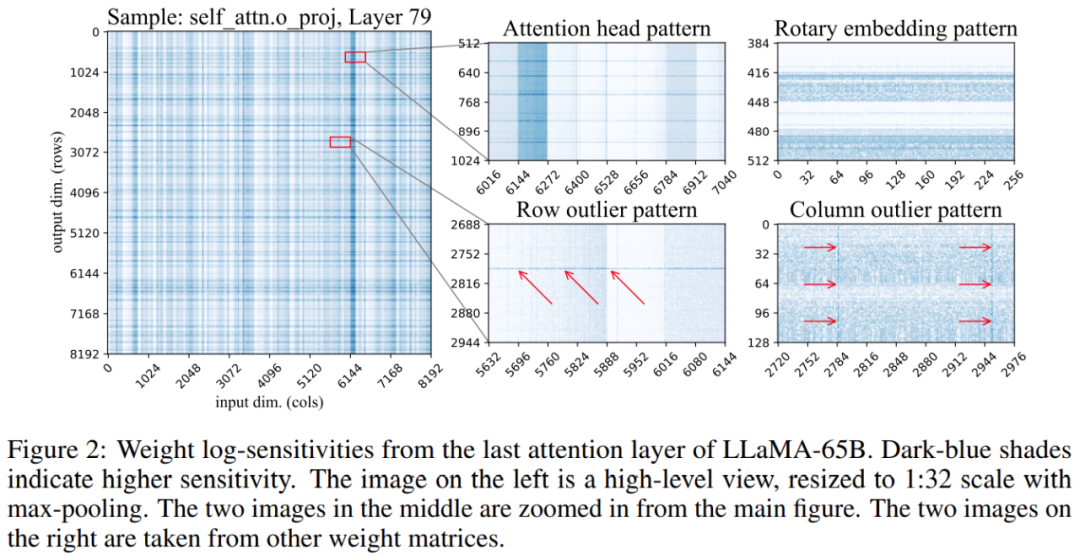
此外,该研究发现,权重矩阵中敏感权重的位置不是随机的,而是具有特定的结构。为了在量化过程中突出显示其结构,该研究计算了每个权重的敏感度,并为 LLaMA-65B 模型可视化这些权重敏感度。下图 2 描绘了 LLaMA-65B 最后一个自注意力层的输出投影。
将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

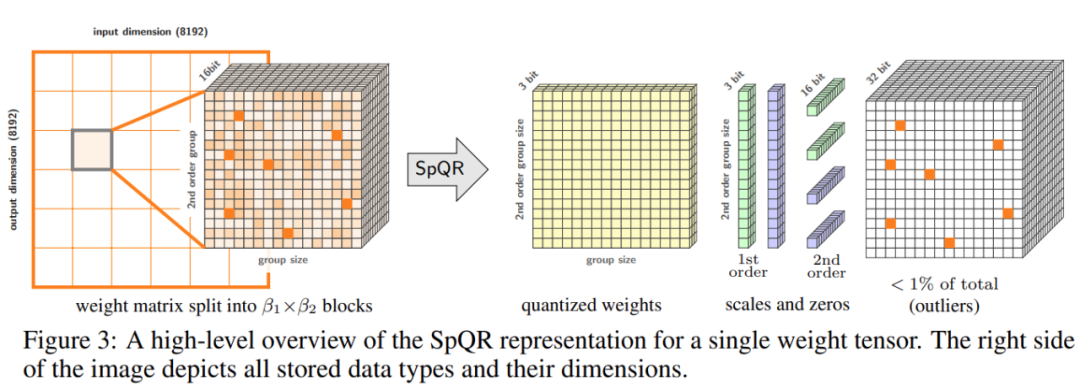
该研究对量化过程进行了两个改变:一个用于捕捉小的敏感权重组,另一个用于捕捉单个的异常值。下图 3 为 SpQR 的总体架构:
将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

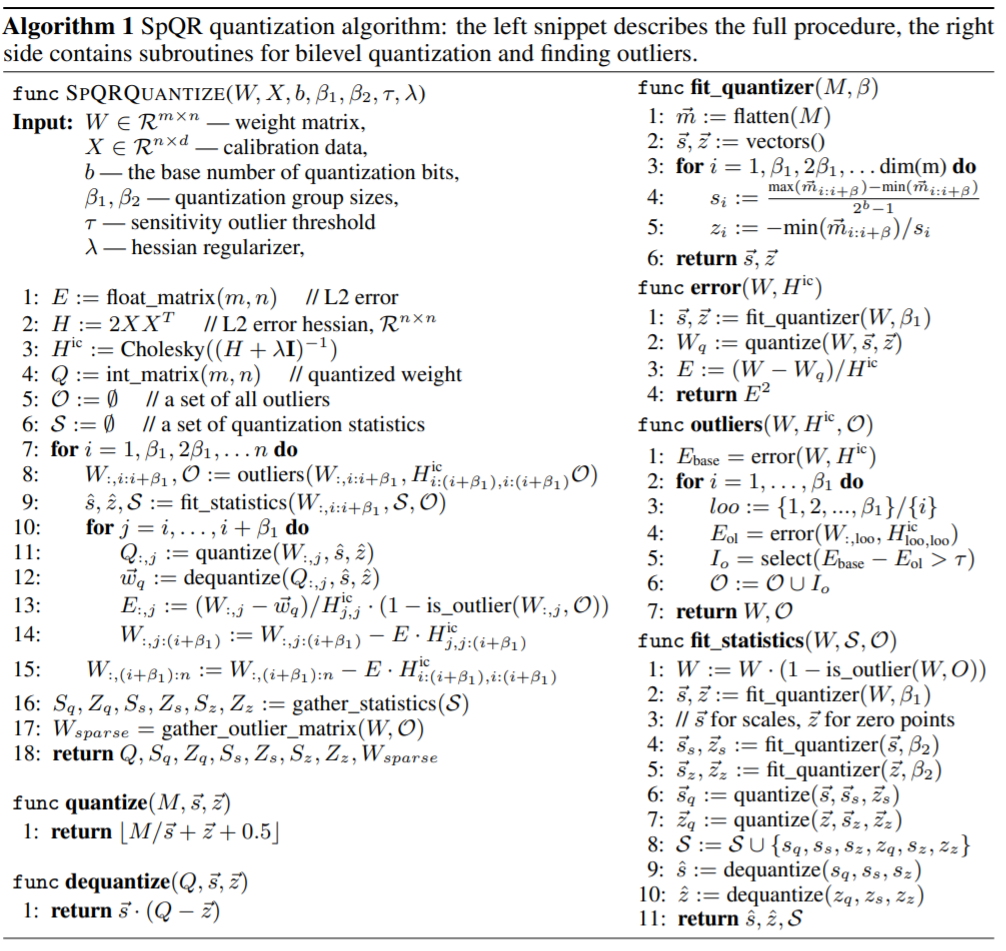
下表为 SpQR 量化算法,左边的代码片段描述了整个过程,右边的代码片段包含了二级量化和查找异常值的子程序:
将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

实验

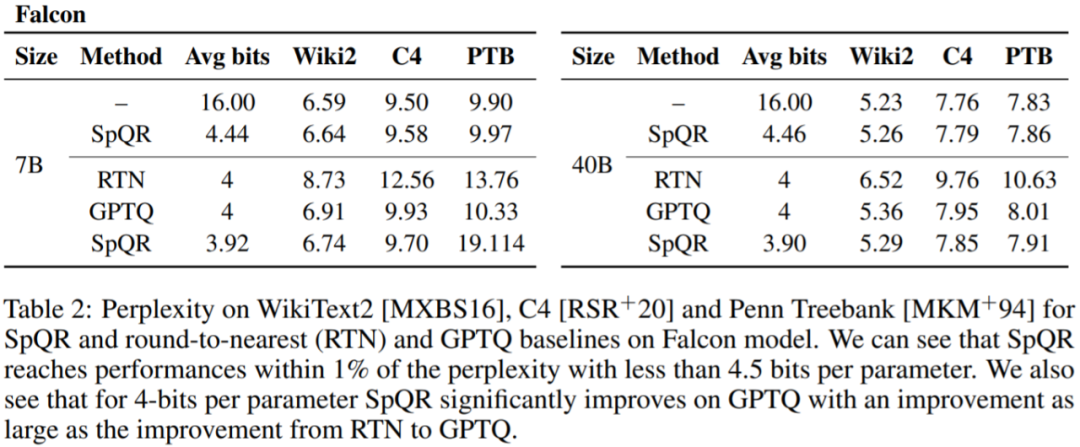
该研究将 SpQR 与其他两种量化方案进行了比较:GPTQ、RTN(rounding-to-nearest),并用两个指标来评估量化模型的性能。首先是困惑度的测量,所用数据集包括 WikiText2、 Penn Treebank 以及 C4;其次是在五个任务上的零样本准确率:WinoGrande、PiQA、HellaSwag、ARC-easy、ARC-challenge。

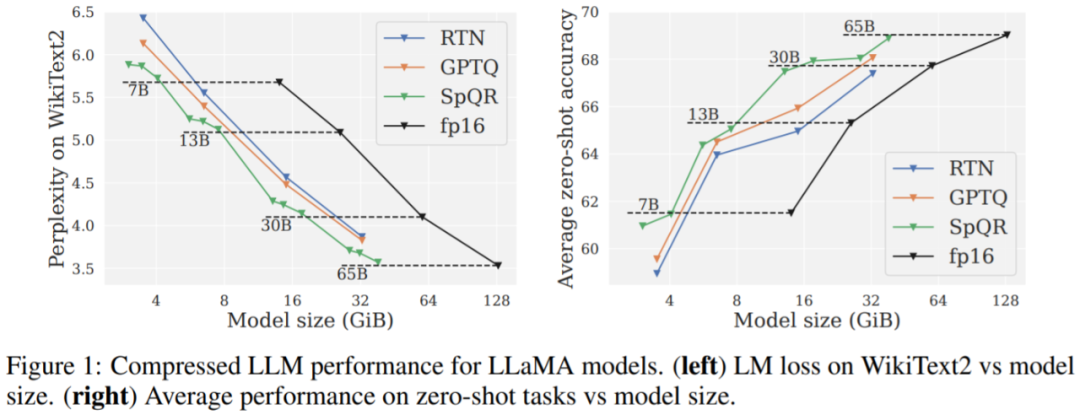
主要结果。图 1 结果显示,在相似的模型大小下,SpQR 的性能明显优于 GPTQ(以及相应的 RTN),特别是在较小的模型上。这种改进得益于 SpQR 实现了更多的压缩,同时也减少了损失退化。
将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

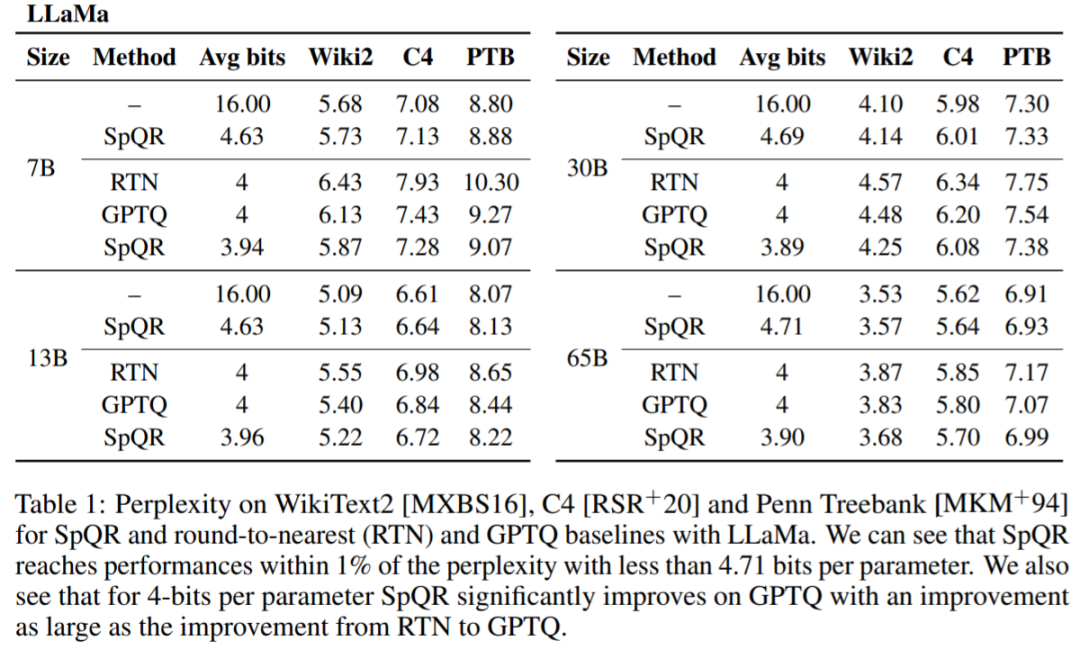
表 1、表 2 结果显示,对于 4 位量化,与 GPTQ 相比,SpQR 相对于 16 位基线的误差减半。
将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

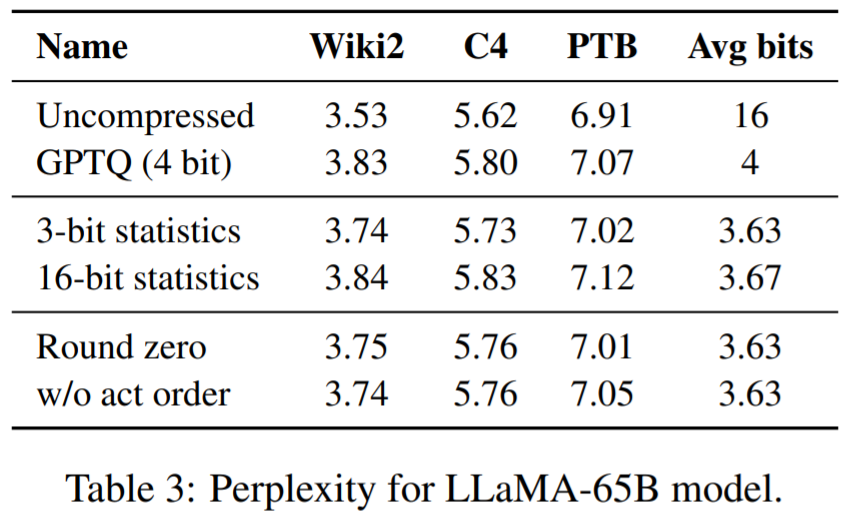
表 3 报告了 LLaMA-65B 模型在不同数据集上的困惑度结果。

将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

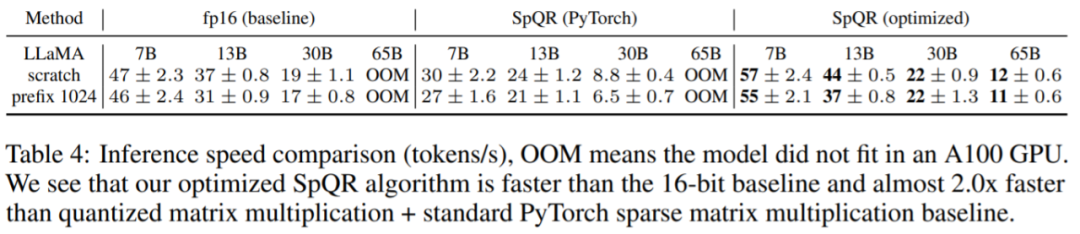
最后,该研究评估了 SpQR 推理速度。该研究将专门设计的稀疏矩阵乘法算法与 PyTorch(cuSPARSE)中实现的算法进行了比较,结果如表 4 所示。可以看到,尽管 PyTorch 中的标准稀疏矩阵乘法并没有比 16 位推理更快,但本文专门设计的稀疏矩阵乘法算法可以提高约 20-30% 的速度。
将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减

以上就是将330亿参数大模型「塞进」单个消费级GPU,加速15%、性能不减的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/527893.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
在云计算中使用 Java 框架的最佳实践
上一篇 2025年11月9日 09:04:33
相册里的照片彻底删除了怎么找回来 超全的5个方法
下一篇 2025年11月9日 09:04:42

相关推荐

  • deepseek官方社区网址_加入deepseek官方社区官网交流

    deepseek官方社区网址是https://chat.deepseek.com/,该平台提供互动交流、模型更新、技术文档、多语言支持及开源项目协作,同时支持实时对话、多终端同步与API集成。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ …

    2026年9月10日
    600
  • 样样超 Pro!感受一加 13 带来的性能与影像双重盛宴

    样样超 Pro!感受一加 13 带来的性能与影像双重盛宴样样超 Pro!感受一加 13 带来的性能与影像双重盛宴样样超 Pro!感受一加 13 带来的性能与影像双重盛宴样样超 Pro!感受一加 13 带来的性能与影像双重盛宴

    如果你追求极致的性能、顶级的屏幕显示效果、专业的影像体验,并且希望拥有一部兼具质感与实力的旗舰手机,那么一加 13 无疑是当前市场上的有力竞争者。它没有选择折叠形态,而是将所有 “pro” 级体验,浓缩在一部直板旗舰之中。 核心性能:骁龙 8 至尊版,释放极致潜能 一加 13…

    2026年9月9日 用户投稿
    000
  • Laravel如何优化数据库查询_数据库性能调优技巧

    Laravel应用中最常见的数据库性能瓶颈包括N+1查询、缺少索引、SELECT 未指定列、不合理的大事务及复杂JOIN操作。N+1问题因循环中频繁查询关联数据导致数据库负载激增,可通过Eloquent的with()预加载解决;缺少索引会使WHERE、JOIN或ORDER BY操作引发全表扫描,应为…

    2026年9月9日
    000
  • MEOW R16 Ultra 高颜驾到!异次元拼图风,主打新潮外观和旗舰性能

    8 月 27 日,七彩虹旗下年轻化潮流品牌 colorfire 正式推出 meow 系列全新旗舰机型——meow r16 ultra。作为继 meow r16 标准版与 pro 版之后的又一力作,这款新品专为追求个性与性能兼备的年轻用户打造,进一步拓展品牌在潮流游戏本领域的影响力。 MEOW R16…

    2026年9月9日
    100
  • 特斯拉 FSD 加入大量全新渲染模型 玩滑板的人都能识别

    近日,有汽车领域博主爆料,特斯拉的fsd(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。 这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、…

    2026年9月8日
    100
  • 用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐

    用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐用慢思考提升模型安全性,北交大、鹏城实验室提出系统2对齐

    aixiv专栏:北京交通大学adam团队探索系统2对齐,提升大模型安全性 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 北京交通大学ADaM团队长期关注AI安全领域,此前已开源o1复现项目o1-Coder (https://www.php.…

    2026年9月7日 用户投稿
    000
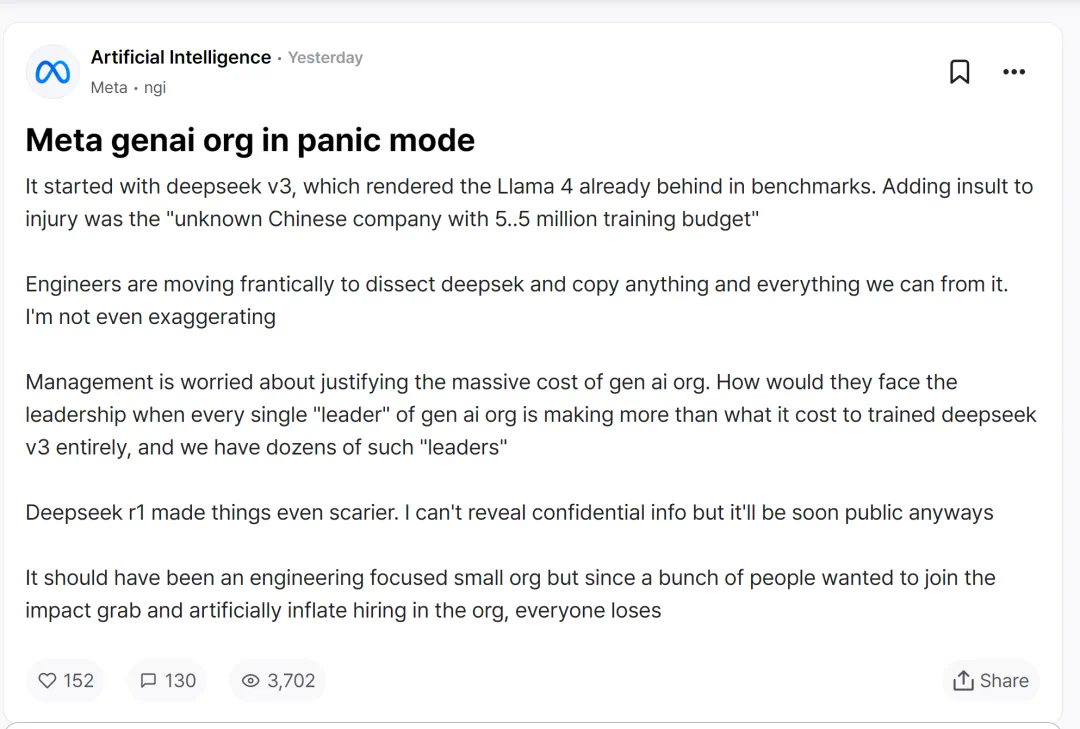
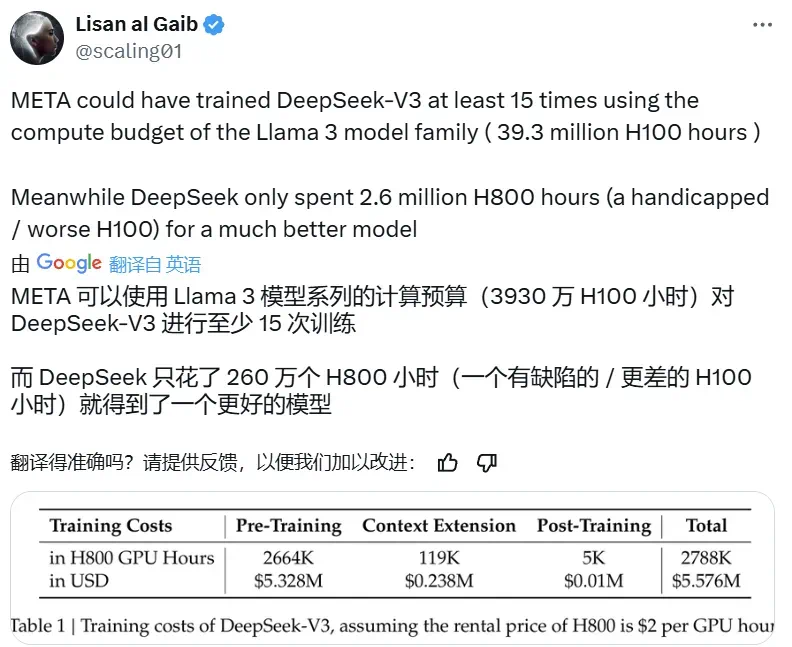
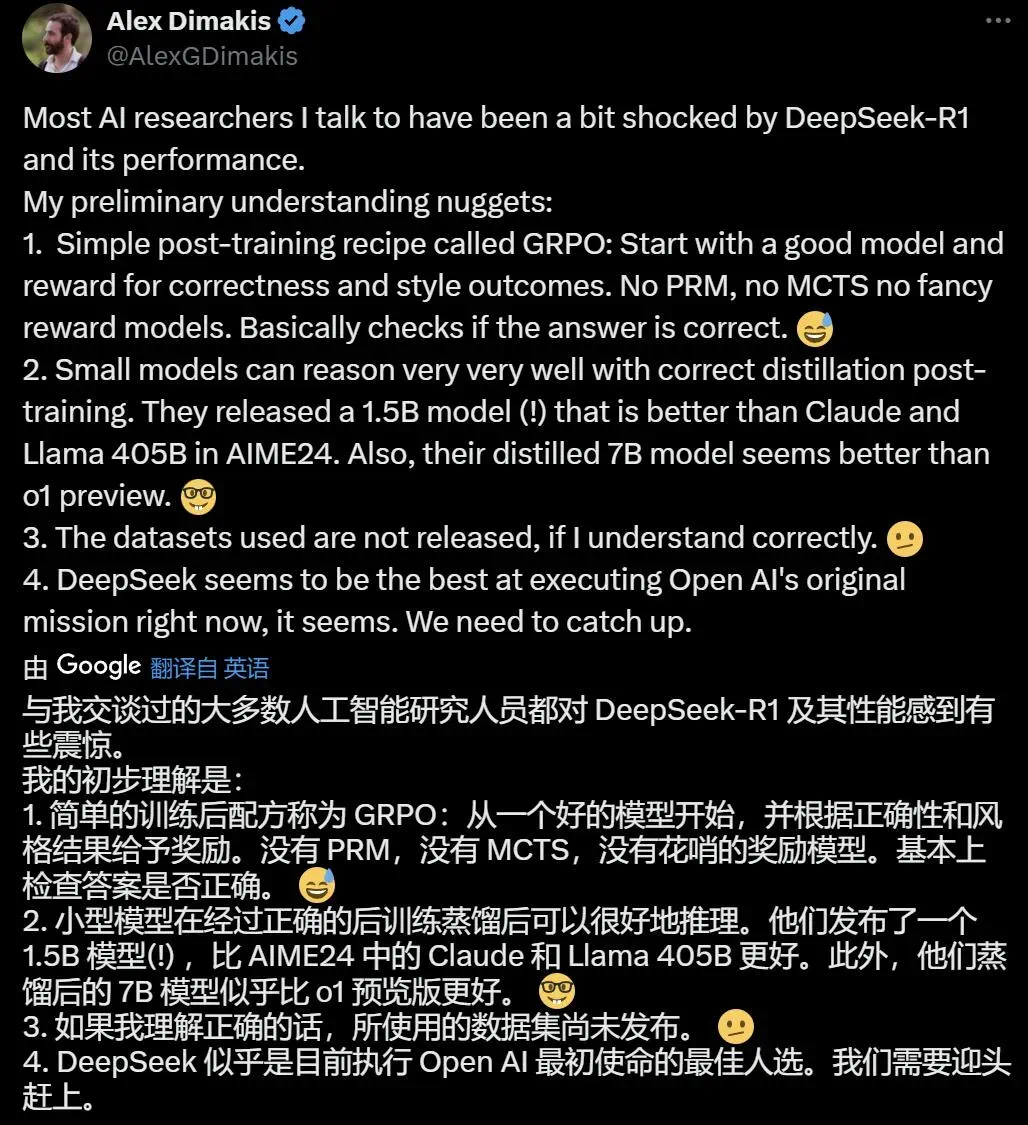
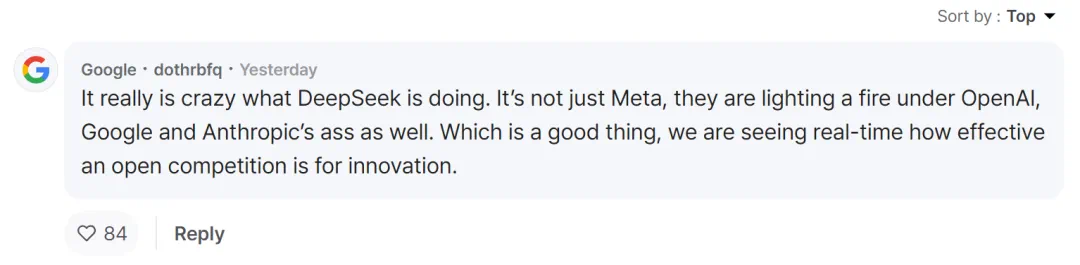
  • Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释

    Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释Meta陷入恐慌?内部爆料:在疯狂分析复制DeepSeek,高预算难以解释

    deepseek开源大模型的横空出世,引发美国ai巨头恐慌,meta首当其冲。 近期,Meta员工在Teamblind匿名论坛爆料,DeepSeek一系列低成本高性能的模型发布,让Meta生成式AI团队面临巨大压力,其高昂预算的合理性受到质疑。 爆料帖原文指出,DeepSeek-V3在基准测试中超越…

    2026年9月7日 用户投稿
    000
  • 如何优化ThinkPHP6应用程序的性能

    作为一款优秀的php框架,thinkphp6在开发web应用程序方面表现出色。然而,随着应用程序规模的增大以及用户量的不断增加,我们需要进一步优化程序的性能,以确保应用程序可以高效地运行。本文将介绍一些优化thinkphp6应用程序性能的方法。 使用缓存 对于需要频繁读取的数据,使用缓存可以大大减少…

    用户投稿 2026年9月7日
    000
  • DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录

    DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录DARWIN 1.5 来啦!材料设计通用大语言模型,刷新多项实验性质预测记录

    darwin 1.5:一款基于语言接口的材料发现与设计ai模型 材料科学的核心挑战在于高效地寻找理想的材料成分和结构。传统的计算方法,例如高通量筛选和机器学习,通常依赖于复杂的、特定任务的描述符,这些描述符难以泛化,且与真实材料特性存在偏差,限制了实际应用。为了克服这些局限,GreenDynamic…

    2026年9月6日 用户投稿
    000
  • vivox100s和x100区别:性能对比及功能解析

    vivo x100s和x100手机都是vivo手机产品线中的代表机型,它们分别代表了vivo在不同时间段内的高端技术水平,因此这两款手机在设计、性能和功能上均有一定区别。本文将从性能对比和功能解析两个方面对这两款手机进行详细比较,帮助消费者更好地选择适合自己的手机。 首先,我们来看vivo x100…

    用户投稿 2026年9月6日
    100
  • 骁龙8gen2性能媲美苹果哪一款处理器?

    骁龙8gen2性能媲美苹果哪一款处理器? 当谈到手机处理器时,骁龙和苹果的芯片往往是众多消费者关注的焦点。骁龙处理器由高通公司推出,一直以来在安卓手机市场占据着重要地位,而苹果则使用自家设计的A系列芯片,其性能一直备受称赞。最近,骁龙8gen2处理器发布,声称性能媲美苹果最新的处理器芯片,这引发了不…

    用户投稿 2026年9月5日
    000
  • Swoole如何实现高性能的数据备份

    近年来,数据备份已经成为企业信息化建设中必不可少的一个环节。随着企业业务量增大、数据量增加,传统的备份方案已经无法满足需求,因而出现了一些新的备份工具。swoole是一种基于php语言的高性能网络通信框架,其主要用于实现服务器应用程序。本文将介绍如何利用swoole实现高性能的数据备份。 一、备份数…

    用户投稿 2026年9月5日
    100
  • 致敬DeepSeek:以国产GPU为基,燎原中国AI生态之火

    deepseek开源模型(v3、r1系列等)在多语言理解和复杂推理任务中表现出色,极大促进了ai技术发展,为开发者提供了重要资源。deepseek不仅技术领先,更积极回馈开源社区。 摩尔线程高效部署DeepSeek 国产GPU创新企业摩尔线程已高效部署DeepSeek蒸馏模型推理服务,助力开发者基于…

    2026年9月5日
    400
  • Laravel中的缓存管理和性能优化:提升应用程序的响应速度

    Laravel中的缓存管理和性能优化:提升应用程序的响应速度 引言:在开发Web应用程序时,性能是一个非常重要的考虑因素。用户对于快速响应的期待越来越高,因此,如何优化应用程序的性能就显得尤为重要。Laravel是一个流行的PHP框架,提供了许多能够加速应用程序的缓存管理工具和技术。本文将介绍Lar…

    2026年9月4日
    100
  • 为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家

    为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家为了让DeepSeek-R1用起来更顺畅,火山引擎将TPM上调到了500万!全网首家

    deepseek风靡一时,但并非人人可用。 众多ai云服务商抓住机遇,纷纷上线deepseek模型,并推出优惠活动吸引用户。然而,免费token往往难以顺利调用deepseek-r1,可用性堪忧。 这凸显了选择可靠大厂的重要性。 火山引擎上线DeepSeek-R1模型(含完整版及蒸馏版),并赠送50…

    2026年9月2日 用户投稿
    100
  • 苹果选择通义,肯定阿里的同时,也否定了阿里

    苹果ai订单尘埃落定:阿里通义千问胜出,生态安全成关键 历时两年的苹果AI订单争夺战最终以阿里巴巴胜出告终。2月11日消息,苹果已选择阿里巴巴为中国版iPhone开发人工智能功能。 自2023年起,苹果便在测试多家中国AI模型,竞争者包括百度、字节跳动等巨头,以及百川智能、月之暗面和DeepSeek…

    2026年9月1日
    000
  • 撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开

    撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开撞车DeepSeek NSA,Kimi杨植麟署名的新注意力架构MoBA发布,代码也公开

    月之暗面发布moba注意力机制,高效处理超长文本!近日,月之暗面团队公开了一种名为moba(mixture of block attention,块注意力混合)的全新注意力机制,该机制巧妙地将混合专家(moe)原理应用于注意力机制,并在长文本处理方面展现出显著优势。这与deepseek同期发布的ns…

    2026年8月31日 用户投稿
    200
  • 解码Laravel性能瓶颈:优化技巧全面揭秘!

    解码Laravel性能瓶颈:优化技巧全面揭秘! Laravel作为一款流行的PHP框架,为开发者提供了丰富的功能和便捷的开发体验。然而,随着项目规模增大和访问量增加,我们可能会面临性能瓶颈的挑战。本文将深入探讨Laravel性能优化的技巧,帮助开发者发现并解决潜在的性能问题。 一、数据库查询优化 使…

    2026年8月31日
    400
  • 酷睿 Ultra 9 搭配 RTX 4070 顶配 ROG 幻 Air 专业性能轻薄本首发开售

    酷睿 Ultra 9 搭配 RTX 4070 顶配 ROG 幻 Air 专业性能轻薄本首发开售酷睿 Ultra 9 搭配 RTX 4070 顶配 ROG 幻 Air 专业性能轻薄本首发开售酷睿 Ultra 9 搭配 RTX 4070 顶配 ROG 幻 Air 专业性能轻薄本首发开售酷睿 Ultra 9 搭配 RTX 4070 顶配 ROG 幻 Air 专业性能轻薄本首发开售

    最近,笔记本行业不断涌现高性能轻薄本,各大品牌之间展开新一轮竞争。对消费者而言,高性能轻薄本恰到好处地结合了性能与便携性,突显了用户对笔记本的极致需求。 在这其中,以 ROG 幻 Air 为代表的专业性能轻薄本率先拉开帷幕。据悉,此次 ROG 带来幻 16 Air 和幻 14 Air 两款产品,分别…

    2026年8月31日 用户投稿
    100
  • 流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示

    流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示流畅阅读— 开源AI浏览器翻译插件,支持双语对照显示

    fluentread:你的浏览器翻译利器,助你畅享无障碍阅读体验! FluentRead是一款开源浏览器翻译插件,它利用先进的AI技术,旨在为你提供如同母语般流畅的阅读体验。支持多种翻译引擎,包括传统的机器翻译和强大的AI大模型,并且允许你自定义翻译服务。其核心功能包含智能翻译、便捷的双语对照显示以…

    2026年8月29日 用户投稿
    200

发表回复

登录后才能评论
关注微信