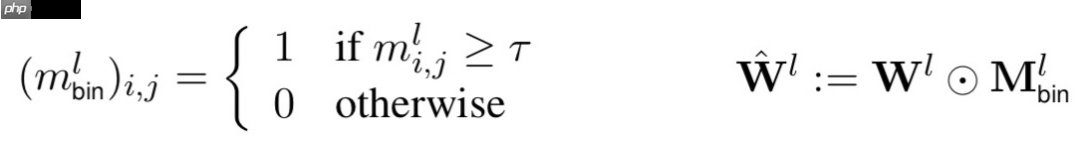NLP中的绿色Finetune方法

在自然语言处理(nlp)领域,利用预训练的大型模型进行微调(finetune)已成为解决各种任务的常见方法。通过对bert、gpt等在海量文本上预训练的模型在下游任务上进行微调,可以得到针对特定任务的模型。然而,这种方法的成本不容忽视,因为需要为每个任务保存一个完整的特定任务模型,随着预训练模型规模的增大,存储空间的需求也随之增加。此外,为每个任务微调如此庞大的模型,还会消耗大量的训练资源。

为了实现更加环保和经济的NLP预训练模型迁移,近年来业界提出了多种优化微调的方法,如adapter微调、mask微调等。最近颇为流行的prompt技术甚至能够在不进行微调的情况下应用于下游任务。本文将重点介绍近两年在NLP领域中几种经典的微调优化工作,包括adapter-tuning、side-tuning、mask-tuning以及prefix-tuning等。

Adapter-tuning

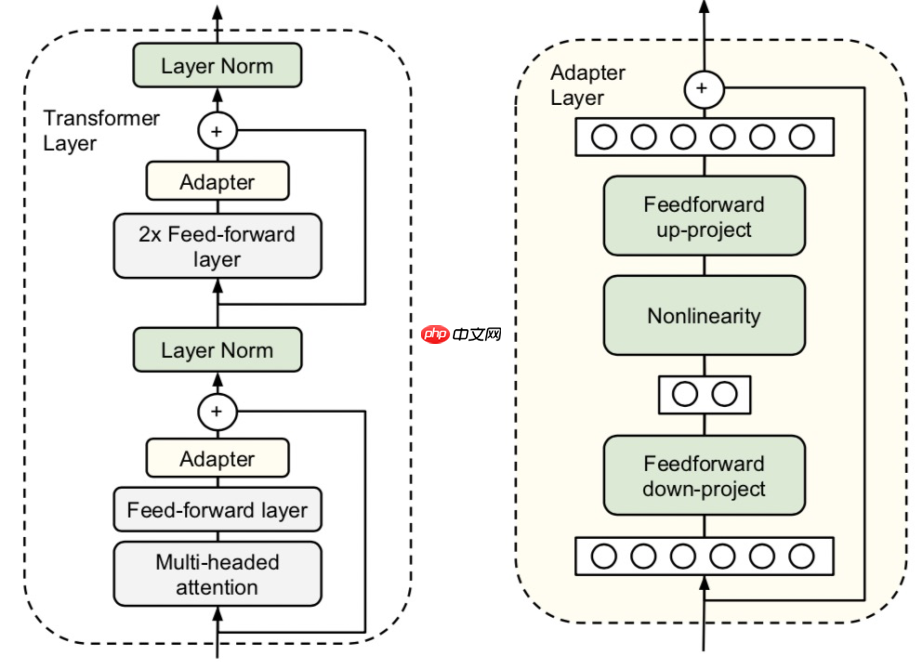
在迁移NLP预训练模型的方法中,主要分为微调(finetune)和基于特征的方法(feature-based)。微调方法是对原模型在下游任务上进行训练,而基于特征的方法则是使用预训练模型生成的词或句子嵌入作为输入,连接到下游的独立模型进行预测。通常情况下,微调的效果优于基于特征的方法,但其计算开销也更大。Parameter-Efficient Transfer Learning for NLP(ICML 2019)提出了一种更经济的迁移学习方法,即adapter-tuning。这种方法只需微调少量参数就能达到与微调整个模型相当的效果。具体做法是在Bert模型的每一层中间插入两个adapter。adapter首先通过全连接层对原始输入进行降维,减少参数量,经过内部的NN后再将维度恢复,形成一种瓶颈结构。在微调过程中,预训练的Bert模型参数被冻结(freeze),只更新adapter的参数,大大减少了微调阶段需要更新和保存的参数量。
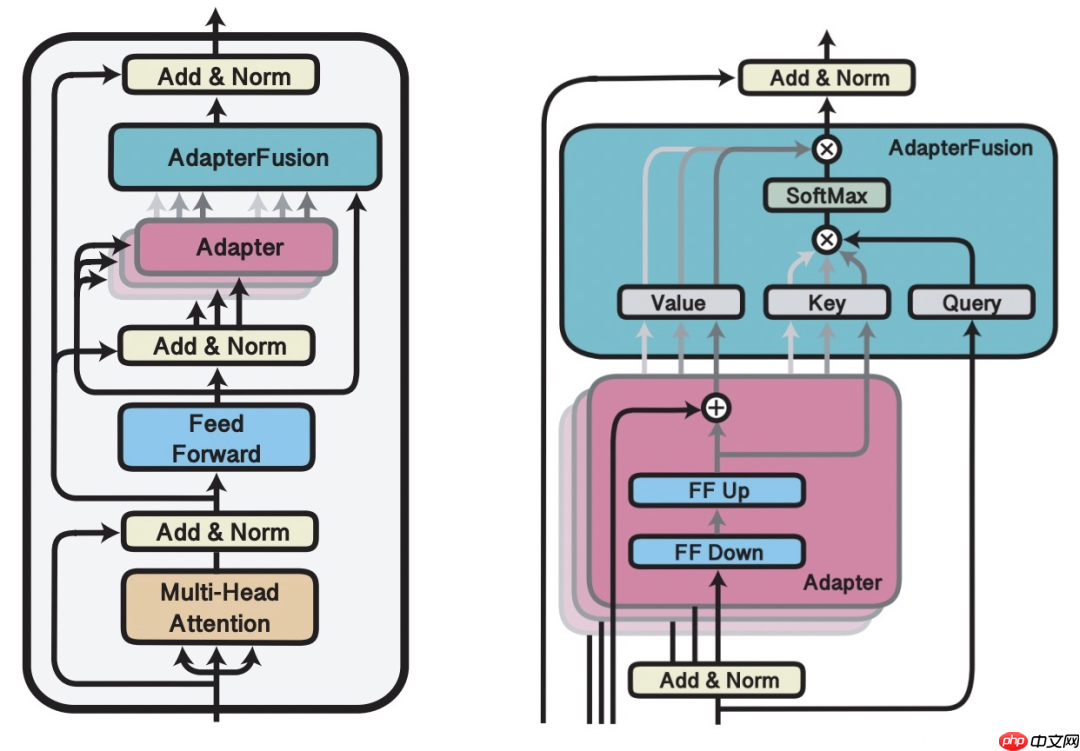
NLP中的绿色Finetune方法AdapterFusion: Non-Destructive Task Composition for Transfer Learning(2021)在Adapter Finetune的基础上,提出了一种在存在多个下游任务时使用的两阶段微调方法。第一阶段与Adapter Finetune的思路一致,在预训练的大模型基础上添加每个任务的adapter进行微调,预训练模型参数被冻结。第二阶段,继续冻结预训练模型和第一阶段训练的adapter参数,学习一个AdapterFusion模型,这个模块的作用是融合各个adapter的信息,实现下游多个任务之间的信息共享。AdapterFusion的思路是利用当前样本在FF层的输出和各个任务的adapter输出做Attention,实现从多个Adapter产出信息中的选择和融合。这样,模型能够根据每个样本选择合适的adapter输出,综合多任务的adapter信息。
NLP中的绿色Finetune方法Side-Tuning

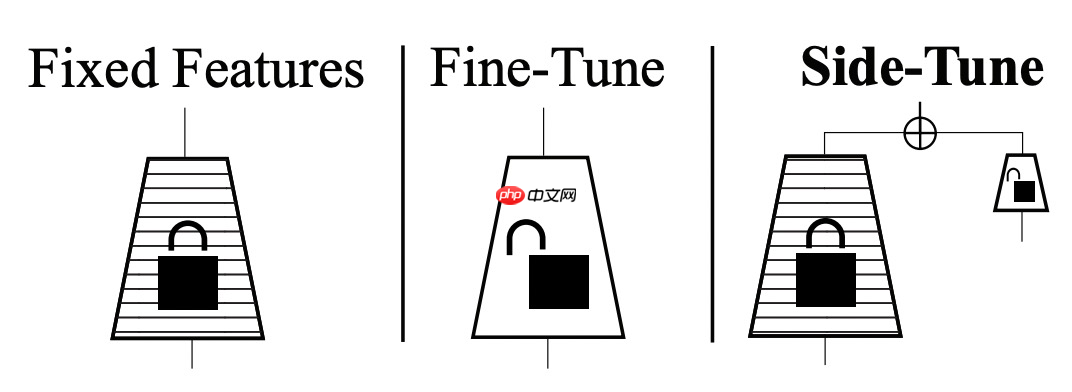
Side-tuning: A baseline for network adaptation via additive side networks(ECCV 2019)提出了一种side-tuning的方法。如下图所示,side-tuning是在原预训练模型的基础上,增加一个小的side network,然后将预训练模型的输入和side-network的输出进行融合。融合的方法是使用一个可学习的参数α进行加权融合。训练过程中,预训练模型不会被更新,只更新side-network部分的参数。Side模型的尺寸和复杂度可以根据任务的难易程度进行调整。Side-tuning与adapter-tuning有相似之处,都是通过一个附属的小模型对原预训练大模型的表示进行更精细化的调整,以适应下游任务。
NLP中的绿色Finetune方法Mask-tuning

Masking as an efficient alternative to finetuning for pretrained language models(2020)提出了一种简单的mask方法来实现高效微调。与一般的微调不同,该方法在微调阶段不调整参数,而是学习一个mask矩阵。对于每一个Transformer层,都会学习一个0-1的矩阵,然后用这个矩阵对该层的全连接权重进行缩放。公式如下,m表示矩阵中的某一个元素,根据一个阈值设置为1或0,再用这个矩阵和每层的全连接参数相乘进行对应元素的缩放。

Mask-tuning的出发点是,在预训练模型微调的过程中,其实不需要微调那么多参数,只要微调一些关键参数就能达到较好的效果,减少微调阶段计算的冗余性。在How fine can fine-tuning be? Learning efficient language models(2020)一文中也提出了类似的思路。
法语写作助手 法语写作助手

法语助手旗下的AI智能写作平台,支持语法、拼写自动纠错,一键改写、润色你的法语作文。

法语写作助手 31 查看详情 法语写作助手

NLP中的绿色Finetune方法Prefix-tuning

REFORMER: THE EFFICIENT TRANSFORMER(ICLR 2020)提出了采用局部敏感哈希的方法来提升Transformer的效率。当序列较长时,QK^T的维度[batch_size, L, L]的计算量和存储开销会非常大,但由于我们关注的是softmax后的结果,并不关注QK^T本身是什么,而softmax只关注值最大的几个元素,因此我们可以只选择k个最相关的元素进行计算。

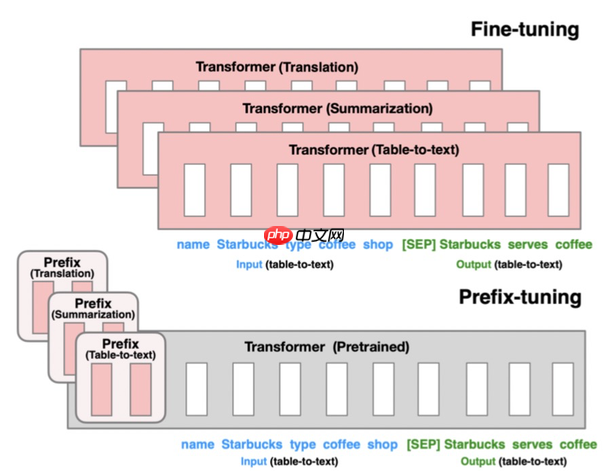
Prefix-Tuning: Optimizing Continuous Prompts for Generation(2021)提出的方法只微调0.1%的参数就能取得与微调相当的效果,并且在少样本任务上效果优于微调。本文提出了针对自然语言生成任务(如摘要生成、table-to-text等任务)的迁移预训练大模型的方法。基于Language models are few-shot learners(2020,GPT3)等文章中提出的Prompt思路,只要能给模型一个合适的上下文信息context,预训练的语言模型不需要修改参数就能很好地解决下游问题。例如,当我们想生成Obama这个词,只要上下文信息给Barack,模型就有可能生成Obama,因为模型在预训练阶段已经学到了这些信息。

该方法的具体实现是,将预训练的Transformer模型参数整体冻结(Freeze),在正常输入文本序列时,在最前端添加几个prefix id,每个prefix id都对应一个随机初始化的embedding,不同的任务有不同的prefix id。这样,在模型中,prefix之后每个时刻的表示都会受到prefix的影响,prefix代表某个对应具体任务的上下文信息。在微调过程中,模型的其他参数都被冻结,只微调prefix的embedding以及prefix后面接的一些全连接层,微调参数量只占整体模型的0.1%,远小于其他的微调方法。该方法的核心思想是利用prefix embedding去学习对于某个任务来说,需要从预训练语言模型中提取什么样的信息。
NLP中的绿色Finetune方法总结

NLP领域预训练大模型的发展,催生了许多关于如何提升迁移效率的研究工作。从目前的研究趋势来看,基于prompt思想的微调是未来的一个重要研究趋势,充分利用预训练模型的信息,让下游任务更贴近预训练模型,而不是让预训练模型贴近下游任务。后续我们也会对prompt进行更为详细的介绍。

END

如果觉得我的文章对你有帮助,请关注我吧~

以上就是NLP中的绿色Finetune方法的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/565657.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
谷歌浏览器如何一键静音所有标签页_Chrome标签页静音功能与快捷操作
上一篇 2025年11月10日 03:16:02
Python教程:寻找浮点数列表的最小公倍乘数以转换为整数
下一篇 2025年11月10日 03:16:53

相关推荐

  • VS Code工作台UI:自定义CSS与视图容器配置

    可通过扩展和配置自定义VS Code UI:1. 使用Custom CSS and JS Loader注入CSS修改外观,但有风险;2. 推荐创建Color Theme扩展,通过JSON定义主题颜色;3. 利用viewsContainers在活动栏添加自定义容器;4. 用户可设置view.locat…

    2026年9月24日
    000
  • OmniHuman-1.5— 字节推出的数字人动画生成模型

    OmniHuman-1.5— 字节推出的数字人动画生成模型OmniHuman-1.5— 字节推出的数字人动画生成模型OmniHuman-1.5— 字节推出的数字人动画生成模型OmniHuman-1.5— 字节推出的数字人动画生成模型

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 怪兽AI数字人 数字人短视频创作,数字人直播,实时驱动数字人 44 查看详情 OmniHuman-1.5是什么 omnihuman-1.5 是由字节跳动推出的一款前沿ai模型,能够基于单张静态图…

    2026年9月24日 用户投稿
    100
  • 行业首款风水双冷手机 红魔11 Pro系列真机开箱:酷炫水冷环、唯一纯平后盖

    行业首款风水双冷手机 红魔11 Pro系列真机开箱:酷炫水冷环、唯一纯平后盖行业首款风水双冷手机 红魔11 Pro系列真机开箱:酷炫水冷环、唯一纯平后盖行业首款风水双冷手机 红魔11 Pro系列真机开箱:酷炫水冷环、唯一纯平后盖行业首款风水双冷手机 红魔11 Pro系列真机开箱:酷炫水冷环、唯一纯平后盖

    10月13日,红魔正式宣布其新款旗舰手机——红魔11 pro系列将于10月17日发布,这款机型将成为全球首款融合风冷与水冷双重散热技术的智能手机。 今天,红魔游戏手机官方首次展示了红魔11 Pro系列的真机开箱画面。新机共推出四种配色方案:氘锋透明暗夜、氘锋透明银翼、暗夜骑士以及银翼战神,满足不同用…

    2026年9月24日 用户投稿
    200
  • 装机时最容易犯的错误是什么?

    忽视防静电措施会导致硬件损伤,操作前应洗手触摸金属并佩戴防静电手环;2. 主板铜柱安装错误易引发短路,需对照孔位准确安装;3. 电源接线漏插24pin或8pin供电是开机失败主因;4. 散热器安装不当致高温,硅脂应居中豌豆大小并确保扣紧。 装机时最容易犯的错误是忽略静电防护和接线混乱。这两个问题看似…

    2026年9月24日
    100
  • VSCode如何调试React前端应用 VSCode调试React组件的完整教程

    要调试react前端应用,首先需安装vscode的浏览器调试插件并配置launch.json文件,1. 安装“debugger for chrome”或对应浏览器的插件;2. 在项目根目录的.vscode文件夹中创建launch.json,配置type为chrome、request为launch、n…

    2026年9月24日
    100
  • Linux中如何安装Git工具_Linux安装Git工具的详细教程

    在Linux系统中安装Git工具是进行版本控制的第一步,尤其对于开发者来说非常关键。不同Linux发行版使用不同的包管理器,因此安装方式略有差异。下面将介绍在主流Linux系统中安装Git的详细步骤。 1. 在Ubuntu/Debian系统中安装Git Ubuntu和Debian系统使用apt作为包…

    2026年9月24日
    100
  • gpt-realtime— OpenAI最新推出的语音模型

    gpt-realtime— OpenAI最新推出的语音模型gpt-realtime— OpenAI最新推出的语音模型gpt-realtime— OpenAI最新推出的语音模型gpt-realtime— OpenAI最新推出的语音模型

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ OpenAI Codex 可以生成十多种编程语言的工作代码,基于 OpenAI GPT-3 的自然语言处理模型 57 查看详情 gpt-realtime 是什么 gpt-realtime 是 o…

    2026年9月24日 用户投稿
    100
  • VSCode如何通过Dev Containers开发 VSCode开发容器环境的搭建与使用

    vscode通过dev containers提供容器化开发环境,解决了“在我的机器上能运行”的问题。1. 安装docker并配置vscode访问;2. 安装remote – containers扩展;3. 创建.devcontainer文件夹和devcontainer.json文件;4.…

    2026年9月24日
    100
  • MACA: 一款自动注释细胞类型的工具

    前言 设计的初衷在目前的细胞类型鉴定工具中,支持向量机(SVM)的准确性超过了大多数监督注释方法。然而,由于监督注释方法在大多数单细胞数据中缺乏真实参照,因此其易用性不如非监督方法,这也是非监督方法占主流的原因之一。使用非监督方法时,需要人工介入,调整分群的分辨率,并提供标记基因,这会导致选择标记基…

    2026年9月24日
    000
  • 数据库设计原则?——规范化理论

    数据库设计原则?——规范化理论数据库设计原则?——规范化理论数据库设计原则?——规范化理论数据库设计原则?——规范化理论

    数据库设计的规范化理论旨在减少冗余、提升一致性与完整性,核心是通过1nf、2nf、3nf三级范式逐步消除数据异常。1nf要求字段具有原子性,不可再分;2nf要求非主键字段完全依赖主键,而非部分依赖;3nf进一步消除传递依赖,确保非主键字段不依赖其他非主键字段。规范化虽能提高数据可靠性,但可能导致查询…

    2026年9月24日 用户投稿
    000
  • VSCode如何分屏和布局管理 VSCode多窗口编辑的高效方式

    vscode多窗口编辑的快捷键和技巧包括:1. 垂直分屏使用 ctrl+(macos为 cmd+);2. 水平分屏使用 ctrl+k v(macos为 cmd+k v)或通过菜单选择上下拆分;3. 拖拽文件标签或从侧边栏拖文件至边缘可智能创建新分屏;4. 右键“在新组中打开”可快速并排查看文件;5.…

    2026年9月24日
    100
  • 深入理解 javac 命令中的 ‘当前目录’ 与类路径

    在使用 javac 命令进行 Java 编译时,’当前目录’ 指的是执行该命令时所在的目录,而非源代码文件或 Java 安装路径所在的目录。这对于默认类路径(.)的解析至关重要,影响编译器查找依赖类文件的位置。理解这一概念有助于避免编译错误,并正确配置类路径。 什么是“当前目…

    2026年9月24日
    100
  • 如何监控Linux进程内存泄漏 pmap与valgrind工具使用

    如何监控Linux进程内存泄漏 pmap与valgrind工具使用如何监控Linux进程内存泄漏 pmap与valgrind工具使用如何监控Linux进程内存泄漏 pmap与valgrind工具使用如何监控Linux进程内存泄漏 pmap与valgrind工具使用

    要监控linux进程的内存泄漏,首先使用pmap观察内存增长趋势,再用valgrind定位具体泄漏点。一、使用pmap -x 查看进程内存映射,重点关注anon列和总内存变化,通过定期刷新判断是否存在异常增长;二、利用valgrind –leak-check=full启动程序,分析报告中…

    2026年9月24日 用户投稿
    100
  • 华为Mate系列摄像头如何设置以优化动态摄影?动态拍摄调整指南

    华为Mate系列摄像头如何设置以优化动态摄影?动态拍摄调整指南华为Mate系列摄像头如何设置以优化动态摄影?动态拍摄调整指南华为Mate系列摄像头如何设置以优化动态摄影?动态拍摄调整指南华为Mate系列摄像头如何设置以优化动态摄影?动态拍摄调整指南

    答案是掌握专业模式下的快门速度、ISO和对焦设置,并结合AI辅助与防抖技术。具体而言,拍摄动态场景时应优先选择高速快门(如1/500秒以上)以凝固瞬间,配合AF-C连续对焦与追焦技巧确保主体清晰;在光线不足时适当提升ISO,但需权衡噪点与模糊的取舍;创造运动模糊效果则需降低快门速度(如1/30秒),…

    2026年9月24日 用户投稿
    400
  • mysql中是什么意思 mysql语法符号含义解析

    mysql 中的符号和关键字是与数据库交互的基本工具,正确使用它们可以提高工作效率和查询准确性。1. 逗号(,)用于分隔列表中的元素,如列名和值。2. 点号(.)用于访问表中的列或调用函数。3. 星号(*)用于选择所有列,但应避免使用以提高查询性能。4. 百分号(%)用于 like 操作中的模式匹配…

    2026年9月24日
    100
  • Spring Boot 测试中 403 错误排查与安全配置优化

    本文旨在解决 Spring Boot 控制器层测试中常见的 403 Forbidden 错误,特别是当安全配置限制了访问权限时。文章将深入分析 WebSecurityConfig 和 @WithMockUser 的使用,提供两种主要解决方案:通过临时放松安全限制进行测试,以及确保角色/权限配置的正确…

    2026年9月24日
    100
  • MAC怎么把App的语言单独设置成中文或英文_MAC单独设置App语言方法

    可通过终端命令临时设置或修改应用Info.plist文件永久更改macOS单个应用语言,支持中英文切换,不影响系统语言。 如果您希望在 macOS 系统中将某个应用程序的语言单独设置为中文或英文,而不影响系统整体语言,可以通过修改应用的本地化偏好来实现。此方法适用于支持多语言且遵循 macOS 本地…

    2026年9月24日
    000
  • 显卡降噪散热测试:七款RTX 4080非公版显卡谁更安静?

    选择RTX 4080显卡时,在性能相近的情况下,散热与噪音成为关键考量。1. 散热模组决定温度与风扇转速,进而影响噪音水平;2. 三风扇设计、大面积均热板及多热管(如6mm×8根)能有效提升散热效率;3. 七彩虹水神(Neptune)等一体水冷型号静音表现顶尖,高负载下亦可近乎无声;4. 映众冰龙、…

    2026年9月24日
    000
  • DeepCode— 港大实验室推出的多Agent代码生成平台

    DeepCode— 港大实验室推出的多Agent代码生成平台DeepCode— 港大实验室推出的多Agent代码生成平台DeepCode— 港大实验室推出的多Agent代码生成平台DeepCode— 港大实验室推出的多Agent代码生成平台

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ MiniMax Agent MiniMax平台推出的Agent智能体助手 334 查看详情 DeepCode是什么 deepcode是由香港大学数据智能实验室研发的一款基于多智能体架构的智能代码…

    2026年9月24日 用户投稿
    200
  • 时区错误怎样校准?时间同步完整解决方法

    时区错误怎样校准?时间同步完整解决方法时区错误怎样校准?时间同步完整解决方法时区错误怎样校准?时间同步完整解决方法时区错误怎样校准?时间同步完整解决方法

    时区错误和时间同步问题通常由系统时区设置错误、硬件时钟漂移或ntp服务异常导致。1.确保系统时间通过ntp服务准确同步,linux可使用timedatectl检查ntp状态并启用systemd-timesyncd或chronyd,windows则开启自动时间同步;2.正确设置本地时区,linux使用…

    2026年9月24日 用户投稿
    200

发表回复

登录后才能评论
关注微信