本文介绍从零实现深度学习框架的思路,受飞桨框架学习活动及相关书籍启发。先解释深度学习框架是能自动求导的库,接着说明通过构建计算图实现,包含节点类设计及前向、反向传播逻辑,还以吃鸡排名预测挑战赛为例,展示用该简易框架处理数据、构建网络、训练和预测的过程。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
从零实现深度学习框架
飞桨框架学习(LearnDL)是一个由Mr. Sun发起的活动,主旨在于以简单易懂的方式了解深度学习框架、构造深度学习框架乃至于改写深度学习框架。整体内容包括了入门级的名词解释乃至后续的框架实现工作,推荐新入门深度学习、对神经网络有些困惑、不知道如何给Paddle提PR、不知道如何参加黑客松、觉得平台上的交流充满“黑话”的同学一起参与学习~
本项目受启发于上述活动以及书目用Python实现深度学习框架,通过名词解释+代码的方式简要介绍深度学习/深度学习框架中的一些基础概念和一个简单的实现~
强烈推荐大家看上面那本书,对于新手入门很不错~
什么是深度学习框架
深度学习框架本质可以看作一个库,或者称之为包,或者是一个简单的写满了函数声明的py文件,其核心在于用户(调包侠)可以通过调用其中的函数轻松完成深度学习模型(神经网络)的创建和训练工作。其中,PaddlePaddle就是一个深度学习框架。
立即进入“豆包AI人工智官网入口”;
立即学习“豆包AI人工智能在线问答入口”;
更具体来说,如果不使用深度学习框架,用户需要自行编写模型训练中的求导和梯度反馈逻辑;使用了深度学习框架,用户只需要构造模型结构,而不需要去了解这个模型要怎么进行求导和梯度反馈。以一个简单的函数为例:y=tan(gsin(kxcos(x2hlnx)))y=tan(gsin(kxcos(hlnxx2))),其中xx是输入变量,k,g,hk,g,h是待拟合的参数,yy是输出结果。在不使用深度学习框架的时候,我们需要手动设计方案求出k,g,hk,g,h的导数(也称梯度),从而完成参数拟合;使用了深度学习框架后,我们只需要告诉框架有这么一个公式,框架会自动进行梯度计算,给我们省下很多功夫~
如何实现深度学习框架
根据上一章节,实现深度学习框架的方法非常简单:写一个包含了很多好用的函数定义的py文件即可。
我们可以手动的在上述py文件中写tanxtanx、tantanxtantanx、tantantanxtantantanx的导数,但我们没办法通过硬代码(即手动)的方式,把世界上所有的函数的导数都写进来。因此,我们需要一个好用的底层设计,从而保证我们能够通过少量的代码满足框架用户丰富的需求。
为此,我们引入“计算图”的概念。
计算图
计算图是一个深度学习框架的底层设计,但实际上这个词指的就是流程图或者数据图。图中的节点是一个数据单元/运算单元,节点之间的连线指运算关联关系。下图就是一个计算图,描述了输入x1,x2,x3经过一系列计算,得到计算结果,最终和标签y求均方损失(MSE)的过程。
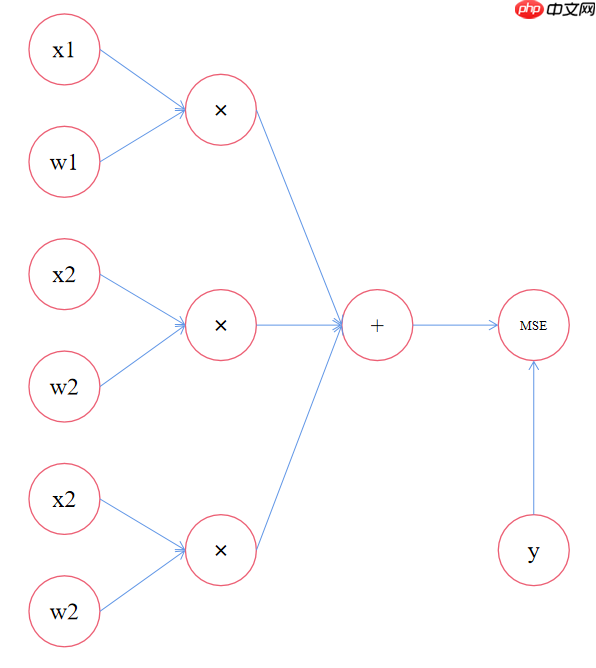
方便起见,我们不妨要求我们的所有运算都是一元或者二元运算,永远不会出现多元运算。即使出现了多元运算,我们也可以通过拆分的方式的变成二元运算的组合。以上图为例,对加法进行拆分可以得到下图
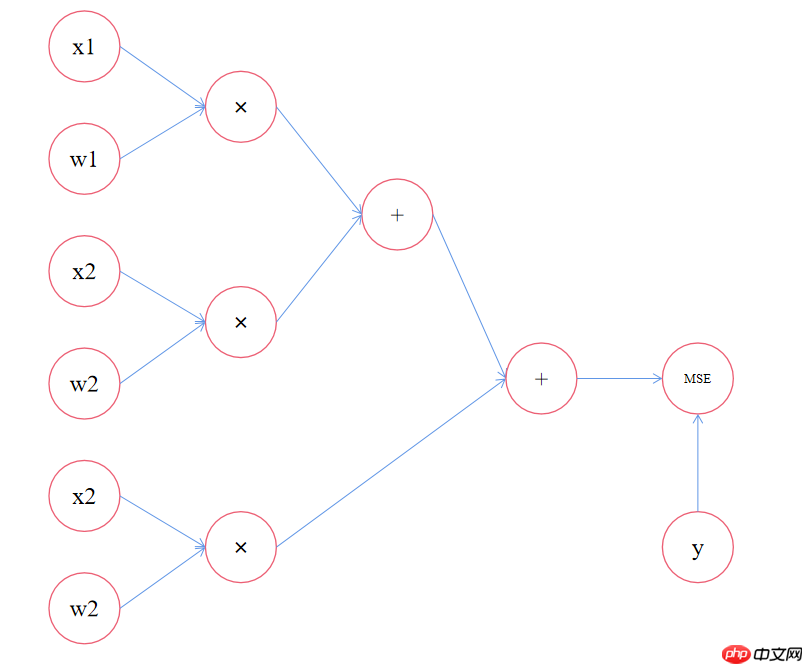
同理,tantantanxtantantanx也可以拆分为三个tantan的组合。总而言之,我们现在只需要专注于简单的一元运算或者二元运算即可。对多元运算的支持(拆分机制)可以以后再讨论。
以图为例,所有的节点都有至多两个输入和一个输出以及一个特殊的计算流程。比如”+”的运算是相加,”×”的运算是相乘。那么所有的节点都可以属于同一个类,这个类的成员(不妨把函数也称之为成员)包括:
父节点:比如x1和w1就是乘的父节点,如果这个节点是根节点,例如x1没有父节点,直接记作None值:每个节点都具有一个值计算:每个节点根据父节点的计算流程
下面简单实现一下~
In [1]
class Node(object): def __init__(self, Papa = None, Mama = None, Value = 0): # 通常使用Father表示父节点,这里使用Papa和Mama纯粹因为更有趣一些 self.Papa = Papa self.Mama = Mama self.value = Value def forward(self): self.value = self.value
上述构造了一个基础的节点类,其forward是一个恒等映射,下面分别派生对应的加法节点,乘法节点,和MSE节点
In [2]
# 加法节点class AddNode(Node): def forward(self): if self.Papa != None: self.Papa.forward() # 基础节点的父节点不需要计算,但是非基础节点的父节点需要保证有值 if self.Mama != None: self.Mama.forward() self.value = self.Papa.value + self.Mama.value# 乘法节点class MulNode(Node): def forward(self): if self.Papa != None: self.Papa.forward() if self.Mama != None: self.Mama.forward() self.value = self.Papa.value * self.Mama.value# 损失函数节点class MSENode(Node): def forward(self): if self.Papa != None: self.Papa.forward() if self.Mama != None: self.Mama.forward() self.value = (self.Papa.value - self.Mama.value)**2
只需要对上述几个Node节点进行线性组合,即可完成一次前向计算。
In [3]
x1 = Node(Value = 1)x2 = Node(Value = 2)x3 = Node(Value = 3)w1 = Node(Value = 1)w2 = Node(Value = 1)w3 = Node(Value = 1)m1 = MulNode(Papa = x1, Mama = w1)m2 = MulNode(Papa = x2, Mama = w2)m3 = MulNode(Papa = x3, Mama = w3)a1 = AddNode(Papa = m1, Mama = m2)a2 = AddNode(Papa = a1, Mama = m3)y = Node(Value = 6) # 1+2+3 = 6, 这样MSE的结果为0result = MSENode(Papa = a2, Mama = y, Value = 20)print('计算前 result.value = ', result.value)result.forward()print('计算后 result.value = ', result.value)
计算前 result.value = 20计算后 result.value = 0
可以看到,当对基础内容定义完毕后,用户只需要专注于提供节点和连接关系即可。就像是我们使用Paddle时只需要继承nn.layer后,专注于构造不同的块(Linear,Conv)的连接关系。
梯度反馈
计算图不仅可以用于计算前向过程,还可以用于计算梯度反馈。还是以刚才的内容为例,每个子节点都非常了解自己能够给父节点提供多大的梯度。比如m1相对于x1的梯度是w1,相对于w1的梯度是x1。这个信息对于x1和w1来说是未知的,因此我们要求网络计算后进行 反向传播。
简单来说,子节点还需要增加一些属性:
父节点的梯度从子节点收到的梯度
更进一步,当我们收到梯度后,还需要对梯度进行学习,即改变参数,那么我们还需要三个属性:
参数指示符:如果为True表明当前的参数是需要随着梯度进行更新的,例如w1的指示符就是True,x1就是False梯度更新函数学习率:梯度只是一个方向,并不能告诉我们应该在这个方向上走多远
结合以上几点,对上述Node类进行改写如下
In [4]
class Node(object): def __init__(self, Papa = None, Mama = None, Value = 0, Flag = 0, lr = 0.01): # 通常使用Father表示父节点,这里使用Papa和Mama纯粹因为更有趣一些 self.Papa = Papa self.Mama = Mama self.value = Value self.Flag = Flag self.Papa_grad = 0 self.Mama_grad = 0 self.grad = 1 self.lr = lr def updata(self): # 参数更新 if self.Flag == 1: self.value = self.value - self.lr*self.grad def forward(self): self.value = self.value def backward(self): self.updata()# 加法节点class AddNode(Node): def forward(self): if self.Papa != None: self.Papa.forward() # 基础节点的父节点不需要计算,但是非基础节点的父节点需要保证有值 if self.Mama != None: self.Mama.forward() self.value = self.Papa.value + self.Mama.value def backward(self): if self.Papa != None: self.Papa.grad = self.grad * 1 self.Papa.backward() if self.Mama != None: self.Mama.grad = self.grad * 1 self.Mama.backward() self.updata()# 乘法节点class MulNode(Node): def forward(self): if self.Papa != None: self.Papa.forward() if self.Mama != None: self.Mama.forward() self.value = self.Papa.value * self.Mama.value def backward(self): if self.Papa != None: self.Papa.grad = self.grad * self.Mama.value self.Papa.backward() if self.Mama != None: self.Mama.grad = self.grad * self.Papa.value self.Mama.backward() self.updata()# 损失函数节点class MSENode(Node): def forward(self): if self.Papa != None: self.Papa.forward() if self.Mama != None: self.Mama.forward() self.value = (self.Papa.value - self.Mama.value)**2 def backward(self): if self.Papa != None: self.Papa.grad = self.grad * 2 * (self.Papa.value - self.Mama.value) * 1 self.Papa.backward() if self.Mama != None: self.Mama.grad = self.grad * 2 * (self.Papa.value - self.Mama.value) * -1 self.Mama.backward() self.updata()
下面改一下x1的初始值,看看w1会发生什么变化
In [5]
x1 = Node(Value = 1.1) # 给一点小小的扰动x2 = Node(Value = 2)x3 = Node(Value = 3)w1 = Node(Value = 1, Flag=1)w2 = Node(Value = 1, Flag=1)w3 = Node(Value = 1, Flag=1)m1 = MulNode(Papa = x1, Mama = w1)m2 = MulNode(Papa = x2, Mama = w2)m3 = MulNode(Papa = x3, Mama = w3)a1 = AddNode(Papa = m1, Mama = m2)a2 = AddNode(Papa = a1, Mama = m3)y = Node(Value = 6) # 1+2+3 = 6, 这样MSE的结果为0result = MSENode(Papa = a2, Mama = y, Value = 20)print('计算前 result.value = ', result.value)result.forward()print('计算后 result.value = ', result.value)result.backward()print('第一次更新后 w1.value = ', w1.value)result.forward()print('第一次更新后 result.value = ', result.value)result.backward()print('第二次更新后 w1.value = ', w1.value)result.forward()print('第二次更新后 result.value = ', result.value)result.backward()print('第三次更新后 w1.value = ', w1.value)result.forward()print('第三次更新后 result.value = ', result.value)result.backward()print('第四次更新后 w1.value = ', w1.value)result.forward()print('第四次更新后 result.value = ', result.value)
计算前 result.value = 20计算后 result.value = 0.009999999999999929第一次更新后 w1.value = 0.9978第一次更新后 result.value = 0.005123696399999996第二次更新后 w1.value = 0.99622524第二次更新后 result.value = 0.002625226479937307第三次更新后 w1.value = 0.995098026792第三次更新后 result.value = 0.00134508634644392第四次更新后 w1.value = 0.9942911675777136第四次更新后 result.value = 0.0006891814070964006
可以看到搭建的网络确实能够随着不断迭代贴近目标值~
基于飞桨常规赛的框架实战
飞桨学习赛:吃鸡排名预测挑战赛是一个回归问题比赛,不妨以这个问题为基础,构造一个最为简单的全连接层模型,并且提交赛题~
框架封装
最为简单的封装方式就是构造一个py文件,将上面的类定义放进去就行。用户就可以通过import的方式使用我们提供的接口了。我们不妨给框架起名叫OurDL(Our Deep Learning),那么只需要建立一个py文件,起名为OurDL.py,再将几个节点类的声明复制粘贴就行。
数据预处理
虽然我们已经有了一个深度学习框架,但是进行深度学习还需要有数据。下面简单展示数据处理的逻辑。
In [ ]
# 提取压缩包! unzip /home/aistudio/data/data137263/pubg_train.csv.zip! unzip /home/aistudio/data/data137263/pubg_test.csv.zip
In [1]
import pandas as pd# 读取数据df = pd.read_csv('pubg_train.csv')# 方便起见,直接丢弃具有Nan信息的行和列df = df.dropna(axis = 0, how = 'any')# 提取需要的特征信息# 部分列属性,比如match_id 和 team_id 对我们这个简单的模型来说没啥用data = df.iloc[:,2:].valuesmax_value = data.max(axis = 0)# 简单归一化data = data / max_valueprint(data.shape)
(635716, 14)
构造网络
因为数据一共有14个维度,其中一个维度是目标值,所以我们需要构造一个13到1的全连接层。如下构造网络后,我们只需要配置输入数据后调用result.forward()即可完成推理,推理后调用result.backward()即可完成梯度更新。
In [2]
from OurDL import *x = [] # 数据输入节点w = [] # 参数节点m = [] # 乘法节点a = [] # 加法节点for i in range(13): x.append(Node()) w.append(Node(Flag=1))for i in range(13): m.append(MulNode(Papa = x[i], Mama = w[i]))for i in range(12): if i == 0: a.append(AddNode(Papa = m[0], Mama = m[1])) else: a.append(AddNode(Papa = a[i-1], Mama = m[i+1]))y = Node()result = MSENode(Papa = a[11], Mama = y)
训练
In [3]
max_epochs = 1now_step = 0for epoch in range(max_epochs): for sample in data: # 填充输入数据 for i in range(13): x[i].value = sample[i] y.value = sample[-1] result.forward() result.backward() now_step = now_step + 1 print('rEpoch:{}/{}, Step:{}'.format(epoch,max_epochs,now_step),end="")
Epoch:0/1, Step:635716
训练后可以简单查看一下模型学习到的参数内容
In [8]
for i in range(13): print('第{}个参数的系数w{}是{}'.format(i,i,w[i].value))
第0个参数的系数w0是0.49341314151790766第1个参数的系数w1是0.05316682466660218第2个参数的系数w2是-0.18646504530370703第3个参数的系数w3是0.9929170515580459第4个参数的系数w4是-3.58987972356301第5个参数的系数w5是-0.7891178302503383第6个参数的系数w6是-1.0691692309220726第7个参数的系数w7是-0.898262690288156第8个参数的系数w8是0.0004192227134026445第9个参数的系数w9是-0.0009873152783230444第10个参数的系数w10是0.005132983009114543第11个参数的系数w11是0.0018281459458755276第12个参数的系数w12是0.009944236048885842
预测
In [9]
# 读取数据df = pd.read_csv('pubg_test.csv')test_data = df.iloc[:,2:].values# 测试集数据没有最后一维,所以要取max_value的前13维度进行归一化test_data = test_data / max_value[:-1]# 由于测试集数据即使有缺失值也不能删除了,所以需要使用训练集数据的均值对缺失值进行填充mean_value = data.mean(axis = 0)
In [10]
# 预测import numpy as nppredict_result = [] # 保存预测信息for i in range(len(test_data)): sample = test_data[i] # 替换缺失值 for j in range(len(sample)): if np.isnan(sample[j]): sample[j] = mean_value[j] # 填充输入数据 for i in range(13): x[i].value = sample[i] y.value = sample[-1] # 需要注意,result节点只是用于求损失,真正的结果输出其实在a[12]节点 # 这里既可以运行result也可以运行a[12]节点,只要最后从a[12]节点取数据即可 a[-1].forward() # 记录结果,并且去归一化 out = int(a[-1].value * max_value[-1]) if out=max_value[-1]: out = max_value[-1] predict_result.append(out)
In [11]
# 打包提交predict_df = pd.DataFrame(predict_result, columns = ['team_placement'])predict_df.to_csv('submission.csv',index = None)! zip submission.zip submission.csv
updating: submission.csv (deflated 75%)
以上就是从零实现深度学习框架 基础框架的构建的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/56703.html
 微信扫一扫
 支付宝扫一扫