Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
高效选取Pandas DataFrame特定元素的向量化方法_创想鸟

高效选取Pandas DataFrame特定元素的向量化方法

高效选取Pandas DataFrame特定元素的向量化方法

本文探讨了如何在pandas dataframe中,根据一个series提供行索引和列标签的映射关系,高效、向量化地选取特定元素。通过介绍`factorize`结合`reindex`和`merge`两种主要方法,详细阐述了如何避免低效的循环操作,实现性能优化,并提供了具体的代码示例和注意事项。

在数据分析和处理中,我们经常需要从Pandas DataFrame中提取特定位置的元素。一个常见的场景是,我们有一个DataFrame,以及一个Series。这个Series的索引对应DataFrame的列名,而Series的值则对应DataFrame的行索引。我们的目标是根据这种映射关系,高效地提取DataFrame中对应位置的元素,并返回一个Series或列表。

传统的做法可能会采用迭代Series的方式,逐个查找并赋值,例如:

import pandas as pd# 假设 df 和 sr 已定义# result = pd.Series()# for c, i in sr.items():#     result[c] = df.loc[i, c]

这种方法虽然直观,但对于大型数据集而言,其性能瓶颈在于循环操作,无法充分利用Pandas和NumPy的向量化优势,导致效率低下。本文将介绍两种更高效、向量化的解决方案。

示例数据

为了更好地说明问题和解决方案,我们首先定义一个示例DataFrame和Series:

import pandas as pdimport numpy as np# 示例 DataFramedata = np.arange(25).reshape(5, 5)df = pd.DataFrame(data, columns=list('abcde'))print("DataFrame (df):n", df)# 示例 Seriessr = pd.Series({'a': 1, 'c': 2, 'b': 3})print("nSeries (sr):n", sr)

输出:

DataFrame (df):    a   b   c   d   e0   0   1   2   3   41   5   6   7   8   92  10  11  12  13  143  15  16  17  18  194  20  21  22  23  24Series (sr):a    1c    2b    3dtype: int64

我们的目标是根据sr的映射关系:

sr[‘a’] = 1 对应 df.loc[1, ‘a’] 即 5sr[‘c’] = 2 对应 df.loc[2, ‘c’] 即 12sr[‘b’] = 3 对应 df.loc[3, ‘b’] 即 16最终得到一个Series:{‘a’: 5, ‘c’: 12, ‘b’: 16}。

方法一:利用 factorize 和 reindex 进行二维查找

这种方法的核心思想是将DataFrame的行索引和列标签以及Series中的对应值,都转换为整数位置编码。然后,通过reindex对DataFrame进行对齐,最后利用NumPy的二维数组索引能力进行高效查找。

步骤详解:

编码Series的值和索引:使用pd.factorize()将sr的值(行索引)和sr的索引(列标签)分别转换为整数编码及其对应的唯一标签列表。

a_i, idx = pd.factorize(sr)       # a_i 是 sr 值的整数编码,idx 是 sr 值的唯一列表a_c, col = pd.factorize(sr.index) # a_c 是 sr 索引的整数编码,col 是 sr 索引的唯一列表

a_i 将是 [1, 2, 3] (对应 sr 的值 1, 2, 3 在 idx 中的位置)idx 将是 [1, 2, 3] (sr 值的唯一集合)a_c 将是 [0, 1, 2] (对应 sr 索引 a, c, b 在 col 中的位置)col 将是 [‘a’, ‘c’, ‘b’] (sr 索引的唯一集合)

对齐DataFrame:使用df.reindex(index=idx, columns=col)根据sr中涉及到的行索引和列标签来重新排列DataFrame。这会创建一个新的DataFrame视图,其行索引和列名与idx和col完全匹配。

reindexed_df = df.reindex(index=idx, columns=col)

此时,reindexed_df的形状和内容已经准备好,可以与a_i和a_c的整数编码进行对应。

英特尔AI工具 英特尔AI工具

英特尔AI与机器学习解决方案

英特尔AI工具 70 查看详情 英特尔AI工具

执行二维数组查找:将reindexed_df转换为NumPy数组,然后利用a_i和a_c作为行和列的整数索引进行查找。

extracted_values = reindexed_df.to_numpy()[a_i, a_c]

[a_i, a_c] 构成了 (行索引数组, 列索引数组) 的形式,NumPy会根据这些对应位置提取元素。

构建结果Series:将提取到的值extracted_values与原始sr的索引重新组合,形成最终的Series。

out = pd.Series(extracted_values, index=sr.index)

完整代码示例:

# 方法一:利用 factorize 和 reindexa_i, idx = pd.factorize(sr)a_c, col = pd.factorize(sr.index)out_factorize = pd.Series(df.reindex(index=idx, columns=col).to_numpy()[a_i, a_c],                          index=sr.index)print("n方法一结果 (factorize):n", out_factorize)

输出:

方法一结果 (factorize): a     5c    12b    16dtype: int64

方法二:利用 merge 进行数据融合

另一种方法是利用Pandas的merge操作。这种方法通常在数据转换和重塑时非常有用,但可能比factorize方法稍微复杂一些。

步骤详解:

重塑 sr:将sr转换为一个DataFrame,使其索引成为一个常规列,方便后续合并。

sr_df = sr.reset_index() # 结果是 DataFrame: 'index' | 0                         #                  'a'     | 1                         #                  'c'     | 2                         #                  'b'     | 3

重塑 df:将df堆叠(stack)成一个Series,其索引将是多级索引 (行索引, 列标签)。然后给这个Series命名,方便后续合并。

df_stacked = df.stack().rename('out')# df_stacked 的索引格式为 (行索引, 列标签)# 例如:(0, 'a') -> 0, (0, 'b') -> 1, ...

执行合并操作:将sr_df与df_stacked进行合并。

left_on=[0, ‘index’]: sr_df的0列(原sr的值,即DataFrame的行索引)和’index’列(原sr的索引,即DataFrame的列标签)作为合并键。right_index=True: df_stacked的索引(多级索引 (行索引, 列标签))作为合并键。how=’left’: 左合并,保留sr_df的所有记录。

merged_df = sr_df.merge(df_stacked,                      left_on=[0, 'index'],                      right_index=True,                      how='left')

整理结果:合并后的DataFrame包含原始sr的信息以及从df中提取的值。我们需要将其整理回原始sr的索引和结构。

out_merge = merged_df.set_index('index')['out']

完整代码示例:

# 方法二:利用 mergeout_merge = (sr.reset_index()               .merge(df.stack().rename('out'),                      left_on=[0, 'index'],                      right_index=True,                      how='left')              .set_index('index')['out']            )print("n方法二结果 (merge):n", out_merge)

输出:

方法二结果 (merge): indexa     5c    12b    16Name: out, dtype: int64

请注意,merge方法的结果Series的name可能会有所不同,但内容是相同的。

注意事项

sr 索引重复的处理:上述两种向量化方法在处理sr的索引存在重复时,与原始的迭代循环行为可能不同。如果sr的索引有重复,例如 sr = pd.Series({‘a’: 1, ‘c’: 2, ‘b’: 3, ‘a’: 4}),原始循环会取最后一个’a’对应的值(df.loc[4, ‘a’])。而factorize方法会根据sr的顺序处理,merge方法则可能返回多个匹配项。如果需要模拟原始循环“取最后一个”的行为,应在执行向量化操作前对sr进行预处理,例如:

# 如果 sr 的索引可能重复,且希望保留最后一个匹配项sr_cleaned = sr[~sr.index.duplicated(keep='last')]# 然后将 sr_cleaned 代替 sr 用于上述方法

这会确保每个唯一的sr索引只对应一个值。

性能考量:通常情况下,factorize结合reindex和NumPy索引的方法在性能上会优于merge方法,尤其是在处理大规模数据时,因为它更直接地利用了底层数组操作。merge方法涉及更多的数据重塑和哈希表查找,开销相对较大。

总结

本文介绍了两种在Pandas DataFrame中高效、向量化地选取特定元素的方法,以替代低效的循环迭代。factorize结合reindex和NumPy二维索引的方法,通过将标签转换为整数位置,实现了极高的查找效率。而merge方法则通过数据重塑和融合,提供了一种更具通用性的解决方案。在实际应用中,根据数据规模和对性能的要求,可以选择最适合的方法。同时,对于sr中可能存在的索引重复问题,也提供了相应的预处理建议,以确保结果的准确性。掌握这些向量化技巧,对于提升Pandas数据处理的效率至关重要。

以上就是高效选取Pandas DataFrame特定元素的向量化方法的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/592771.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

如何关闭浏览器弹出窗口拦截功能(在哪里设置电脑浏览器取消拦截)
上一篇 2025年11月10日 16:41:27
如何处理SQL中的大数据量排序?通过分区和索引优化排序性能
下一篇 2025年11月10日 16:41:29

相关推荐

  • Java中高效查找时空事件重叠的方法

    本文探讨了在Java中高效查找具有空间和时间范围定义的事件之间重叠的解决方案。核心思想是将时空事件编码为二维矩形,然后利用专业的空间索引结构(如R树、四叉树或PH树)进行快速查询。通过这种方法,可以显著提升在大规模数据集中识别事件重叠的效率,并提供了使用Tinspin索引库的示例代码和实践建议。 时…

    2026年9月21日
    000
  • PHP/MySQL:高效合并订单商品并按日期分组显示

    本教程将指导如何在PHP/MySQL应用中,将同一日期的订单商品合并显示在同一行,以提高数据展示的清晰度。核心解决方案是利用MySQL的GROUP_CONCAT函数在数据库层面进行高效聚合,避免复杂的PHP逻辑处理,从而简化代码并优化性能。 订单数据展示的常见挑战 在开发在线购物平台时,通常需要向用…

    2026年9月21日
    100
  • 俄罗斯Яндекс账号登录入口 Yandex电脑版官方网站登录

    答案是https://www.yandex.com/。该网站提供搜索、地图、新闻、翻译等服务,界面简洁,支持个性化设置与账户同步,并拥有邮箱、云存储及丰富的应用生态。 1、立即进入“☞☞☞☞点击俄罗斯yandex搜索引擎入口☜☜☜☜”; 2、立即进入“☞☞☞☞点击快速获取Yandex免登录官网链接☜…

    2026年9月21日
    000
  • 谷歌浏览器官方主站入口 最新Chrome在线登录页面

    谷歌浏览器官方主站入口是https://www.google.com,该页面具备界面简洁、操作流畅、集成化服务入口和个性化推荐等特点,支持多设备访问且无广告干扰。 谷歌浏览器官方主站入口在哪里?这是不少网友都关注的,接下来由PHP小编为大家带来谷歌浏览器最新Chrome在线登录页面相关信息,感兴趣的…

    2026年9月21日
    000
  • MySQL 大型历史数据表结构设计与优化指南

    本文旨在为处理大量客户历史交易数据的MySQL数据库设计提供专业指导。我们将探讨如何构建高效、可扩展的表结构,重点关注主键设计、数据分区、实时数据摄入以及性能优化策略,以确保系统能够稳定支持百万级乃至亿级数据量的查询需求。 MySQL大型历史数据表结构设计与优化 在处理大量历史数据,特别是涉及到多用…

    2026年9月21日
    000
  • 鸣潮2.7嘉贝莉娜隐藏成就该怎么达成-鸣潮2.7嘉贝莉娜隐藏成就达成条件一览

    鸣潮2.7嘉贝莉娜隐藏成就该怎么达成-鸣潮2.7嘉贝莉娜隐藏成就达成条件一览鸣潮2.7嘉贝莉娜隐藏成就该怎么达成-鸣潮2.7嘉贝莉娜隐藏成就达成条件一览鸣潮2.7嘉贝莉娜隐藏成就该怎么达成-鸣潮2.7嘉贝莉娜隐藏成就达成条件一览鸣潮2.7嘉贝莉娜隐藏成就该怎么达成-鸣潮2.7嘉贝莉娜隐藏成就达成条件一览

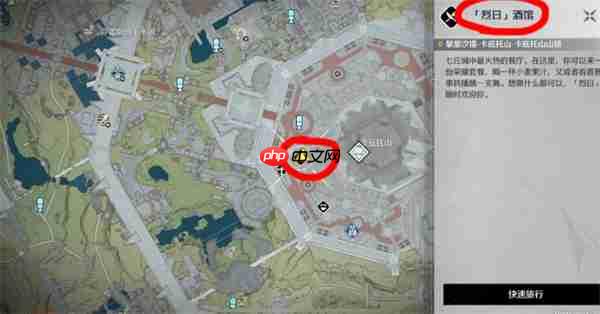
    在《鸣潮》2.7版本中,每位角色都设有专属的隐藏成就与趣味彩蛋。其中,嘉贝莉娜相关的隐藏成就“再会,清醒的猎人”需要玩家满足特定的时间与地点条件方可触发。以下是该成就的详细达成方法汇总。 鸣潮2.7嘉贝莉娜隐藏成就触发条件全解析——地点一: 1、传送到黎那汐塔区域的【烈日酒馆】。 2、进入酒馆后,朝…

    2026年9月21日 用户投稿
    000
  • 怎么全选VSCode多个光标_VSCode多光标操作与批量选择文本教程

    VSCode中高效创建多光标的方法包括:Alt+Click手动添加光标,适用于不规则位置;Ctrl+Alt+方向键垂直添加光标,适合连续多行操作;Ctrl+D逐个选择匹配项,精准控制选择范围;Ctrl+Shift+L一次性选择所有匹配项,实现全局批量修改。结合查找替换和列选择模式可进一步提升编辑效率…

    2026年9月21日
    100
  • CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法

    CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法

    答案:CyberLink MediaSuite(核心为PowerDirector)通过AI艺术风格转换、智能对象选取、AI天空替换、音频降噪与运动追踪等功能,显著提升视频制作效率与创意表现。结合模板应用、快捷键操作、媒体库管理及代理编辑等实战技巧,可实现快速剪辑与专业输出,适用于Vlog创作、教育视…

    2026年9月21日 用户投稿
    300
  • 小红书从哪里看私信记录?私信记录如何清理?

    在小红书上与朋友或喜欢的博主互动时,私信是必不可少的沟通方式。不少新手用户常常困惑于如何查找过往的聊天内容。本文将为你详细说明查看私信记录的具体步骤,并分享几种实用的清理方法,帮助你轻松管理私信箱,让对话界面更清爽。 一、如何找到小红书的私信记录? 查看私信的操作非常直观,只需几个简单步骤即可完成。…

    2026年9月21日
    000
  • LLaVA-OneVision-1.5— EvolvingLMMS-Lab开源的多模态模型

    LLaVA-OneVision-1.5— EvolvingLMMS-Lab开源的多模态模型LLaVA-OneVision-1.5— EvolvingLMMS-Lab开源的多模态模型LLaVA-OneVision-1.5— EvolvingLMMS-Lab开源的多模态模型LLaVA-OneVision-1.5— EvolvingLMMS-Lab开源的多模态模型

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 百灵大模型 蚂蚁集团自研的多模态AI大模型系列 177 查看详情 llava-onevision-1.5 是一款开源的先进多模态大模型,凭借高效的训练策略与高质量的数据构建,在性能、成本控制和可…

    2026年9月21日 用户投稿
    100
  • 钉钉视频通话模糊怎么办 钉钉视频清晰度调整与网络优化方法

    视频模糊主因是网络、设备或设置问题。先优化Wi-Fi并关后台应用,再清洁镜头、调光线和物理对焦,最后开高清模式、更新钉钉版本或换高清设备,多数可改善。 钉钉视频通话模糊,通常不是单一原因导致的,而是网络、设备或软件设置共同影响的结果。想要快速改善画面质量,可以从以下几个方面着手排查和优化。 检查并优…

    2026年9月21日
    100
  • Flyway配置中安全使用环境变量的实践指南

    flyway配置中直接暴露数据库连接参数存在安全隐患。本文详细阐述了如何通过命令行参数和api调用两种主要方式,将环境变量安全地集成到flyway配置流程中。通过外部化管理敏感信息,可以有效提升数据库迁移配置的安全性、灵活性和可维护性,避免将凭证硬编码到配置文件中。 在数据库迁移实践中,将敏感的数据…

    2026年9月21日
    200
  • PHP 数组值比较与嵌套数组过滤教程

    本教程详细讲解如何在 PHP 中比较一个简单数组与一个复杂嵌套数组,并根据特定条件(如文件名匹配)过滤嵌套数组中的所有相关子数组。我们将通过识别非匹配项的索引,然后从所有子数组中移除这些项并重新索引,实现精确的数据筛选。 问题背景 在 php 开发中,我们经常会遇到需要处理结构复杂的数组数据。例如,…

    2026年9月21日
    200
  • Java集合框架在数据处理中的应用实例

    使用Set去重:通过LinkedHashSet去除标签重复并保持顺序;2. Map统计频次:利用HashMap统计单词出现次数;3. List结合Comparator排序:按年龄升序、姓名降序排列用户;4. 集合嵌套处理数据:用Map组织部门与员工列表。集合框架提升数据处理效率与代码可读性。 Jav…

    2026年9月21日
    100
  • MySQL性能模式监控资源_MySQL瓶颈定位精确工具

    MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具

    mysql性能模式通过事件记录精准定位瓶颈,核心步骤包括:1.启用并配置performance schema,选择性开启消费者和仪器;2.监控等待事件、sql语句、阶段、i/o、内存及锁等关键指标;3.分析events_waits_summary_global_by_event_name等表识别资源…

    2026年9月21日 用户投稿
    000
  • 如何配置VSCode来完美支持Vue.js开发?

    安装Volar、TypeScript Vue Plugin、ESLint和Prettier扩展,禁用Vetur,在settings.json中配置vetur.enabled为false,设置ESLint保存时自动修复并指定Prettier为默认格式化工具,关联.vue文件语言,启用TypeScrip…

    2026年9月21日
    000
  • PHP简易路由框架构建:从URL解析到动态控制器加载的实践指南

    本文旨在指导读者构建一个基础的PHP路由系统,实现URL路径到控制器方法的高效映射。内容涵盖URL解析、控制器动态加载、方法调用以及关键的错误处理机制,特别强调如何避免常见的“未定义变量”错误和文件包含路径问题,确保路由系统稳定且易于维护。 一、路由系统核心原理 构建一个简单的php路由系统,其核心…

    2026年9月21日
    200
  • VSCode的便携模式(Portable Mode)如何工作,它适合哪些使用场景?

    VSCode便携模式通过将编辑器与data文件夹置于同一目录,实现配置、扩展和数据的集中存储,无需安装即可运行。1. 下载ZIP版解压至目标路径;2. 创建data文件夹;3. 运行Code.exe,所有数据自动存入data目录。适用于公共电脑、跨设备开发、教学演示、测试配置及受限环境。需注意手动更…

    2026年9月21日
    200
  • Laravel 8 登录后重定向到仪表盘的全面指南

    本文深入探讨了 Laravel 8 中用户登录后重定向到仪表盘的多种策略。我们将详细解析默认的重定向机制,包括 LoginController 和 RedirectIfAuthenticated 中间件,并重点介绍如何通过自定义登录逻辑实现精确的重定向控制,同时提供示例代码和常见问题排查建议,确保用…

    2026年9月21日
    200
  • Java Stream 高效分组计数并获取Top N元素

    本文深入探讨了如何利用java stream api对数据进行高效的分组计数,并从中提取出现频率最高的top n元素。文章首先介绍了一种简洁的基于全排序的实现方式,该方法适用于数据集较小或top n值接近总数的情况。随后,针对大数据量和小型top n场景下的性能瓶颈,文章详细阐述了如何通过自定义`c…

    2026年9月21日
    100

发表回复

登录后才能评论
关注微信