Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
一文读懂图卷积神经网络(GCN)_创想鸟

一文读懂图卷积神经网络(GCN)

本文围绕经典论文介绍GCN,解释其定义,即处理图结构数据的网络,输入为带特征的图,输出为节点特征。解析核心公式,通过添加自环、对称归一化邻接矩阵解决信息丢失和尺度问题,还提及在Cora数据集上的应用及数学证明参考。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
一文读懂图卷积神经网络(gcn) - 创想鸟

GCN 学习

本文讲的GCN理论知识来源于论文:

SEMI-SUPERVISED CLASSIFICATION WITH GRAPH CONVOLUTIONAL NETWORKS

这是在GCN领域最经典的论文之一

1. 什么是GCN

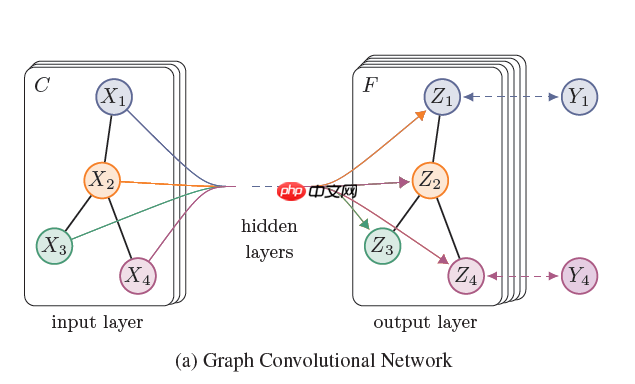
GCN结构图
一文读懂图卷积神经网络(GCN) - 创想鸟        

我们可以根据这个GCN的图看到,一个拥有 CC 个input channel的graph作为输入,经过中间的hidden layers,得到 FF 个 output channel的输出。

图卷积网络主要可以由两个级别的作用变换组成:

注意本文讲的图都特指无向无权重的图。

graph level:

例如说通过引入一些形式的pooling 操作. 然后改变图的结构。但是本次讲过GCN并没有进行这个级别的操作。所以看到上图我们的网络结构的输出和输出的graph的结构是一样的。

node level:

通常说node level的作用是不改变graph的结构的,仅通过对graph的特征/信号(特征信号 XX 作为输入:一个 N∗DN∗D 矩阵( NN: 输入图的nodes的个数, DD 输入的特征维度) ,得到输出 ZZ:一个 N∗FN∗F 的矩阵( FF 输出的特征维度)。

a) 一个特征描述(feature description) xixi : 指的是每个节点 ii 的特征表示

b) 每一个graph 的结构都可以通过邻接矩阵 AA 表示(或者其他根据它推导的矩阵)

举例:

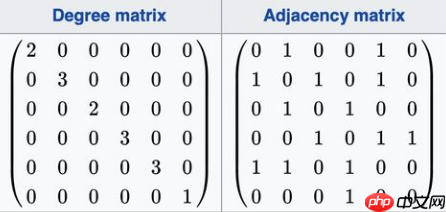
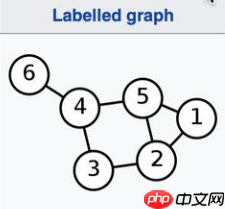
我们可以很容易的根据一个邻接矩阵重构出一个graph。 例如下图: G=(V,E)G=(V,E) 其中 VV 代表节点, EE 代表边
一文读懂图卷积神经网络(GCN) - 创想鸟        

根据图,我们就可以得出下面的维度图和邻接矩阵

一文读懂图卷积神经网络(GCN) - 创想鸟        

论文公式提出

因为 AA 可以确定唯一的一张图,这么重要的一个属性我们肯定是要把他放到神经网络传递函数里面去的,所以网络中间的每一个隐藏层可以写成以下的非线性函数:
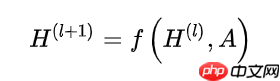
一文读懂图卷积神经网络(GCN) - 创想鸟        

其中输入层 H(0)=XH(0)=X , 输出层 H(L)=ZH(L)=Z , LL 是层数。 不同的GCN模型,采用不同 f(⋅,⋅)f(⋅,⋅)函数。

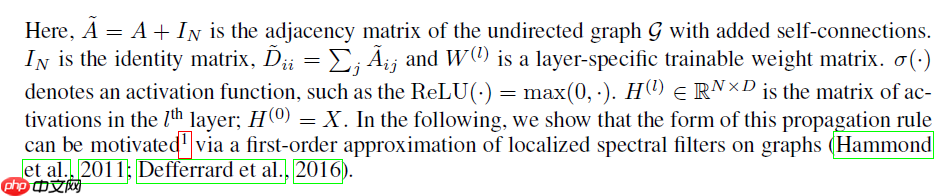
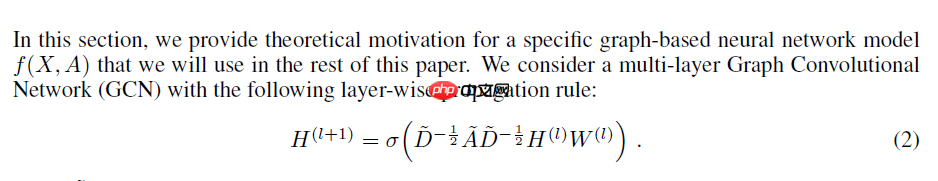
上面是我们理想中的函数的形式,论文中最终推导出来的函数是这样的:
一文读懂图卷积神经网络(GCN) - 创想鸟        

一文读懂图卷积神经网络(GCN) - 创想鸟        

论文公式逐步解析

每一个节点下一层的信息是由前一层本身的信息以及相邻的节点的信息加权加和得到,然后再经过线性变换 WW 以及非线性变换 σ()σ() 。

我们一步一步分解,我们要定义一个简单的f(H(l),A)f(H(l),A) 函数,作为基础的网络层。

可以很容易的采用最简单的层级传导(layer-wise propagation)规则:

f(H(l),A)=σ(AH(l)W(l))f(H(l),A)=σ(AH(l)W(l))

我们直接将 AHAH 做矩阵相乘,然后再通过一个权重矩阵 W(l)W(l)做线性变换,之后再经过非线性激活函数 σ(⋅)σ(⋅) , 比如说 ReLUReLU,最后得到下一层的输入 Hl+1Hl+1 。

In [ ]

import paddleA = paddle.to_tensor([    [0,1,0,0,1,0],    [1,0,1,0,1,0],    [0,1,0,1,0,0],    [0,0,1,0,1,1],    [1,1,0,1,0,0],    [0,0,0,1,0,0]],dtype='float32')print(A)H_0 = paddle.to_tensor([[1],[2],[3],[4],[5],[6]],dtype='float32')print(H_0)x = paddle.matmul(A,H_0)print(x)


Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[0., 1., 0., 0., 1., 0.],        [1., 0., 1., 0., 1., 0.],        [0., 1., 0., 1., 0., 0.],        [0., 0., 1., 0., 1., 1.],        [1., 1., 0., 1., 0., 0.],        [0., 0., 0., 1., 0., 0.]])Tensor(shape=[6, 1], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[1.],        [2.],        [3.],        [4.],        [5.],        [6.]])Tensor(shape=[6, 1], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[7. ],        [9. ],        [6. ],        [14.],        [7. ],        [4. ]])


从上面输出可以看的出来:每个值保留了相邻节点的值

输入层的 x1=[1]x1=[1] , 根据矩阵的运算公式我们可以很容易地得到下一层的该节点的表示 X1′=[7]X1′=[7], 也很容易发现 X1′(1)=x2+x5X1′(1)=x2+x5,而 x2,x5x2,x5就是节点1的相邻节点。

就是可以看图:

[1] = 2 + 5
[2] = 1+ 3 + 5
······
[6] = 4

所以我们 AHAH 就是快速将相邻的节点的信息相加得到自己下一层的输入。

但是这样就出现了新的问题:

问题一
我们虽然获得了周围节点的信息了,但是自己本身的信息却没了

解决方案:
对每个节点手动增加一条self-loop 到每一个节点,即 A^=A+IA=A+I
其中 II是单位矩阵identity matrix。

问题二
从上面的结果也可以看出,在经过一次的AHAH 矩阵变换后,得到的输出会变大,即特征向量 XX 的scale会改变,在经过多层的变化之后,将和输入的scale差距越来越大。

解决方案:
可以将邻接矩阵 AA 做归一化使得最后的每一行的加和为1,使得 AHAH 获得的是weighted sum。

我们可以将 AA 的每一行除以行的和,这就可以得到normalized的 AA 。而其中每一行的和,就是每个节点的度degree。

用矩阵表示则为: A=D−1AA=D−1A ,对于Aij=AijdiAij=diAij

代码展示:

In [8]

import paddleimport numpy as npA = paddle.to_tensor([    [0,1,0,0,1,0],    [1,0,1,0,1,0],    [0,1,0,1,0,0],    [0,0,1,0,1,1],    [1,1,0,1,0,0],    [0,0,0,1,0,0]],dtype='float32')print(A)D = paddle.to_tensor([    [2,0,0,0,0,0],    [0,3,0,0,0,0],    [0,0,2,0,0,0],    [0,0,0,3,0,0],    [0,0,0,0,3,0],    [0,0,0,0,0,1]], dtype='float32')print(D)# 防止为0时取倒数变成无穷大D[D==0] = D.max() + 1e100DD = paddle.reciprocal(D)print(DD)hat_A = paddle.matmul(DD,A)print(hat_A)


Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[0., 1., 0., 0., 1., 0.],        [1., 0., 1., 0., 1., 0.],        [0., 1., 0., 1., 0., 0.],        [0., 0., 1., 0., 1., 1.],        [1., 1., 0., 1., 0., 0.],        [0., 0., 0., 1., 0., 0.]])Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[2., 0., 0., 0., 0., 0.],        [0., 3., 0., 0., 0., 0.],        [0., 0., 2., 0., 0., 0.],        [0., 0., 0., 3., 0., 0.],        [0., 0., 0., 0., 3., 0.],        [0., 0., 0., 0., 0., 1.]])Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[0.50000000, 0.        , 0.        , 0.        , 0.        , 0.        ],        [0.        , 0.33333334, 0.        , 0.        , 0.        , 0.        ],        [0.        , 0.        , 0.50000000, 0.        , 0.        , 0.        ],        [0.        , 0.        , 0.        , 0.33333334, 0.        , 0.        ],        [0.        , 0.        , 0.        , 0.        , 0.33333334, 0.        ],        [0.        , 0.        , 0.        , 0.        , 0.        , 1.        ]])Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[0.        , 0.50000000, 0.        , 0.        , 0.50000000, 0.        ],        [0.33333334, 0.        , 0.33333334, 0.        , 0.33333334, 0.        ],        [0.        , 0.50000000, 0.        , 0.50000000, 0.        , 0.        ],        [0.        , 0.        , 0.33333334, 0.        , 0.33333334, 0.33333334],        [0.33333334, 0.33333334, 0.        , 0.33333334, 0.        , 0.        ],        [0.        , 0.        , 0.        , 1.        , 0.        , 0.        ]])


但是在实际运用中采用的是对称的normalization:

用矩阵表示则为:

A=D−12AD−12A=D−21AD−21

对于Aij=AijdidjAij=didjAij

这其实是跟Laplacian Matrix 有关,拉普拉斯算子是这样的:

L=IN−D−12AD−12L=IN−D−21AD−21

In [9]

import paddleimport numpy as npA = paddle.to_tensor([    [0,1,0,0,1,0],    [1,0,1,0,1,0],    [0,1,0,1,0,0],    [0,0,1,0,1,1],    [1,1,0,1,0,0],    [0,0,0,1,0,0]],dtype='float32')print(A)D = paddle.to_tensor([    [2,0,0,0,0,0],    [0,3,0,0,0,0],    [0,0,2,0,0,0],    [0,0,0,3,0,0],    [0,0,0,0,3,0],    [0,0,0,0,0,1]], dtype='float32')print(D)# 取逆D[D==0] = D.max() + 1e100DD = paddle.reciprocal(D)print(DD)# 开方_DD = paddle.sqrt(DD)# 求积hat_A = paddle.matmul(paddle.matmul(_DD,A),_DD)print(hat_A)


Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[0., 1., 0., 0., 1., 0.],        [1., 0., 1., 0., 1., 0.],        [0., 1., 0., 1., 0., 0.],        [0., 0., 1., 0., 1., 1.],        [1., 1., 0., 1., 0., 0.],        [0., 0., 0., 1., 0., 0.]])Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[2., 0., 0., 0., 0., 0.],        [0., 3., 0., 0., 0., 0.],        [0., 0., 2., 0., 0., 0.],        [0., 0., 0., 3., 0., 0.],        [0., 0., 0., 0., 3., 0.],        [0., 0., 0., 0., 0., 1.]])Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[0.50000000, 0.        , 0.        , 0.        , 0.        , 0.        ],        [0.        , 0.33333334, 0.        , 0.        , 0.        , 0.        ],        [0.        , 0.        , 0.50000000, 0.        , 0.        , 0.        ],        [0.        , 0.        , 0.        , 0.33333334, 0.        , 0.        ],        [0.        , 0.        , 0.        , 0.        , 0.33333334, 0.        ],        [0.        , 0.        , 0.        , 0.        , 0.        , 1.        ]])Tensor(shape=[6, 6], dtype=float32, place=CUDAPlace(0), stop_gradient=True,       [[0.        , 0.40824828, 0.        , 0.        , 0.40824828, 0.        ],        [0.40824828, 0.        , 0.40824828, 0.        , 0.33333331, 0.        ],        [0.        , 0.40824828, 0.        , 0.40824828, 0.        , 0.        ],        [0.        , 0.        , 0.40824828, 0.        , 0.33333331, 0.57735026],        [0.40824828, 0.33333331, 0.        , 0.33333331, 0.        , 0.        ],        [0.        , 0.        , 0.        , 0.57735026, 0.        , 0.        ]])


A0,1=A0,1d0d1=123=0.4082A0,1=d0d1A0,1=231=0.4082

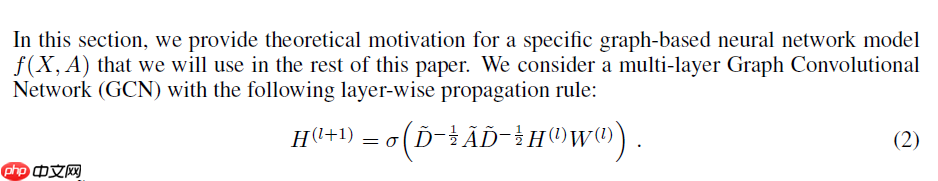
把这两个tricks结合起来,我们就可以原文的公式:
一文读懂图卷积神经网络(GCN) - 创想鸟        

其中 A^=A+IA=A+I , D^D 是 A^A 的degree matrix。 而 D^−12A^D^−12D−21AD−21 是对 AA 做了一个对称的归一化。

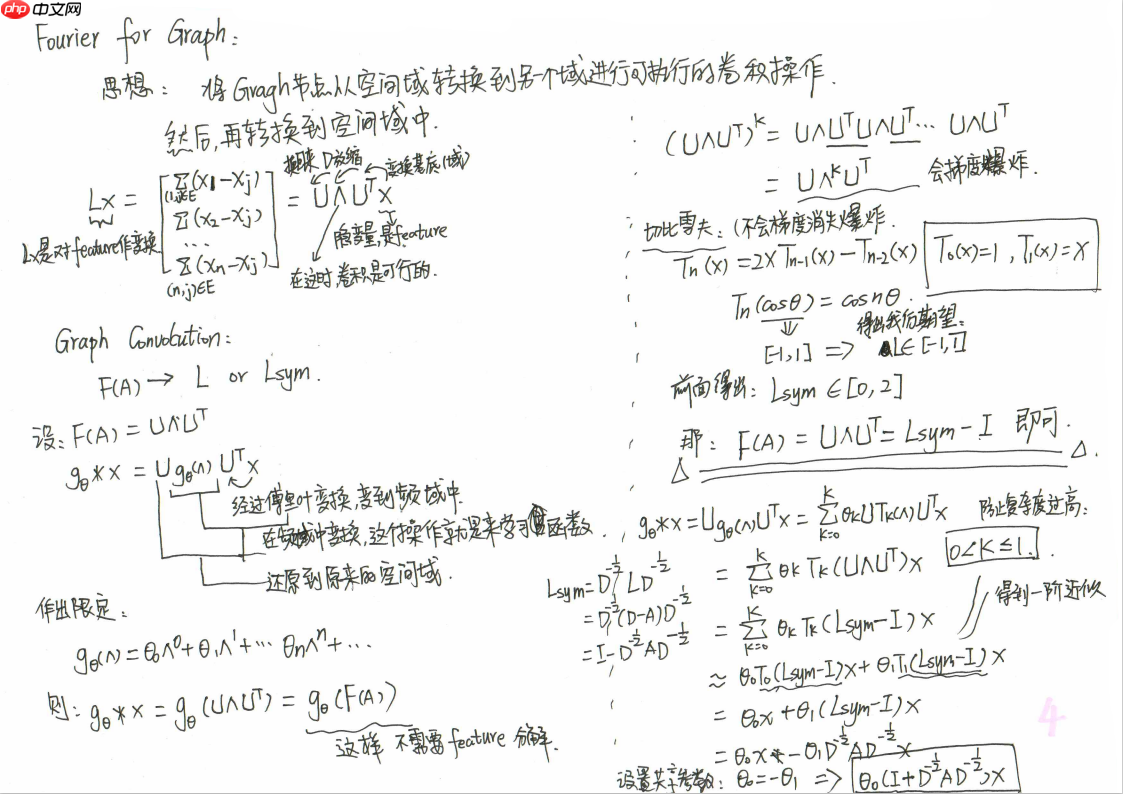
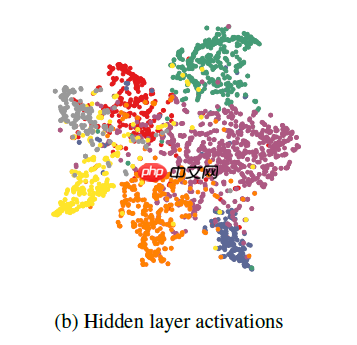
在Cora数据集上训练的两层GCN的隐藏层激活的可视化效果如下:
一文读懂图卷积神经网络(GCN) - 创想鸟        

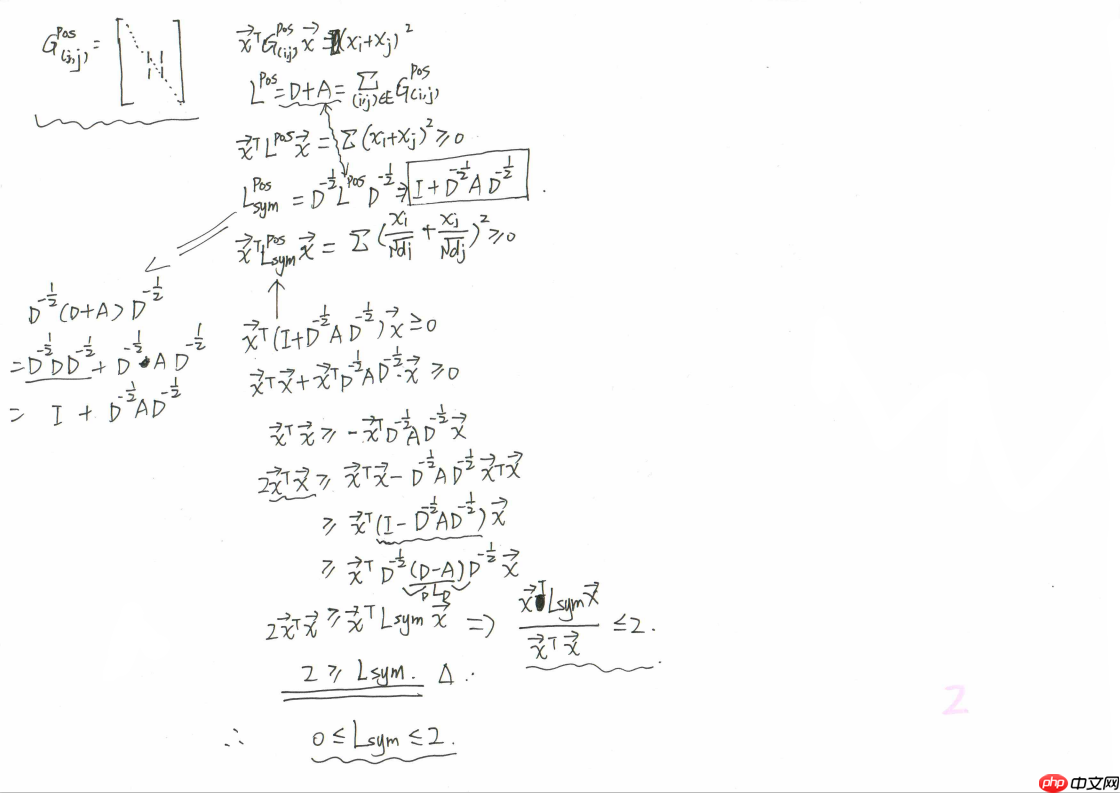
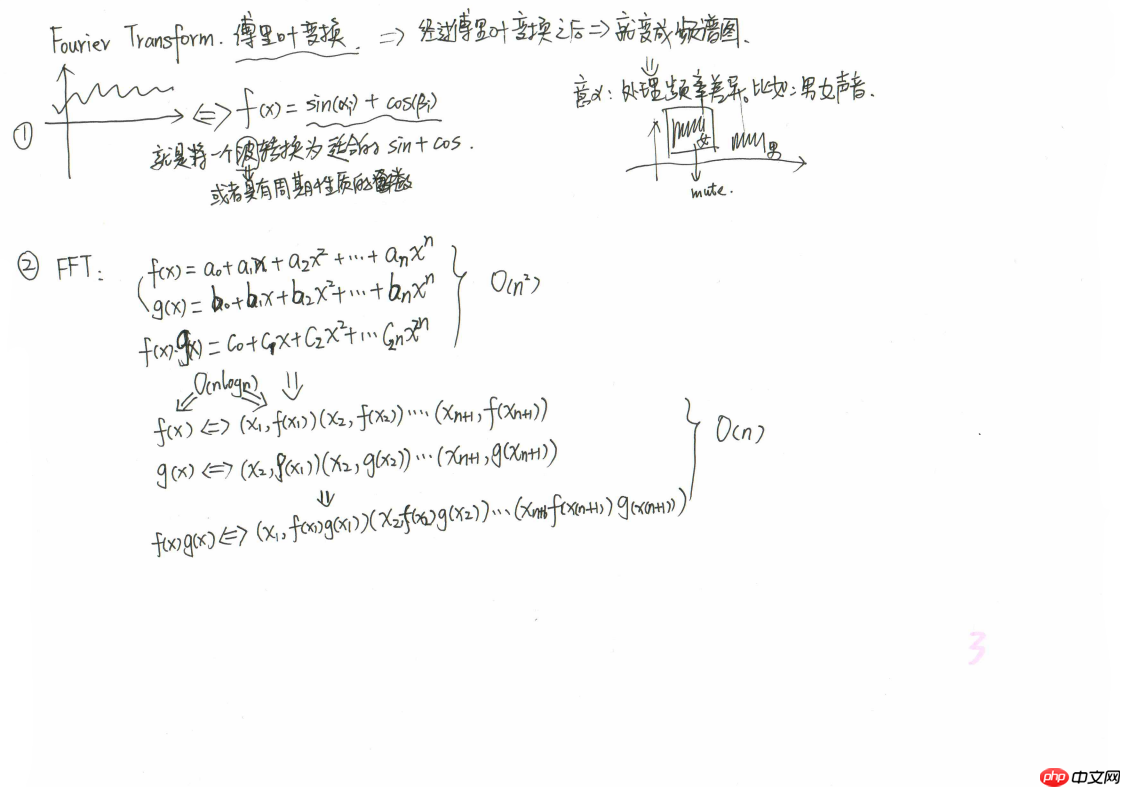
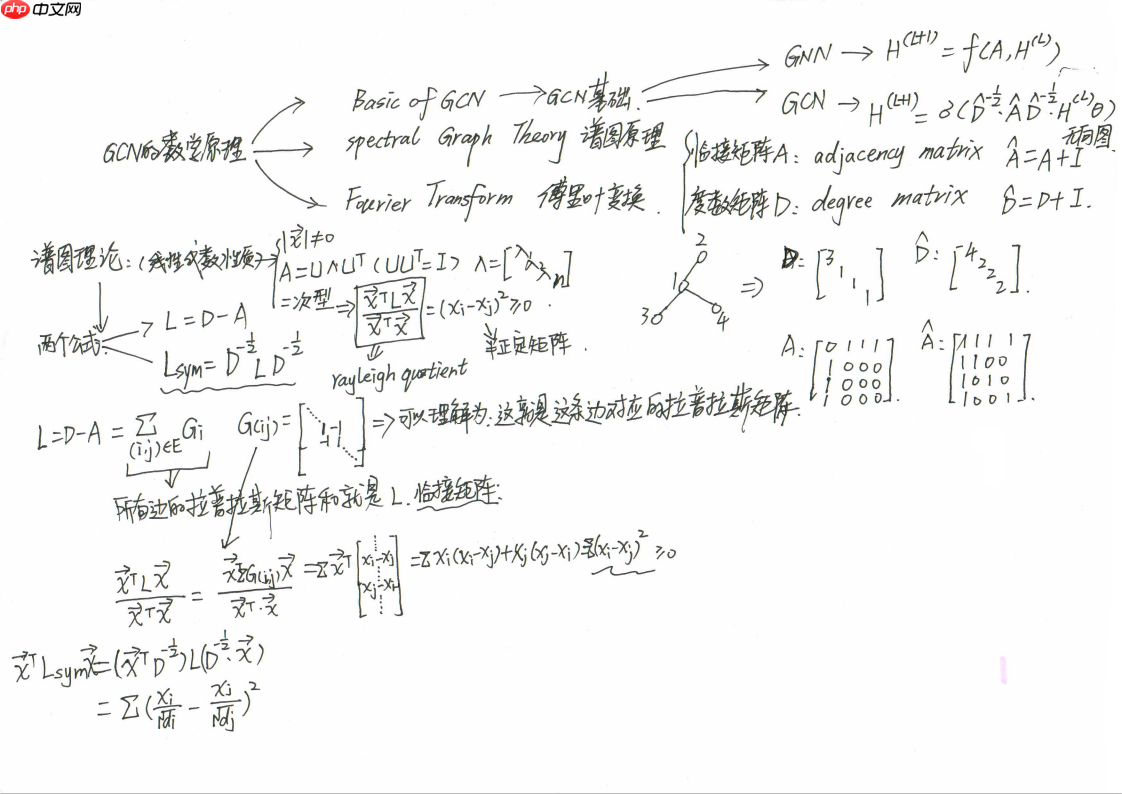
2. 数学证明:

附上参考的视频:

https://www.bilibili.com/video/BV1Vw411R7Fj
一文读懂图卷积神经网络(GCN) - 创想鸟        

一文读懂图卷积神经网络(GCN) - 创想鸟        

一文读懂图卷积神经网络(GCN) - 创想鸟        

一文读懂图卷积神经网络(GCN) - 创想鸟        

以上就是一文读懂图卷积神经网络(GCN)的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/59377.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
swoole是什么意思
上一篇 2025年11月10日 13:58:34
策略与动作融合《肉鸽弹弹奇兵》9月中旬正式发售
下一篇 2025年11月10日 14:00:51

相关推荐

  • AdobeIllustrator如何导出AI生成的图片?矢量图像保存的步骤

    首先明确输出需求,再选择“文件>导出>导出为…”或“文件>存储为…”,根据用途选取合适格式如SVG、PDF或AI,确保矢量信息保留,参数设置需匹配目标平台要求。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Adob…

    2026年9月22日
    000
  • PHP面向对象开发:解决父类构造器参数在嵌套子对象方法中丢失的问题

    在PHP面向对象编程中,我们经常会遇到类继承和对象组合的场景。一个常见的问题是,当父类构造函数接收参数并用于初始化内部的子对象时,该子对象的方法在后续调用中可能无法正确访问到这些参数,甚至显示为null。本文将深入探讨这一问题,并提供两种有效的解决方案。 引言与问题阐述 考虑一个典型的web应用架构…

    2026年9月22日
    000
  • 使用MockWebServer对FeignClient进行单元测试

    本文详细阐述了如何利用Spring Cloud LoadBalancer和MockWebServer对FeignClient进行高效单元测试。通过在测试配置中动态注册MockWebServer实例,并将其作为FeignClient的服务发现目标,开发者可以精确模拟后端API的行为,包括各种HTTP响…

    2026年9月22日
    000
  • Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力

    Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力

    mysql死锁和阻塞问题可通过sublime分析日志排查。1.使用关键词搜索及正则匹配快速定位死锁信息块;2.通过查找waiting状态事务并折叠无关内容聚焦阻塞链;3.结合general log与事务id查找sql执行顺序;4.利用语法高亮、列选择等功能提升日志可读性。这些方法能有效提高排查效率。…

    2026年9月22日 用户投稿
    100
  • Canva中AI生成图片如何导出?教你快速保存设计作品的方法

    答案:Canva中导出AI生成图片的操作与普通图片相同,点击右上角“分享”按钮,选择“下载”,可选PNG、JPG、PDF、SVG、MP4或GIF等格式;为保证画质,建议优先选用PNG格式,避免有损压缩,同时选择高分辨率和合适尺寸,Pro用户可进一步调整质量与透明背景设置;除下载外,还可通过分享链接、…

    2026年9月22日
    800
  • Linux系统中文件属性和权限实战操作

    Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作

    —–原本今天的文章是昨天晚上就要更新的,但是由于昨天晚上下班回到住的地方,发现停电了,所以就没写成。今天是在上一篇文章–linux系统中文件类型的基础上,继续进行深入的学习。好了,直接开干。 一、文件的操作权限: 1、在这之前我想还是很有必要介绍对文件的操作权限(…

    2026年9月22日 用户投稿
    000
  • PHP中为数组元素设置默认值的最佳实践:使用Null合并运算符

    本教程将介绍如何在PHP中为数组元素设置默认值,尤其当源数据可能为空或缺失时。通过利用PHP 7+提供的Null合并运算符(??),可以简洁高效地实现这一需求,避免冗长的条件判断,提高代码可读性和健壮性。 引言:处理缺失或空值时的数组赋值 在Web开发中,我们经常需要从用户请求、数据库查询或其他外部…

    2026年9月22日
    000
  • VSCode快速配置Dart:Flutter开发、中文提示、热加载

    安装vscode并下载flutter sdk,解压至无中文或特殊字符的路径;2. 将flutter sdk的bin目录添加到系统环境变量path中;3. 打开新终端执行flutter doctor,根据提示安装缺失的依赖;4. 在vscode扩展商店安装dart和flutter扩展;5. 确保在调试…

    2026年9月22日
    200
  • Inkscape如何导出AI生成的矢量图片?教你快速保存图像的步骤

    答案:在Inkscape中导出矢量图需根据用途选择格式,网页用优化SVG并转文本为路径,印刷则导出为PDF/EPS、转文字为路径、确保高分辨率位图,同时注意颜色模式与出血设置。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 在Inkscap…

    2026年9月22日
    700
  • Laravel 8 登录后重定向至仪表盘的策略与实践

    本教程详细阐述了在 Laravel 8 中实现用户登录后重定向到仪表盘的多种策略。我们将探讨如何通过配置 LoginController 的 $redirectTo 属性、利用 RouteServiceProvider 定义常量以及在自定义登录方法中进行精确控制来管理重定向流程。文章还涵盖了相关中间…

    2026年9月22日
    000
  • VSCode配置GDB调试器 深入掌握VSCode调试C程序技巧

    配置vscode中gdb调试c程序的核心是正确设置tasks.json和launch.json;2. tasks.json负责使用gcc -g编译生成带调试信息的可执行文件,确保prelaunchtask与launch.json中的program路径一致;3. launch.json指定调试器gdb…

    2026年9月22日
    100
  • java定时任务之quartz

    大家好,很高兴再次与大家见面,我是你们的朋友全栈君。 一、Quartz简介 在企业应用中,我们常常需要处理定时任务调度,比如每天凌晨生成前一天的报表,每小时生成一次汇总数据等。Quartz是一个著名的任务调度框架,它可以与J2SE和J2EE应用结合,功能非常强大,易于与Spring集成,使用起来非常…

    2026年9月22日
    100
  • Java中异常处理与方法返回值结合

    异常发生时不应返回默认值,而应通过抛出异常或使用Optional、自定义结果类等方式明确传递错误信息,确保调用方能正确处理失败情况,提升代码健壮性与可读性。 在Java中,异常处理与方法返回值的结合是一个常见的编程问题。理解它们之间的关系有助于写出更健壮、可读性更强的代码。当一个方法可能发生异常时,…

    2026年9月22日
    000
  • tk做养生类目起号前期发什么视频?tk表示什么类目?

    在TikTok上运营养生类账号,起号阶段的内容策略尤为关键。优质的内容不仅能快速吸引目标用户,还能为后续发展奠定良好基础。本文将深入解析初期应发布的视频类型,并澄清“TK”所指的平台属性及内容分类体系。 一、养生类目起号初期适合发布哪些视频内容? 刚开始做养生赛道时,重点不在于变现,而在于建立专业形…

    2026年9月22日
    000
  • PHP如何利用缓存优化实时输出_PHP实时输出与缓存结合优化

    PHP实时输出需结合输出缓冲控制与flush()强制推送,同时考虑服务器和浏览器缓存影响;2. 长时间任务应使用APCu或Redis缓存频繁数据,避免重复计算;3. 动态页面可采用分块输出与片段缓存策略,静态内容从缓存读取,动态部分边生成边输出;4. 更优方案是通过异步任务与Redis存储进度,前端…

    2026年9月22日
    000
  • 华为天际通Go将支持eSIM:设备在路上了

    华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了

    9月3日消息,今年的iphone 17 air将仅支持esim,彻底移除实体sim卡槽结构。随着新品发布日期的临近,国内esim政策的进展也愈发引人关注。 然而综合多方信息来看,iPhone 17 Air国行版本可能无法赶上首发,因前期在国内无法使用eSIM服务,导致该机型短期内难以在国内上市。 相…

    2026年9月22日 用户投稿
    000
  • VSCode配置C语言调试环境 从零开始VSCode搭建C开发工具

    要从零开始在#%#$#%@%@%$#%$#%#%#$%@_e2fc++805085e25c9761616c00e065bfe8中搭建c语言开发和调试环境,首先需安装vscode本体、c/c++编译器(如mingw或gcc)并配置系统环境变量,接着安装vscode的c/c++扩展,然后创建项目并编写c…

    2026年9月22日
    000
  • 如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程

    如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程如何用PhotoLab的AI裁剪图片?快速实现智能图像裁剪教程

    PhotoLab的AI裁剪功能通过智能识别主体与构图原则,提供优化裁剪建议,区别于传统手动裁剪的纯物理操作,能自动应用美学法则提升照片视觉吸引力;在人像、社交媒体适配、风景静物等场景中表现突出,尤其擅长保留核心焦点并适配多平台比例;用户可导入图片后使用AI裁剪工具,系统分析画面并生成建议裁剪框,支持…

    2026年9月22日 用户投稿
    000
  • 递归实现列表排序检查与条件移除最大值

    本文详细介绍了如何使用Java递归方法处理整数列表。核心内容包括:首先检查列表是否已排序,如果已排序则直接返回false;如果未排序,则查找列表中的最大值。仅当最大值位于列表的起始或结束位置时,才将其移除并递归地继续处理列表。如果最大值位于列表中间,则打印当前列表并终止递归。 在数据处理和算法设计中…

    2026年9月22日
    000
  • VSCode如何实现代码可视化调试 VSCode执行流程图形化分析方法

    vscode的可视化调试功能通过内置调试器和扩展生态,显著提升代码理解与问题排查效率。1. 首先配置launch.json文件以定义调试环境,支持多种语言如node.js、python等;2. 在代码中设置断点,程序运行至断点时暂停,便于检查变量状态和执行上下文;3. 利用调试面板查看变量、监视表达…

    2026年9月22日
    000

发表回复

登录后才能评论
关注微信