随着互联网上视频的规模日益庞大,人们急切需要研究视频相关算法帮助人们更加容易地找到感兴趣内容的视频。而视频分类算法能够实现自动分析视频所包含的语义信息、理解其内容,对视频进行自动标注、分类和描述,达到与人媲美的准确率。视频分类是继图像分类问题后下一个急需解决的关键任务。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
资源
更多CV和NLP中的transformer模型(BERT、ERNIE、ViT、DeiT、Swin Transformer等)、深度学习资料,请参考:awesome-DeepLearning更多视频模型(PP-TSM、PP-TSN、TimeSformer、BMN等),请参考:PaddleVideo
1. 实验介绍
1.1 实验目的
掌握视频分类模型 PP-TSN 的优化技巧;熟悉飞桨开源框架构建 PP-TSN 模型的方法。
1.2 实验内容
随着互联网上视频的规模日益庞大,人们急切需要研究视频相关算法帮助人们更加容易地找到感兴趣内容的视频。而视频分类算法能够实现自动分析视频所包含的语义信息、理解其内容,对视频进行自动标注、分类和描述,达到与人媲美的准确率。视频分类是继图像分类问题后下一个急需解决的关键任务。
视频分类的主要目标是理解视频中包含的内容,确定视频对应的几个关键主题。视频分类(Video Classification)算法将基于视频的语义内容如人类行为和复杂事件等,将视频片段自动分类至单个或多个类别。视频分类不仅仅是要理解视频中的每一帧图像,更重要的是要识别出能够描述视频的少数几个最佳关键主题。本实验将在视频分类数据集Kinectics400上给大家介绍视频分类模型TSN的优化版本PP-TSN。
1.3 实验环境
本实验支持在实训平台或本地环境操作,建议您使用实训平台。
实训平台:如果您选择在实训平台上操作,无需安装实验环境。实训平台集成了实验必须的相关环境,代码可在线运行,同时还提供了免费算力,即使实践复杂模型也无算力之忧。本地环境:如果您选择在本地环境上操作,需要安装 Python3.7、飞桨开源框架 2.1 等实验必须的环境。
可以通过如下代码导入实验环境。
In [1]
# coding=utf-8# 导入环境import numpy as npfrom abc import abstractmethodimport paddlefrom paddle import ParamAttrimport paddle.nn as nnfrom paddle.nn import AdaptiveAvgPool2D, Linear, Dropout,MaxPool2D, AvgPool2D,Conv2D, BatchNormimport paddle.nn.functional as Ffrom paddle.regularizer import L2Decayimport paddle.distributed as distfrom abc import ABC, abstractmethodfrom paddle.io import Datasetimport os.path as ospimport copyfrom paddle.optimizer.lr import *import osimport sysfrom tqdm import tqdmimport timeimport paddle.nn.initializer as initfrom collections.abc import Sequenceimport mathfrom collections import OrderedDictimport loggingfrom paddle.distributed import ParallelEnvimport randomimport datetimeimport tracebackfrom PIL import Imageimport cv2import glob
1.4 实验设计
实现方案如下图所示,对于一条输入的视频数据,首先使用卷积网络提取特征,获取特征表示;然后使用分类器获取属于每类视频动作的概率值。在训练阶段,通过模型输出的概率值与样本的真实标签构建损失函数,从而进行模型训练;在推理阶段,选出概率最大的类别作为最终的输出。
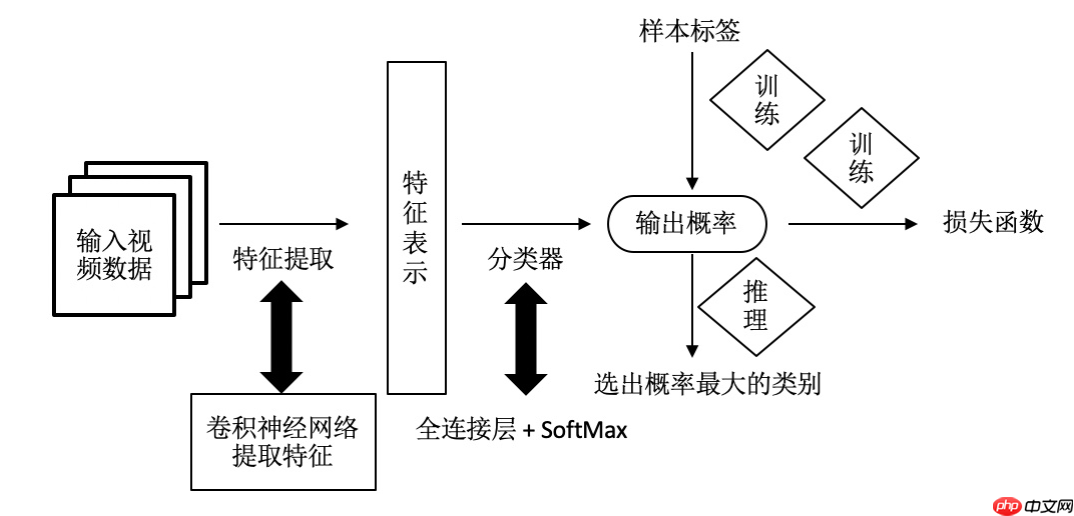
实现方案
2. 实验详细实现
实验流程主要分为以下7个部分:
数据准备:根据网络接收的数据格式,完成相应的预处理操作,保证模型正常读取;模型构建:设计视频分类模型;训练配置:实例化模型,指定模型采用的寻解算法(优化器);模型训练:执行多轮训练不断调整参数,以达到较好的效果;模型保存:保存模型参数;模型评估:对训练好的模型进行评估测试,观察准确率和损失变化;模型推理:使用一条视频数据验证模型分类效果;
2.1 数据准备
2.1.1 数据集简介
UCF101数据集 是一个动作识别数据集,包含现实的动作视频,从 YouTube 上收集,有 101 个动作类别。该数据集是 UCF50 数据集的扩展,该数据集有 50 个动作类别。从 101 个动作类的 13320 个视频中,UCF101 给出了最大的多样性,并且在摄像机运动、物体外观和姿态、物体尺度、视点、杂乱背景、光照条件等方面存在较大的差异,这是迄今为止最具挑战性的数据。
由于大多数可用的动作识别数据集都不现实,而且是由参与者进行的,UCF101 旨在通过学习和探索新的现实行动类别来鼓励进一步研究行动识别。 101 个动作类的视频中,动作类别可以分为5类,如下图中5种颜色的标注:
Human-Object InteractionBody-Motion OnlyHuman-Human InteractionPlaying Musical InstrumentsSports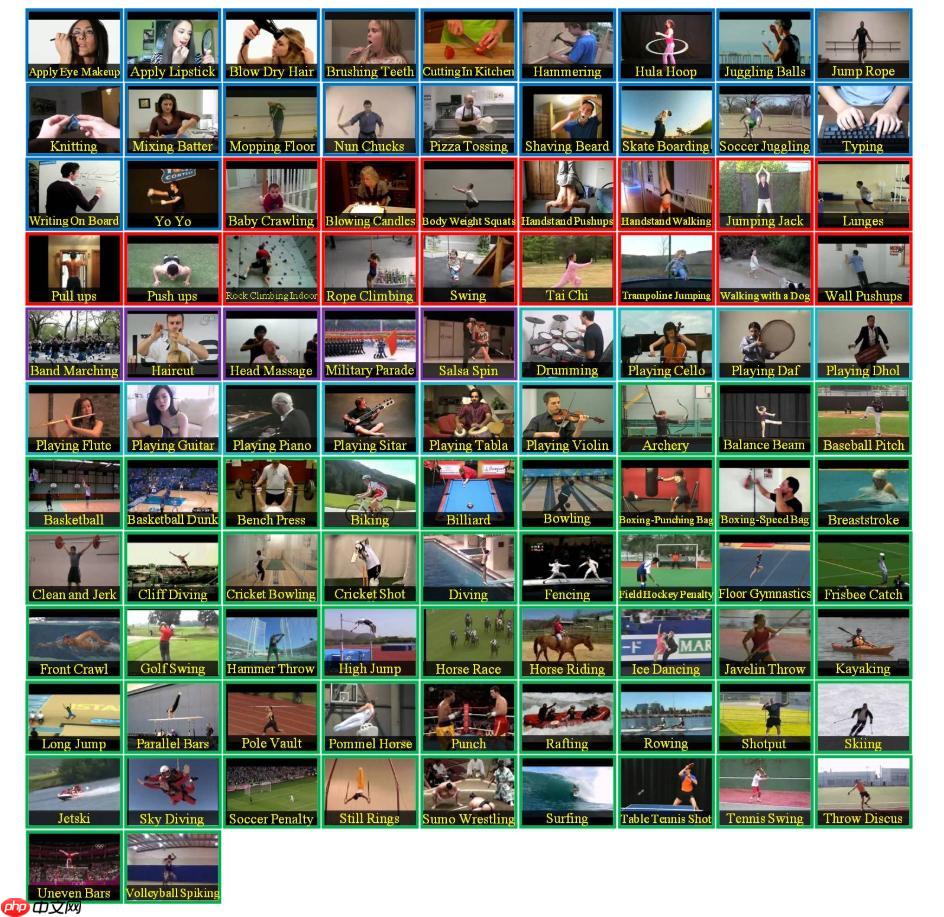
UCF101数据集
2.1.2 数据准备
本小节代码只需要运行一次即可,根据需要注释或者取消注释。
以下程序大概需要运行1分多钟。
In [5]
%cd /home/aistudio/work/data# data下ucf101文件夹用于存放ucf101数据集#! mkdir /home/aistudio/work/data/ucf101 # 将数据解压到/home/aistudio/work/data/ucf101目录下面#! unzip -d /home/aistudio/work/data/ucf101 /home/aistudio/data/data73202/UCF-101.zip#! mv /home/aistudio/work/data/ucf101/UCF-101 /home/aistudio/work/data/ucf101/videos# 将标注解压到/home/aistudio/work/data/ucf101目录下面#! unzip -d /home/aistudio/work/data/ucf101 /home/aistudio/data/data73202/UCF101TrainTestSplits-RecognitionTask.zip#! mv /home/aistudio/work/data/ucf101/ucfTrainTestlist/ /home/aistudio/work/data/ucf101/annotations
/home/aistudio/work/data
提取视频文件的frames
为了加速网络的训练过程,我们首先对视频文件(ucf101视频文件为avi格式)提取帧 (frames)。相对于直接通过视频文件进行网络训练的方式,frames的方式能够加快网络训练的速度。视频文件frames提取完成后,会存储在./rawframes文件夹下。
以下程序运行大概需要30分钟,仅执行一次即可。
In [6]
from multiprocessing import Pool, current_processout_dir='/home/aistudio/work/data/ucf101/rawframes'src_dir = '/home/aistudio/work/data/ucf101/videos'ext = 'avi'num_worker = 8level = 2def dump_frames(vid_item): full_path, vid_path, vid_id = vid_item vid_name = vid_path.split('.')[0] out_full_path = osp.join(out_dir, vid_name) try: os.mkdir(out_full_path) except OSError: pass vr = cv2.VideoCapture(full_path) videolen = int(vr.get(cv2.CAP_PROP_FRAME_COUNT)) for i in range(videolen): ret, frame = vr.read() if ret == False: continue img = frame[:, :, ::-1] # covert the BGR img img = cv2.cvtColor(img, cv2.COLOR_RGB2BGR) if img is not None: # cv2.imwrite will write BGR into RGB images cv2.imwrite('{}/img_{:05d}.jpg'.format(out_full_path, i + 1), img) else: print('[Warning] length inconsistent!' 'Early stop with {} out of {} frames'.format(i + 1, videolen)) break print('{} done with {} frames'.format(vid_name, videolen)) sys.stdout.flush() return True# 多进程的方式提取视频帧def extract_frames(): if not osp.isdir(out_dir): print('Creating folder: {}'.format(out_dir)) os.makedirs(out_dir) if level == 2: classes = os.listdir(src_dir) for classname in classes: new_dir = osp.join(out_dir, classname) if not osp.isdir(new_dir): print('Creating folder: {}'.format(new_dir)) os.makedirs(new_dir) print('Reading videos from folder: ', src_dir) print('Extension of videos: ', ext) if level == 2: fullpath_list = glob.glob(src_dir + '/*/*.' + ext) done_fullpath_list = glob.glob(out_dir + '/*/*') elif level == 1: fullpath_list = glob.glob(src_dir + '/*.' + ext) done_fullpath_list = glob.glob(out_dir + '/*') print('Total number of videos found: ', len(fullpath_list)) if level == 2: vid_list = list( map(lambda p: osp.join('/'.join(p.split('/')[-2:])), fullpath_list)) elif level == 1: vid_list = list(map(lambda p: p.split('/')[-1], fullpath_list)) pool = Pool(num_worker) pool.map(dump_frames, zip(fullpath_list, vid_list, range(len(vid_list))))#extract_frames() #首次运行请取消注释
生成frames和videos文件路径list。
In [7]
num_split = 3shuffle = Falseout_path = '/home/aistudio/work/data/ucf101/'rgb_prefix = 'img_'def parse_directory(path, key_func=lambda x: x[-11:], rgb_prefix='img_', level=1): """ Parse directories holding extracted frames from standard benchmarks """ print('parse frames under folder {}'.format(path)) if level == 1: frame_folders = glob.glob(os.path.join(path, '*')) elif level == 2: frame_folders = glob.glob(os.path.join(path, '*', '*')) else: raise ValueError('level can be only 1 or 2') def count_files(directory, prefix_list): lst = os.listdir(directory) cnt_list = [len(fnmatch.filter(lst, x + '*')) for x in prefix_list] return cnt_list # check RGB frame_dict = {} for i, f in enumerate(frame_folders): all_cnt = count_files(f, (rgb_prefix)) k = key_func(f) x_cnt = all_cnt[1] y_cnt = all_cnt[2] if x_cnt != y_cnt: raise ValueError('x and y direction have different number ' 'of flow images. video: ' + f) if i % 200 == 0: print('{} videos parsed'.format(i)) frame_dict[k] = (f, all_cnt[0], x_cnt) print('frame folder analysis done') return frame_dictdef build_split_list(split, frame_info, shuffle=False): def build_set_list(set_list): rgb_list = list() for item in set_list: if item[0] not in frame_info: continue elif frame_info[item[0]][1] > 0: rgb_cnt = frame_info[item[0]][1] rgb_list.append('{} {} {}n'.format(item[0], rgb_cnt, item[1])) else: rgb_list.append('{} {}n'.format(item[0], item[1])) if shuffle: random.shuffle(rgb_list) return rgb_list train_rgb_list = build_set_list(split[0]) test_rgb_list = build_set_list(split[1]) return (train_rgb_list, test_rgb_list)def parse_ucf101_splits(level): class_ind = [x.strip().split() for x in open('/home/aistudio/work/data/ucf101/annotations/classInd.txt')] class_mapping = {x[1]: int(x[0]) - 1 for x in class_ind} def line2rec(line): items = line.strip().split(' ') vid = items[0].split('.')[0] vid = '/'.join(vid.split('/')[-level:]) label = class_mapping[items[0].split('/')[0]] return vid, label splits = [] for i in range(1, 4): train_list = [ line2rec(x) for x in open('/home/aistudio/work/data/ucf101/annotations/trainlist{:02d}.txt'.format(i)) ] test_list = [ line2rec(x) for x in open('/home/aistudio/work/data/ucf101/annotations/testlist{:02d}.txt'.format(i)) ] splits.append((train_list, test_list)) return splitsdef key_func(x): return '/'.join(x.split('/')[-2:])
In [8]
import fnmatchframe_path = '/home/aistudio/work/data/ucf101/rawframes'def get_frames_file_list(): frame_info = parse_directory( frame_path, key_func=key_func, rgb_prefix=rgb_prefix, level=level) split_tp = parse_ucf101_splits(level) assert len(split_tp) == num_split for i, split in enumerate(split_tp): lists = build_split_list(split_tp[i], frame_info, shuffle=shuffle) filename = 'ucf101_train_split_{}_{}.txt'.format(i + 1, 'rawframes') PATH = os.path.abspath(frame_path) with open(os.path.join(out_path, filename), 'w') as f: f.writelines([os.path.join(PATH, item) for item in lists[0]]) filename = 'ucf101_val_split_{}_{}.txt'.format(i + 1, 'rawframes') with open(os.path.join(out_path, filename), 'w') as f: f.writelines([os.path.join(PATH, item) for item in lists[1]])#get_frames_file_list() #首次运行取消注释
In [9]
def extract_videos_file_list(): video_list = glob.glob(os.path.join(frame_path, '*', '*')) frame_info = { os.path.relpath(x.split('.')[0], frame_path): (x, -1, -1) for x in video_list } split_tp = parse_ucf101_splits(level) assert len(split_tp) == num_split for i, split in enumerate(split_tp): lists = build_split_list(split_tp[i], frame_info, shuffle=shuffle) filename = 'ucf101_train_split_{}_{}.txt'.format(i + 1, 'videos') PATH = os.path.abspath(frame_path) with open(os.path.join(out_path, filename), 'w') as f: f.writelines([os.path.join(PATH, item) for item in lists[0]]) filename = 'ucf101_val_split_{}_{}.txt'.format(i + 1, 'videos') with open(os.path.join(out_path, filename), 'w') as f: f.writelines([os.path.join(PATH, item) for item in lists[1]])#extract_videos_file_list()#首次运行取消注释
UCF101 数据文件组织形式如下所示:
├── ucf101│ ├── ucf101_{train,val}_split_{1,2,3}_rawframes.txt│ ├── ucf101_{train,val}_split_{1,2,3}_videos.txt│ ├── annotations│ ├── videos│ │ ├── ApplyEyeMakeup│ │ │ ├── v_ApplyEyeMakeup_g01_c01.avi│ │ │ └── ...│ │ ├── YoYo│ │ │ ├── v_YoYo_g25_c05.avi│ │ │ └── ...│ │ └── ...│ ├── rawframes│ │ ├── ApplyEyeMakeup│ │ │ ├── v_ApplyEyeMakeup_g01_c01│ │ │ │ ├── img_00001.jpg│ │ │ │ ├── img_00002.jpg│ │ │ │ ├── ...│ │ │ │ ├── flow_x_00001.jpg│ │ │ │ ├── flow_x_00002.jpg│ │ │ │ ├── ...│ │ │ │ ├── flow_y_00001.jpg│ │ │ │ ├── flow_y_00002.jpg│ │ ├── ...│ │ ├── YoYo│ │ │ ├── v_YoYo_g01_c01│ │ │ ├── ...│ │ │ ├── v_YoYo_g25_c05
其中,ucf101_{train,val}_split_{1,2,3}_rawframes.txt 中存放的是帧信息,部分内容展示如下:
/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g08_c01 120 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g08_c02 117 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g08_c03 146 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g08_c04 224 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g08_c05 276 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c01 176 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c02 258 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c03 210 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c04 191 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c05 194 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c06 188 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c07 261 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g10_c01 153 0...
第一个元素表示视频帧目录,第二个元素表示目录下帧的个数,第三个元素表示该视频的类别。
ucf101_{train,val}_split_{1,2,3}_videos.txt 中存放的视频信息,部分内容展示如下:
/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c04 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c05 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c06 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g09_c07 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g10_c01 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g10_c02 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g10_c03 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g10_c04 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g10_c05 0/home/aistudio/work/data/ucf101/rawframes/ApplyEyeMakeup/v_ApplyEyeMakeup_g11_c01 0
第一个元素表示视频文件路径,第二个元素表示该视频文件中的帧数。
注:annotation 目录下存放的数据的类别信息和数据的划分信息;videos 目录下存放的数据集的原始视频文件;frames 目录下存放的是从原始视频文件中抽取出的帧信息。
2.1.3 数据预处理
数据处理格式
设置数据处理的格式,这里将数据处理的格式设置为 frame。具体代码如下。
In [10]
class FrameDecoder(object): """just parse results """ def __init__(self): pass def __call__(self, results): results['format'] = 'frame' return results
帧采样
对一段视频进行分段采样,输入为采样序列的个数和每个序列的长度,代码实现如下:
In [11]
class Sampler(object): """ Sample frames id. NOTE: Use PIL to read image here, has diff with CV2 Args: num_seg(int): number of segments. seg_len(int): number of sampled frames in each segment. valid_mode(bool): True or False. select_left: Whether to select the frame to the left in the middle when the sampling interval is even in the test mode. Returns: frames_idx: the index of sampled #frames. """ def __init__(self, num_seg, seg_len, valid_mode=False, select_left=False, dense_sample=False, linspace_sample=False): self.num_seg = num_seg self.seg_len = seg_len self.valid_mode = valid_mode self.select_left = select_left self.dense_sample = dense_sample self.linspace_sample = linspace_sample def _get(self, frames_idx, results): data_format = results['format'] if data_format == "frame": frame_dir = results['frame_dir'] imgs = [] for idx in frames_idx: img = Image.open( os.path.join(frame_dir, results['suffix'].format(idx))).convert('RGB') imgs.append(img) elif data_format == "video": if results['backend'] == 'cv2': frames = np.array(results['frames']) imgs = [] for idx in frames_idx: imgbuf = frames[idx] img = Image.fromarray(imgbuf, mode='RGB') imgs.append(img) elif results['backend'] == 'decord': vr = results['frames'] frames_select = vr.get_batch(frames_idx) # dearray_to_img np_frames = frames_select.asnumpy() imgs = [] for i in range(np_frames.shape[0]): imgbuf = np_frames[i] imgs.append(Image.fromarray(imgbuf, mode='RGB')) elif results['backend'] == 'pyav': imgs = [] frames = np.array(results['frames']) for idx in frames_idx: imgbuf = frames[idx] imgs.append(imgbuf) imgs = np.stack(imgs) # thwc else: raise NotImplementedError else: raise NotImplementedError results['imgs'] = imgs return results def __call__(self, results): """ Args: frames_len: length of frames. return: sampling id. """ frames_len = int(results['frames_len']) average_dur = int(frames_len / self.num_seg) frames_idx = [] if self.linspace_sample: if 'start_idx' in results and 'end_idx' in results: offsets = np.linspace(results['start_idx'], results['end_idx'], self.num_seg) else: offsets = np.linspace(0, frames_len - 1, self.num_seg) offsets = np.clip(offsets, 0, frames_len - 1).astype(np.long) if results['format'] == 'video': frames_idx = list(offsets) frames_idx = [x % frames_len for x in frames_idx] elif results['format'] == 'frame': frames_idx = list(offsets + 1) else: raise NotImplementedError return self._get(frames_idx, results) if not self.select_left: if self.dense_sample: # For ppTSM if not self.valid_mode: # train sample_pos = max(1, 1 + frames_len - 64) t_stride = 64 // self.num_seg start_idx = 0 if sample_pos == 1 else np.random.randint( 0, sample_pos - 1) offsets = [(idx * t_stride + start_idx) % frames_len + 1 for idx in range(self.num_seg)] frames_idx = offsets else: sample_pos = max(1, 1 + frames_len - 64) t_stride = 64 // self.num_seg start_list = np.linspace(0, sample_pos - 1, num=10, dtype=int) offsets = [] for start_idx in start_list.tolist(): offsets += [ (idx * t_stride + start_idx) % frames_len + 1 for idx in range(self.num_seg) ] frames_idx = offsets else: for i in range(self.num_seg): idx = 0 if not self.valid_mode: if average_dur >= self.seg_len: idx = random.randint(0, average_dur - self.seg_len) idx += i * average_dur elif average_dur >= 1: idx += i * average_dur else: idx = i else: if average_dur >= self.seg_len: idx = (average_dur - 1) // 2 idx += i * average_dur elif average_dur >= 1: idx += i * average_dur else: idx = i for jj in range(idx, idx + self.seg_len): if results['format'] == 'video': frames_idx.append(int(jj % frames_len)) elif results['format'] == 'frame': frames_idx.append(jj + 1) else: raise NotImplementedError return self._get(frames_idx, results) else: # for TSM if not self.valid_mode: if average_dur > 0: offsets = np.multiply(list(range(self.num_seg)), average_dur) + np.random.randint( average_dur, size=self.num_seg) elif frames_len > self.num_seg: offsets = np.sort( np.random.randint(frames_len, size=self.num_seg)) else: offsets = np.zeros(shape=(self.num_seg, )) else: if frames_len > self.num_seg: average_dur_float = frames_len / self.num_seg offsets = np.array([ int(average_dur_float / 2.0 + average_dur_float * x) for x in range(self.num_seg) ]) else: offsets = np.zeros(shape=(self.num_seg, )) if results['format'] == 'video': frames_idx = list(offsets) frames_idx = [x % frames_len for x in frames_idx] elif results['format'] == 'frame': frames_idx = list(offsets + 1) else: raise NotImplementedError return self._get(frames_idx, results)
图片尺度化
图片尺度化的目的是将图片中短边 resize 到固定的尺寸,图片中的长边按照等比例进行缩放。具体实现代码如下:
In [12]
class Scale(object): """ Scale images. Args: short_size(float | int): Short size of an image will be scaled to the short_size. fixed_ratio(bool): Set whether to zoom according to a fixed ratio. default: True do_round(bool): Whether to round up when calculating the zoom ratio. default: False backend(str): Choose pillow or cv2 as the graphics processing backend. default: 'pillow' """ def __init__(self, short_size, fixed_ratio=True, do_round=False, backend='pillow'): self.short_size = short_size self.fixed_ratio = fixed_ratio self.do_round = do_round assert backend in [ 'pillow', 'cv2' ], f"Scale's backend must be pillow or cv2, but get {backend}" self.backend = backend def __call__(self, results): """ Performs resize operations. Args: imgs (Sequence[PIL.Image]): List where each item is a PIL.Image. For example, [PIL.Image0, PIL.Image1, PIL.Image2, ...] return: resized_imgs: List where each item is a PIL.Image after scaling. """ imgs = results['imgs'] resized_imgs = [] for i in range(len(imgs)): img = imgs[i] w, h = img.size if (w <= h and w == self.short_size) or (h <= w and h == self.short_size): resized_imgs.append(img) continue if w < h: ow = self.short_size if self.fixed_ratio: oh = int(self.short_size * 4.0 / 3.0) else: oh = int(round(h * self.short_size / w)) if self.do_round else int( h * self.short_size / w) else: oh = self.short_size if self.fixed_ratio: ow = int(self.short_size * 4.0 / 3.0) else: ow = int(round(w * self.short_size / h)) if self.do_round else int( w * self.short_size / h) if self.backend == 'pillow': resized_imgs.append(img.resize((ow, oh), Image.BILINEAR)) else: resized_imgs.append( Image.fromarray( cv2.resize(np.asarray(img), (ow, oh), interpolation=cv2.INTER_LINEAR))) results['imgs'] = resized_imgs return results
多尺度裁剪
从多个尺度中随机选择一个裁剪尺度,并计算具体裁剪起始位置以及宽和高,之后从原图中裁剪出随机的固定区域。具体的实现代码如下。
In [13]
class MultiScaleCrop(object): """ Random crop images in with multiscale sizes Args: target_size(int): Random crop a square with the target_size from an image. scales(int): List of candidate cropping scales. max_distort(int): Maximum allowable deformation combination distance. fix_crop(int): Whether to fix the cutting start point. allow_duplication(int): Whether to allow duplicate candidate crop starting points. more_fix_crop(int): Whether to allow more cutting starting points. """ def __init__( self, target_size, # NOTE: named target size now, but still pass short size in it! scales=None, max_distort=1, fix_crop=True, allow_duplication=False, more_fix_crop=True, backend='pillow'): self.target_size = target_size self.scales = scales if scales else [1, .875, .75, .66] self.max_distort = max_distort self.fix_crop = fix_crop self.allow_duplication = allow_duplication self.more_fix_crop = more_fix_crop assert backend in [ 'pillow', 'cv2' ], f"MultiScaleCrop's backend must be pillow or cv2, but get {backend}" self.backend = backend def __call__(self, results): """ Performs MultiScaleCrop operations. Args: imgs: List where wach item is a PIL.Image. XXX: results: """ imgs = results['imgs'] input_size = [self.target_size, self.target_size] im_size = imgs[0].size # get random crop offset def _sample_crop_size(im_size): image_w, image_h = im_size[0], im_size[1] base_size = min(image_w, image_h) crop_sizes = [int(base_size * x) for x in self.scales] crop_h = [ input_size[1] if abs(x - input_size[1]) < 3 else x for x in crop_sizes ] crop_w = [ input_size[0] if abs(x - input_size[0]) < 3 else x for x in crop_sizes ] pairs = [] for i, h in enumerate(crop_h): for j, w in enumerate(crop_w): if abs(i - j) <= self.max_distort: pairs.append((w, h)) crop_pair = random.choice(pairs) if not self.fix_crop: w_offset = random.randint(0, image_w - crop_pair[0]) h_offset = random.randint(0, image_h - crop_pair[1]) else: w_step = (image_w - crop_pair[0]) / 4 h_step = (image_h - crop_pair[1]) / 4 ret = list() ret.append((0, 0)) # upper left if self.allow_duplication or w_step != 0: ret.append((4 * w_step, 0)) # upper right if self.allow_duplication or h_step != 0: ret.append((0, 4 * h_step)) # lower left if self.allow_duplication or (h_step != 0 and w_step != 0): ret.append((4 * w_step, 4 * h_step)) # lower right if self.allow_duplication or (h_step != 0 or w_step != 0): ret.append((2 * w_step, 2 * h_step)) # center if self.more_fix_crop: ret.append((0, 2 * h_step)) # center left ret.append((4 * w_step, 2 * h_step)) # center right ret.append((2 * w_step, 4 * h_step)) # lower center ret.append((2 * w_step, 0 * h_step)) # upper center ret.append((1 * w_step, 1 * h_step)) # upper left quarter ret.append((3 * w_step, 1 * h_step)) # upper right quarter ret.append((1 * w_step, 3 * h_step)) # lower left quarter ret.append((3 * w_step, 3 * h_step)) # lower righ quarter w_offset, h_offset = random.choice(ret) return crop_pair[0], crop_pair[1], w_offset, h_offset crop_w, crop_h, offset_w, offset_h = _sample_crop_size(im_size) crop_img_group = [ img.crop((offset_w, offset_h, offset_w + crop_w, offset_h + crop_h)) for img in imgs ] if self.backend == 'pillow': ret_img_group = [ img.resize((input_size[0], input_size[1]), Image.BILINEAR) for img in crop_img_group ] else: ret_img_group = [ Image.fromarray( cv2.resize(np.asarray(img), dsize=(input_size[0], input_size[1]), interpolation=cv2.INTER_LINEAR)) for img in crop_img_group ] results['imgs'] = ret_img_group return results
中心裁剪
中心裁剪与随机裁剪类似,具体的差异在于选取裁剪起始点的方法不同。具体实现代码如下。
In [14]
class CenterCrop(object): """ Center crop images. Args: target_size(int): Center crop a square with the target_size from an image. do_round(bool): Whether to round up the coordinates of the upper left corner of the cropping area. default: True """ def __init__(self, target_size, do_round=True): self.target_size = target_size self.do_round = do_round def __call__(self, results): """ Performs Center crop operations. Args: imgs: List where each item is a PIL.Image. For example, [PIL.Image0, PIL.Image1, PIL.Image2, ...] return: ccrop_imgs: List where each item is a PIL.Image after Center crop. """ imgs = results['imgs'] ccrop_imgs = [] for img in imgs: w, h = img.size th, tw = self.target_size, self.target_size assert (w >= self.target_size) and (h >= self.target_size), "image width({}) and height({}) should be larger than crop size".format( w, h, self.target_size) x1 = int(round((w - tw) / 2.0)) if self.do_round else (w - tw) // 2 y1 = int(round((h - th) / 2.0)) if self.do_round else (h - th) // 2 ccrop_imgs.append(img.crop((x1, y1, x1 + tw, y1 + th))) results['imgs'] = ccrop_imgs return results
随机翻转
对图片进行随机的翻转。具体实现代码如下。
In [15]
class RandomFlip(object): """ Random Flip images. Args: p(float): Random flip images with the probability p. """ def __init__(self, p=0.5): self.p = p def __call__(self, results): """ Performs random flip operations. Args: imgs: List where each item is a PIL.Image. For example, [PIL.Image0, PIL.Image1, PIL.Image2, ...] return: flip_imgs: List where each item is a PIL.Image after random flip. """ imgs = results['imgs'] v = random.random() if v < self.p: if 'backend' in results and results[ 'backend'] == 'pyav': # [c,t,h,w] results['imgs'] = paddle.flip(imgs, axis=[3]) else: results['imgs'] = [ img.transpose(Image.FLIP_LEFT_RIGHT) for img in imgs ] else: results['imgs'] = imgs return results
数据格式转换
将数据转换为 numpy 类型。具体的实现代码如下。
In [16]
class Image2Array(object): """ transfer PIL.Image to Numpy array and transpose dimensions from 'dhwc' to 'dchw'. Args: transpose: whether to transpose or not, default False. True for tsn. """ def __init__(self, transpose=True): self.transpose = transpose def __call__(self, results): """ Performs Image to NumpyArray operations. Args: imgs: List where each item is a PIL.Image. For example, [PIL.Image0, PIL.Image1, PIL.Image2, ...] return: np_imgs: Numpy array. """ imgs = results['imgs'] # 将 list 转为 numpy np_imgs = (np.stack(imgs)).astype('float32') if self.transpose: # 对维度进行交换 np_imgs = np_imgs.transpose(0, 3, 1, 2) # nchw results['imgs'] = np_imgs # 将处理过的图片复制给键值 imgs return results
归一化
通过使用均值和方差,对数据集做归一化处理。具体的代码如下。
In [17]
class Normalization(object): """ Normalization. Args: mean(Sequence[float]): mean values of different channels. std(Sequence[float]): std values of different channels. tensor_shape(list): size of mean, default [3,1,1]. For slowfast, [1,1,1,3] """ def __init__(self, mean, std, tensor_shape=[3, 1, 1]): if not isinstance(mean, Sequence): raise TypeError(f'Mean must be list, tuple or np.ndarray, but got {type(mean)}') if not isinstance(std, Sequence): raise TypeError(f'Std must be list, tuple or np.ndarray, but got {type(std)}') self.mean = np.array(mean).reshape(tensor_shape).astype(np.float32) self.std = np.array(std).reshape(tensor_shape).astype(np.float32) def __call__(self, results): """ Performs normalization operations. Args: imgs: Numpy array. return: np_imgs: Numpy array after normalization. """ imgs = results['imgs'] norm_imgs = imgs / 255. # 除以 255 norm_imgs -= self.mean # 减去均值 norm_imgs /= self.std # 除以方差 results['imgs'] = norm_imgs # 将处理过的图片复制给键值 imgs return results
TenCrop
模型测试阶段用,TenCrop操作会使一张图片变为10张,即时序上,将待输入视频均匀分成num_seg段区间,每段的中间位置采样1帧;空间上,从左上角、右上角、中心点、左下角、右下角5个子区域各采样224×224的区域,并加上水平翻转,一共得到10个采样结果。1个视频共采样1个clip。
具体代码如下:
In [18]
class TenCrop: """ Crop out 5 regions (4 corner points + 1 center point) from the picture, and then flip the cropping result to get 10 cropped images, which can make the prediction result more robust. Args: target_size(int | tuple[int]): (w, h) of target size for crop. """ def __init__(self, target_size): self.target_size = (target_size, target_size) def __call__(self, results): imgs = results['imgs'] img_w, img_h = imgs[0].size crop_w, crop_h = self.target_size w_step = (img_w - crop_w) // 4 h_step = (img_h - crop_h) // 4 offsets = [ (0, 0), (4 * w_step, 0), (0, 4 * h_step), (4 * w_step, 4 * h_step), (2 * w_step, 2 * h_step), ] img_crops = list() for x_offset, y_offset in offsets: crop = [ img.crop( (x_offset, y_offset, x_offset + crop_w, y_offset + crop_h)) for img in imgs ] crop_fliped = [ timg.transpose(Image.FLIP_LEFT_RIGHT) for timg in crop ] img_crops.extend(crop) img_crops.extend(crop_fliped) results['imgs'] = img_crops return results
2.1.4 数据预处理模块组合
为了方便处理,对上述所有的数据预处理模块进行封装。
In [19]
class Compose(object): """ Composes several pipelines(include decode func, sample func, and transforms) together. Note: To deal with ```list``` type cfg temporaray, like: transform: - Crop: # A list attribute: 10 - Resize: # A list attribute: 20 every key of list will pass as the key name to build a module. XXX: will be improved in the future. Args: pipelines (list): List of transforms to compose. Returns: A compose object which is callable, __call__ for this Compose object will call each given :attr:`transforms` sequencely. """ # mode: Train,Valid,Test def __init__(self, mode='Train'): # assert isinstance(pipelines, Sequence) self.pipelines = list() self.pipelines.append(FrameDecoder()) if mode=="Train": self.pipelines.append(Sampler(num_seg=3, seg_len=1, valid_mode=False,select_left=True)) self.pipelines.append(Scale(short_size=256,fixed_ratio=False,do_round=True,backend='cv2')) self.pipelines.append(MultiScaleCrop(target_size=224,allow_duplication=True,more_fix_crop=True,backend='cv2')) self.pipelines.append(RandomFlip()) elif mode=="Valid": self.pipelines.append(Sampler(num_seg=3, seg_len=1, valid_mode=True,select_left=True)) self.pipelines.append(Scale(short_size=256,fixed_ratio=False,do_round=True,backend='cv2')) self.pipelines.append(CenterCrop(target_size=224,do_round=False)) elif mode=="Test": self.pipelines.append(Sampler(num_seg=25, seg_len=1, valid_mode=True,select_left=True)) self.pipelines.append(Scale(short_size=256,fixed_ratio=False,do_round=True,backend='cv2')) self.pipelines.append(TenCrop(target_size=224)) else: raise ValueError("Mode should be one of ['Train','Valid','Test'], and the default mode is 'Train'.") self.pipelines.append(Image2Array()) self.pipelines.append(Normalization(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])) def __call__(self, data): # 将传入的 data 依次经过 pipelines 中对象处理 for p in self.pipelines: try: data = p(data) except Exception as e: stack_info = traceback.format_exc() print("fail to perform transform [{}] with error: " "{} and stack:n{}".format(p, e, str(stack_info))) raise e return data
2.1.5 数据读取
本实验利用视频帧进行训练,所以定义FrameDataset类加载视频帧。
In [20]
class FrameDataset(Dataset, ABC): """Rawframe dataset for action recognition. The dataset loads raw frames from frame files, and apply specified transform operatation them. The indecx file is a text file with multiple lines, and each line indicates the directory of frames of a video, toatl frames of the video, and its label, which split with a whitespace. Example of an index file: .. code-block:: txt file_path-1 150 1 file_path-2 160 1 file_path-3 170 2 file_path-4 180 2 Args: file_path (str): Path to the index file. pipeline(XXX): data_prefix (str): directory path of the data. Default: None. test_mode (bool): Whether to bulid the test dataset. Default: False. suffix (str): suffix of file. Default: 'img_{:05}.jpg'. """ def __init__(self, file_path, pipeline, num_retries=5, data_prefix=None, test_mode=False, suffix='img_{:05}.jpg'): self.num_retries = num_retries self.suffix = suffix self.file_path = file_path self.data_prefix = osp.realpath(data_prefix) if data_prefix is not None and osp.isdir(data_prefix) else data_prefix self.test_mode = test_mode self.pipeline = pipeline self.info = self.load_file() def load_file(self): """Load index file to get video information.""" info = [] with open(self.file_path, 'r') as fin: for line in fin: line_split = line.strip().split() frame_dir, frames_len, labels = line_split frame_dir = os.path.join('data/k400/rawframes',frame_dir) if self.data_prefix is not None: frame_dir = osp.join(self.data_prefix, frame_dir) info.append( dict(frame_dir=frame_dir, suffix=self.suffix, frames_len=frames_len, labels=int(labels))) return info def prepare_train(self, idx): """Prepare the frames for training/valid given index. """ #Try to catch Exception caused by reading missing frames files for ir in range(self.num_retries): try: results = copy.deepcopy(self.info[idx]) results = self.pipeline(results) except Exception as e: print("Exception",e) #logger.info(e) if ir < self.num_retries - 1: logger.info( "Error when loading {}, have {} trys, will try again". format(results['frame_dir'], ir)) idx = random.randint(0, len(self.info) - 1) continue return results['imgs'], np.array([results['labels']]) def prepare_test(self, idx): """Prepare the frames for test given index. """ #Try to catch Exception caused by reading missing frames files for ir in range(self.num_retries): try: results = copy.deepcopy(self.info[idx]) results = self.pipeline(results) except Exception as e: #logger.info(e) if ir < self.num_retries - 1: logger.info( "Error when loading {}, have {} trys, will try again". format(results['frame_dir'], ir)) idx = random.randint(0, len(self.info) - 1) continue return results['imgs'], np.array([results['labels']]) def __len__(self): """get the size of the dataset.""" return len(self.info) def __getitem__(self, idx): """ Get the sample for either training or testing given index""" if self.test_mode: return self.prepare_test(idx) else: return self.prepare_train(idx)
数据预处理耗时较长,推荐使用 paddle.io.DataLoader API 中的 num_workers 参数,设置进程数量,实现多进程读取数据。
class paddle.io.DataLoader(dataset, batch_size=1, shuffle=False, num_workers=0)
关键参数含义如下:
batch_size (int|None) – 每 mini-batch 中样本个数;shuffle(bool) – 生成mini-batch索引列表时是否对索引打乱顺序;num_workers (int) – 加载数据的子进程个数 。
2.2 模型构建
2.2.1 PP-TSN 简介
依托丰富的视频模型优化经验,飞桨PaddleVideo团队总结并完善了一套通用的视频模型优化策略,将这套策略应用于TSN模型并取得显著收益,研发出PP-TSN模型。在基本不增加计算量的前提下,PP-TSN使用Kinetics-400数据集训练的精度可以提升到75.06%,达到同等Backbone下的3D模型SlowFast的精度区间,且推理速度快5.6倍,在精度和性能的平衡上具有显著的优势。
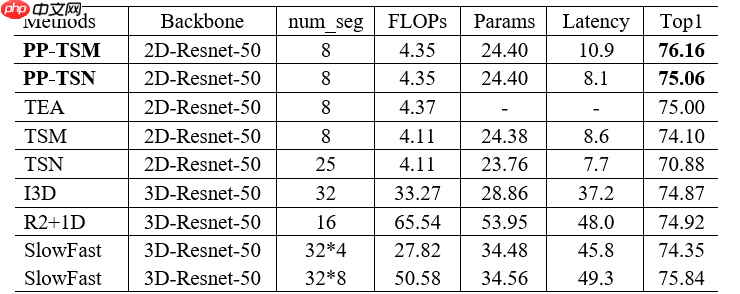
1.模型精度以实际测试为准,所有模型采用同一份数据进行训练测试。
2.PP-TSN的Top1精度介于SlowFast的两个版本之间,即达到同等Backbone下的3D模型SlowFast的精度区间。
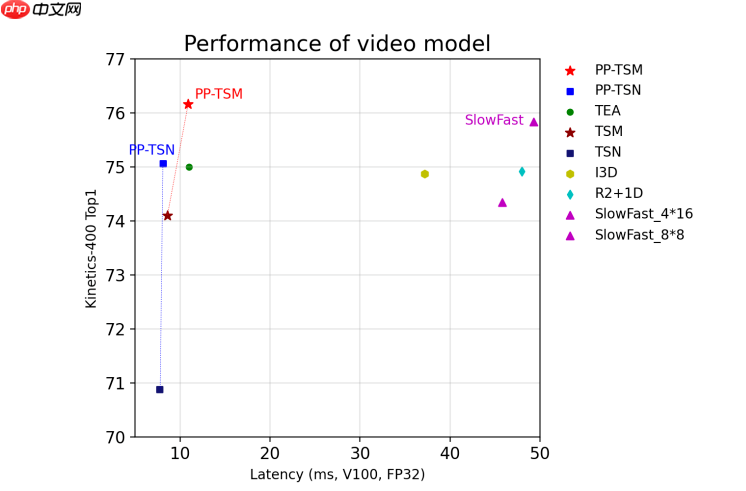
那PP-TSN到底采用了哪些优化策略呢?下面咱们带领大家一起来深入剖析一下飞桨团队算法优化的 “内功心法”。
数据增强Video Mix-up
众所周知Mix-up是图像领域常用的数据增强方法,它将两幅图像以一定的权值叠加构成新的输入图像。PaddleVideo团队通过合理扩展图像Mix-up,将其引入到视频数据增强中,让两个视频以一定的权值叠加构成新的输入视频。实际操作中,我们首先要从一个视频抽取固定数量的帧,并给每一帧赋予相同的权重,然后与另一个视频抽出来帧按一定比例进行叠加作为新的输入视频。结果表明,Mix-up能有效提升网络在时空上的鲁棒性,增强模型的泛化能力。另外,相较于图像,视频由于多了时间维度,混合的方式可以有更多的选择。
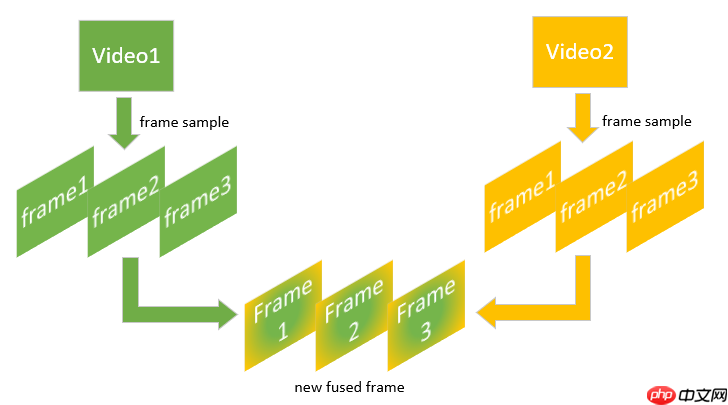
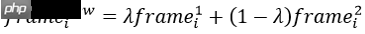
具体代码实现如下:
In [21]
class Mixup(object): """ Mixup operator. Args: alpha(float): alpha value. """ def __init__(self, alpha=0.2): assert alpha > 0., 'parameter alpha[%f] should > 0.0' % (alpha) self.alpha = alpha def __call__(self, batch): imgs, labels = list(zip(*batch)) imgs = np.array(imgs) labels = np.array(labels) bs = len(batch) idx = np.random.permutation(bs) lam = np.random.beta(self.alpha, self.alpha) lams = np.array([lam] * bs, dtype=np.float32) imgs = lam * imgs + (1 - lam) * imgs[idx] return list(zip(imgs, labels, labels[idx], lams))
更优的网络结构
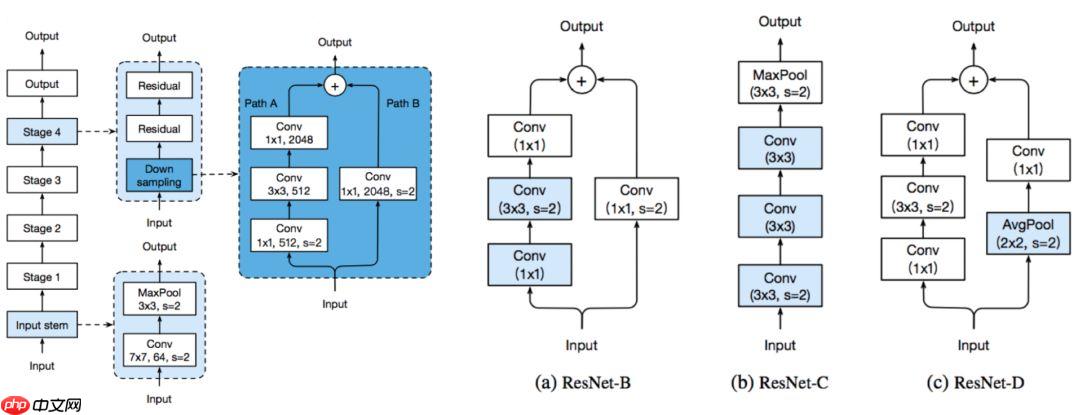
Better Backbone:骨干网络可以说是一个模型的基础,它决定了一个网络是否能提取有效的特征供后续任务使用,一个优秀的骨干网络会给模型的性能带来极大的提升。针对PP-TSN,飞桨研发人员使用更加优异的ResNet50_vd作为模型的骨干网络,在保持原有参数量的同时提升了模型精度。ResNet50_vd是指拥有50个卷积层的ResNet-D网络。如下图所示,ResNet系列网络在被提出后经过了B、C、D三个版本的改进。其中ResNet-B将Path A中1×1卷积的stride由2改为1,避免了信息丢失;ResNet-C将第一个7×7的卷积核调整为3个3×3卷积核,减少计算量的同时增加了网络非线性;ResNet-D进一步将Path B中1×1卷积的stride由2改为1,并添加了平均池化层,保留了更多的信息。
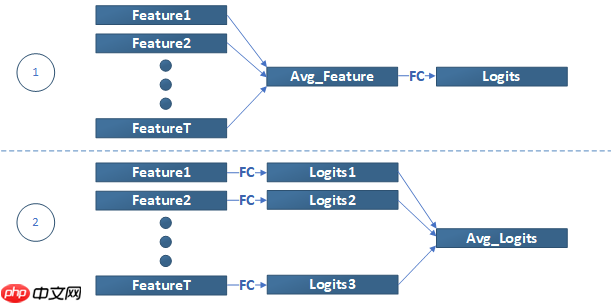
Feature aggregation:对PP-TSN模型,在骨干网络提取特征后,还需要使用分类器做特征分类。实验表明,在特征平均之后分类,可以减少frame-level特征的干扰,获得更高的精度。假设输入视频抽取的帧数为N,则经过骨干网络后,可以得到N个frame-level的特征。分类器有两种实现方式:第一种是先对N个frame-level特征进行平均,得到video-level特征后,再经过全连接层得到logits;另一种方式是先经过全连接层,得到N个frame-level的logits,再求平均。飞桨开发人员经过大量实验验证发现,采用第1种方式有更好的精度收益。
更稳定的训练策略
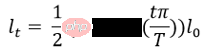
Cosine decay LR:在使用梯度下降算法优化目标函数时,我们使用余弦退火策略调整学习率。假设一共有T个step,在第t个step时学习率按以下公式更新。同时使用Warm-up策略,在模型训练之初选用较小的学习率,训练一段时间之后再使用预设的学习率训练,这使得收敛过程更加快速平滑。
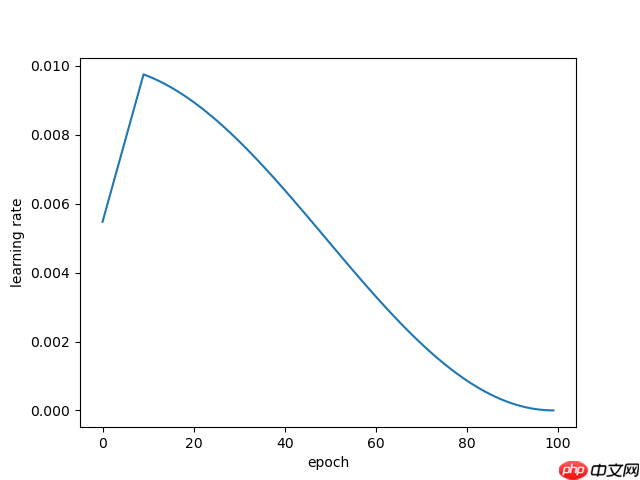
Scale fc learning rate:在训练过程中,我们给全连接层设置的学习率为其它层的5倍。实验结果表明,通过给分类器层设置更大的学习率,有助于网络更好的学习收敛,提升模型精度。
具体的代码实现如下:
In [22]
class CustomWarmupCosineDecay(LRScheduler): r""" We combine warmup and stepwise-cosine which is used in slowfast model. Args: warmup_start_lr (float): start learning rate used in warmup stage. warmup_epochs (int): the number epochs of warmup. cosine_base_lr (float|int, optional): base learning rate in cosine schedule. max_epoch (int): total training epochs. num_iters(int): number iterations of each epoch. last_epoch (int, optional): The index of last epoch. Can be set to restart training. Default: -1, means initial learning rate. verbose (bool, optional): If ``True``, prints a message to stdout for each update. Default: ``False`` . Returns: ``CosineAnnealingDecay`` instance to schedule learning rate. """ def __init__(self, warmup_start_lr, warmup_epochs, cosine_base_lr, max_epoch, num_iters, last_epoch=-1, verbose=False): self.warmup_start_lr = warmup_start_lr self.warmup_epochs = warmup_epochs self.cosine_base_lr = cosine_base_lr self.max_epoch = max_epoch self.num_iters = num_iters #call step() in base class, last_lr/last_epoch/base_lr will be update super(CustomWarmupCosineDecay, self).__init__(last_epoch=last_epoch, verbose=verbose) def step(self, epoch=None): """ ``step`` should be called after ``optimizer.step`` . It will update the learning rate in optimizer according to current ``epoch`` . The new learning rate will take effect on next ``optimizer.step`` . Args: epoch (int, None): specify current epoch. Default: None. Auto-increment from last_epoch=-1. Returns: None """ if epoch is None: if self.last_epoch == -1: self.last_epoch += 1 else: self.last_epoch += 1 / self.num_iters # update step with iters else: self.last_epoch = epoch self.last_lr = self.get_lr() if self.verbose: print('Epoch {}: {} set learning rate to {}.'.format( self.last_epoch, self.__class__.__name__, self.last_lr)) def _lr_func_cosine(self, cur_epoch, cosine_base_lr, max_epoch): return cosine_base_lr * (math.cos(math.pi * cur_epoch / max_epoch) + 1.0) * 0.5 def get_lr(self): """Define lr policy""" lr = self._lr_func_cosine(self.last_epoch, self.cosine_base_lr, self.max_epoch) lr_end = self._lr_func_cosine(self.warmup_epochs, self.cosine_base_lr, self.max_epoch) # Perform warm up. if self.last_epoch < self.warmup_epochs: lr_start = self.warmup_start_lr alpha = (lr_end - lr_start) / self.warmup_epochs lr = self.last_epoch * alpha + lr_start return lr
Label smooth
标签平滑是一种对分类器层进行正则化的机制,通过在真实的分类标签one-hot编码中真实类别的1上减去一个小量,非真实标签的0上加上一个小量,将硬标签变成一个软标签,达到正则化的作用,防止过拟合,提升模型泛化能力。
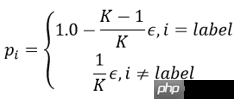
具体函数实现如下:
In [23]
def label_smooth_loss(self, scores, labels, **kwargs): labels = F.one_hot(labels, self.num_classes) labels = F.label_smooth(labels, epsilon=self.ls_eps) labels = paddle.squeeze(labels, axis=1) loss = self.loss_func(scores, labels, soft_label=True, **kwargs) return loss
Precise BN
Precise BN是一种获得给定模型更精确BN统计数据的技术,通过它可以获得更加平滑的评估曲线。
假定训练数据的分布和测试数据的分布是一致的,对于Batch Normalization层,通常在训练过程中会计算滑动均值和滑动方差,供测试时使用。滑动均值的计算方式如下:

但滑动均值并不等于真实的均值,尤其是在batch size比较小的时候容易受到单次统计量不稳定的影响。因此为了获取更加精确的均值和方差供BN层在测试时使用,在实验中,我们会在网络训练完一个epoch后,固定住网络中的参数不动,然后将训练数据输入网络仅做前向计算,根据每个step的均值和方差计算出整体训练样本的平均均值和方差,代替原本的指数滑动均值和方差,以此提升测试时的精度。
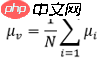
具体代码实现见do_preciseBN函数,输入参数包括需要重计算BN参数的模型,数据加载器data_loader,计算BN参数的迭代步数num_iters,模型返回BN层更加精准的均值和方差。
In [ ]
@paddle.no_grad() # speed up and save CUDA memorydef do_preciseBN(model, data_loader, parallel, num_iters=200): """ Recompute and update the batch norm stats to make them more precise. During training both BN stats and the weight are changing after every iteration, so the running average can not precisely reflect the actual stats of the current model. In this function, the BN stats are recomputed with fixed weights, to make the running average more precise. Specifically, it computes the true average of per-batch mean/variance instead of the running average. This is useful to improve validation accuracy. Args: model: the model whose bn stats will be recomputed data_loader: an iterator. Produce data as input to the model num_iters: number of iterations to compute the stats. Return: the model with precise mean and variance in bn layers. """ bn_layers_list = [ m for m in model.sublayers() if any((isinstance(m, bn_type) for bn_type in (paddle.nn.BatchNorm1D, paddle.nn.BatchNorm2D, paddle.nn.BatchNorm3D))) and m.training ] if len(bn_layers_list) == 0: return # moving_mean=moving_mean*momentum+batch_mean*(1.−momentum) # we set momentum=0. to get the true mean and variance during forward momentum_actual = [bn._momentum for bn in bn_layers_list] for bn in bn_layers_list: bn._momentum = 0. running_mean = [paddle.zeros_like(bn._mean) for bn in bn_layers_list] #pre-ignore running_var = [paddle.zeros_like(bn._variance) for bn in bn_layers_list] ind = -1 for ind, data in enumerate(itertools.islice(data_loader, num_iters)): logger.info("doing precise BN {} / {}...".format(ind + 1, num_iters)) if parallel: model._layers.train_step(data) else: model.train_step(data) for i, bn in enumerate(bn_layers_list): # Accumulates the bn stats. running_mean[i] += (bn._mean - running_mean[i]) / (ind + 1) running_var[i] += (bn._variance - running_var[i]) / (ind + 1) assert ind == num_iters - 1, ( "update_bn_stats is meant to run for {} iterations, but the dataloader stops at {} iterations." .format(num_iters, ind)) # Sets the precise bn stats. for i, bn in enumerate(bn_layers_list): bn._mean.set_value(running_mean[i]) bn._variance.set_value(running_var[i]) bn._momentum = momentum_actual[i]
知识蒸馏方案:Two Stages Knowledge Distillation
我们使用两阶段知识蒸馏方案提升模型精度。第一阶段使用半监督标签知识蒸馏方法对图像分类模型进行蒸馏,以获得具有更好分类效果的预训练模型。第二阶段使用更高精度的视频分类模型作为教师模型进行蒸馏,以进一步提升模型精度。实验中,将以ResNet152为backbone的CSN模型作为第二阶段蒸馏的教师模型,在8 frame的训练策略下,精度可以提升约1.3个点。最终PP-TSN精度达到75.06,超过同等backbone下的SlowFast模型。
2.2.2 PP-TSN 实现
PP-TSN整体网络结构实现如下,输入为backbone和head:
In [24]
# frameworkclass Recognizer2D(nn.Layer): """2D recognizer model framework.""" def __init__(self, backbone=None, head=None): super().__init__() if backbone != None: self.backbone = backbone self.backbone.init_weights() else: self.backbone = None if head != None: self.head = head self.head.init_weights() else: self.head = None # imgs should be a Tensor def forward_net(self, imgs): # NOTE: As the num_segs is an attribute of dataset phase, and didn't pass to build_head phase, should obtain it from imgs(paddle.Tensor) now, then call self.head method. num_segs = imgs.shape[1] # imgs.shape=[N,T,C,H,W], for most commonly case imgs = paddle.reshape_(imgs, [-1] + list(imgs.shape[2:])) if self.backbone != None: feature = self.backbone(imgs) else: feature = imgs if self.head != None: cls_score = self.head(feature, num_segs) else: cls_score = None return cls_score def forward(self, data_batch, mode='infer'): """ 1. Define how the model is going to run, from input to output. 2. Console of train, valid, test or infer step 3. Set mode='infer' is used for saving inference model, refer to tools/export_model.py """ if mode == 'train': return self.train_step(data_batch) elif mode == 'valid': return self.val_step(data_batch) elif mode == 'test': return self.test_step(data_batch) elif mode == 'infer': return self.infer_step(data_batch) else: raise NotImplementedError def train_step(self, data_batch): """Define how the model is going to train, from input to output. """ imgs = data_batch[0] labels = data_batch[1:] cls_score = self.forward_net(imgs) loss_metrics = self.head.loss(cls_score, labels) return loss_metrics def val_step(self, data_batch): imgs = data_batch[0] labels = data_batch[1:] cls_score = self.forward_net(imgs) loss_metrics = self.head.loss(cls_score, labels, valid_mode=True) return loss_metrics def test_step(self, data_batch): """Define how the model is going to test, from input to output.""" # NOTE: (shipping) when testing, the net won't call head.loss, we deal with the test processing in /paddlevideo/metrics imgs = data_batch[0] cls_score = self.forward_net(imgs) return cls_score def infer_step(self, data_batch): """Define how the model is going to test, from input to output.""" imgs = data_batch[0] cls_score = self.forward_net(imgs) return cls_scoredef weight_init_(layer, func, weight_name=None, bias_name=None, bias_value=0.0, **kwargs): """ In-place params init function. Usage: .. code-block:: python import paddle import numpy as np data = np.ones([3, 4], dtype='float32') linear = paddle.nn.Linear(4, 4) input = paddle.to_tensor(data) print(linear.weight) linear(input) weight_init_(linear, 'Normal', 'fc_w0', 'fc_b0', std=0.01, mean=0.1) print(linear.weight) """ if hasattr(layer, 'weight') and layer.weight is not None: getattr(init, func)(**kwargs)(layer.weight) if weight_name is not None: # override weight name layer.weight.name = weight_name if hasattr(layer, 'bias') and layer.bias is not None: init.Constant(bias_value)(layer.bias) if bias_name is not None: # override bias name layer.bias.name = bias_namedef get_dist_info(): world_size = dist.get_world_size() rank = dist.get_rank() return rank, world_size
损失函数采用交叉熵损失:
In [25]
class CrossEntropyLoss(nn.Layer): """Cross Entropy Loss.""" def __init__(self, loss_weight=1.0): super().__init__() self.loss_weight = loss_weight def _forward(self, score, labels, **kwargs): """Forward function. Args: score (paddle.Tensor): The class score. labels (paddle.Tensor): The ground truth labels. kwargs: Any keyword argument to be used to calculate CrossEntropy loss. Returns: loss (paddle.Tensor): The returned CrossEntropy loss. """ loss = F.cross_entropy(score, labels, **kwargs) return loss def forward(self, *args, **kwargs): """Defines the computation performed at every call. Args: *args: The positional arguments for the corresponding loss. **kwargs: The keyword arguments for the corresponding loss. Returns: paddle.Tensor: The calculated loss. """ return self._forward(*args, **kwargs) * self.loss_weight
骨干网络实现如下:
In [26]
class ConvBNLayer(nn.Layer): def __init__(self, in_channels, out_channels, kernel_size, stride=1, groups=1, is_tweaks_mode=False, act=None, lr_mult=1.0, name=None): super(ConvBNLayer, self).__init__() self.is_tweaks_mode = is_tweaks_mode self._pool2d_avg = AvgPool2D(kernel_size=2, stride=2, padding=0, ceil_mode=True) self._conv = Conv2D(in_channels=in_channels, out_channels=out_channels, kernel_size=kernel_size, stride=stride, padding=(kernel_size - 1) // 2, groups=groups, weight_attr=ParamAttr(name=name + "_weights", learning_rate=lr_mult), bias_attr=False) if name == "conv1": bn_name = "bn_" + name else: bn_name = "bn" + name[3:] self._batch_norm = BatchNorm( out_channels, act=act, param_attr=ParamAttr(name=bn_name + '_scale', learning_rate=lr_mult, regularizer=L2Decay(0.0)), bias_attr=ParamAttr(bn_name + '_offset', learning_rate=lr_mult, regularizer=L2Decay(0.0)), moving_mean_name=bn_name + '_mean', moving_variance_name=bn_name + '_variance') def forward(self, inputs): if self.is_tweaks_mode: inputs = self._pool2d_avg(inputs) y = self._conv(inputs) y = self._batch_norm(y) return yclass BottleneckBlock(nn.Layer): def __init__(self, in_channels, out_channels, stride, shortcut=True, if_first=False, lr_mult=1.0, name=None): super(BottleneckBlock, self).__init__() self.conv0 = ConvBNLayer(in_channels=in_channels, out_channels=out_channels, kernel_size=1, act='relu', lr_mult=lr_mult, name=name + "_branch2a") self.conv1 = ConvBNLayer(in_channels=out_channels, out_channels=out_channels, kernel_size=3, stride=stride, act='relu', lr_mult=lr_mult, name=name + "_branch2b") self.conv2 = ConvBNLayer(in_channels=out_channels, out_channels=out_channels * 4, kernel_size=1, act=None, lr_mult=lr_mult, name=name + "_branch2c") if not shortcut: self.short = ConvBNLayer(in_channels=in_channels, out_channels=out_channels * 4, kernel_size=1, stride=1, is_tweaks_mode=False if if_first else True, lr_mult=lr_mult, name=name + "_branch1") self.shortcut = shortcut def forward(self, inputs): y = self.conv0(inputs) conv1 = self.conv1(y) conv2 = self.conv2(conv1) if self.shortcut: short = inputs else: short = self.short(inputs) y = paddle.add(x=short, y=conv2) y = F.relu(y) return yclass BasicBlock(nn.Layer): def __init__(self, in_channels, out_channels, stride, shortcut=True, if_first=False, lr_mult=1.0, name=None): super(BasicBlock, self).__init__() self.stride = stride self.conv0 = ConvBNLayer(in_channels=in_channels, out_channels=out_channels, kernel_size=3, stride=stride, act='relu', lr_mult=lr_mult, name=name + "_branch2a") self.conv1 = ConvBNLayer(in_channels=out_channels, out_channels=out_channels, kernel_size=3, act=None, lr_mult=lr_mult, name=name + "_branch2b") if not shortcut: self.short = ConvBNLayer(in_channels=in_channels, out_channels=out_channels, kernel_size=1, stride=1, is_tweaks_mode=False if if_first else True, lr_mult=lr_mult, name=name + "_branch1") self.shortcut = shortcut def forward(self, inputs): y = self.conv0(inputs) conv1 = self.conv1(y) if self.shortcut: short = inputs else: short = self.short(inputs) y = paddle.add(x=short, y=conv1) y = F.relu(y) return yclass ResNetTweaksTSN(nn.Layer): """ResNetTweaksTSN backbone. Args: depth (int): Depth of resnet model. pretrained (str): pretrained model. Default: None. """ def __init__(self, layers=50, pretrained=None, lr_mult_list=[1.0, 1.0, 1.0, 1.0, 1.0]): super(ResNetTweaksTSN, self).__init__() self.pretrained = pretrained self.layers = layers supported_layers = [18, 34, 50, 101, 152, 200] assert layers in supported_layers, "supported layers are {} but input layer is {}".format( supported_layers, layers) self.lr_mult_list = lr_mult_list assert isinstance( self.lr_mult_list, (list, tuple )), "lr_mult_list should be in (list, tuple) but got {}".format( type(self.lr_mult_list)) assert len( self.lr_mult_list ) == 5, "lr_mult_list length should should be 5 but got {}".format( len(self.lr_mult_list)) if layers == 18: depth = [2, 2, 2, 2] elif layers == 34 or layers == 50: depth = [3, 4, 6, 3] elif layers == 101: depth = [3, 4, 23, 3] elif layers == 152: depth = [3, 8, 36, 3] elif layers == 200: depth = [3, 12, 48, 3] num_channels = [64, 256, 512, 1024 ] if layers >= 50 else [64, 64, 128, 256] num_filters = [64, 128, 256, 512] self.conv1_1 = ConvBNLayer(in_channels=3, out_channels=32, kernel_size=3, stride=2, act='relu', lr_mult=self.lr_mult_list[0], name="conv1_1") self.conv1_2 = ConvBNLayer(in_channels=32, out_channels=32, kernel_size=3, stride=1, act='relu', lr_mult=self.lr_mult_list[0], name="conv1_2") self.conv1_3 = ConvBNLayer(in_channels=32, out_channels=64, kernel_size=3, stride=1, act='relu', lr_mult=self.lr_mult_list[0], name="conv1_3") self.pool2d_max = MaxPool2D(kernel_size=3, stride=2, padding=1) self.block_list = [] if layers >= 50: for block in range(len(depth)): shortcut = False for i in range(depth[block]): if layers in [101, 152, 200] and block == 2: if i == 0: conv_name = "res" + str(block + 2) + "a" else: conv_name = "res" + str(block + 2) + "b" + str(i) else: conv_name = "res" + str(block + 2) + chr(97 + i) bottleneck_block = self.add_sublayer( 'bb_%d_%d' % (block, i), BottleneckBlock( in_channels=num_channels[block] if i == 0 else num_filters[block] * 4, out_channels=num_filters[block], stride=2 if i == 0 and block != 0 else 1, shortcut=shortcut, if_first=block == i == 0, lr_mult=self.lr_mult_list[block + 1], name=conv_name)) self.block_list.append(bottleneck_block) shortcut = True else: for block in range(len(depth)): shortcut = False for i in range(depth[block]): conv_name = "res" + str(block + 2) + chr(97 + i) basic_block = self.add_sublayer( 'bb_%d_%d' % (block, i), BasicBlock(in_channels=num_channels[block] if i == 0 else num_filters[block], out_channels=num_filters[block], stride=2 if i == 0 and block != 0 else 1, shortcut=shortcut, if_first=block == i == 0, name=conv_name, lr_mult=self.lr_mult_list[block + 1])) self.block_list.append(basic_block) shortcut = True def init_weights(self): """Initiate the parameters. Note: 1. when indicate pretrained loading path, will load it to initiate backbone. 2. when not indicating pretrained loading path, will follow specific initialization initiate backbone. Always, Conv2D layer will be initiated by KaimingNormal function, and BatchNorm2d will be initiated by Constant function. Please refer to https://www.paddlepaddle.org.cn/documentation/docs/en/develop/api/paddle/nn/initializer/kaiming/KaimingNormal_en.html """ # XXX: check bias!!! check pretrained!!! if isinstance(self.pretrained, str) and self.pretrained.strip() != "": load_ckpt(self, self.pretrained) elif self.pretrained is None or self.pretrained.strip() == "": for layer in self.sublayers(): if isinstance(layer, nn.Conv2D): # XXX: no bias weight_init_(layer, 'KaimingNormal') elif isinstance(layer, nn.BatchNorm2D): weight_init_(layer, 'Constant', value=1) def forward(self, inputs): y = self.conv1_1(inputs) y = self.conv1_2(y) y = self.conv1_3(y) y = self.pool2d_max(y) for block in self.block_list: y = block(y) return y
Head实现如下:
In [27]
# headclass ppTSNHead(nn.Layer): """ppTSN Head. Args: num_classes (int): The number of classes to be classified. in_channels (int): The number of channles in input feature. loss_cfg (dict): Config for building config. Default: dict(name='CrossEntropyLoss'). drop_ratio(float): drop ratio. Default: 0.4. std(float): Std(Scale) value in normal initilizar. Default: 0.01. data_format(str): data format of input tensor in ['NCHW', 'NHWC']. Default: 'NCHW'. fclr5(bool): Whether to increase the learning rate of the fully connected layer. Default: True kwargs (dict, optional): Any keyword argument to initialize. """ def __init__(self, num_classes, in_channels, loss_func='CrossEntropyLoss', drop_ratio=0.4, std=0.01, data_format="NCHW", fclr5=True, ls_eps=0.1, **kwargs): super().__init__() self.num_classes = num_classes self.in_channels = in_channels if loss_func=='CrossEntropyLoss': self.loss_func = CrossEntropyLoss() #self.multi_class = multi_class NOTE(shipping): not supported now self.ls_eps = ls_eps self.drop_ratio = drop_ratio self.std = std # NOTE: global pool performance self.avgpool2d = AdaptiveAvgPool2D((1, 1), data_format=data_format) if self.drop_ratio != 0: self.dropout = Dropout(p=self.drop_ratio) else: self.dropout = None self.fc = Linear( self.in_channels, self.num_classes, weight_attr=ParamAttr(learning_rate=5.0 if fclr5 else 1.0, regularizer=L2Decay(1e-4)), bias_attr=ParamAttr(learning_rate=10.0 if fclr5 else 1.0, regularizer=L2Decay(0.0))) def init_weights(self): """Initiate the FC layer parameters""" weight_init_(self.fc, 'Normal', 'fc_0.w_0', 'fc_0.b_0', mean=0., std=self.std) def forward(self, x, seg_num): """Define how the head is going to run. Args: x (paddle.Tensor): The input data. num_segs (int): Number of segments. Returns: score: (paddle.Tensor) The classification scores for input samples. """ # XXX: check dropout location! # [N * num_segs, in_channels, 7, 7] x = self.avgpool2d(x) # [N * num_segs, in_channels, 1, 1] x = paddle.reshape(x, [-1, seg_num, x.shape[1]]) # [N, seg_num, in_channels] x = paddle.mean(x, axis=1) # [N, in_channels] if self.dropout is not None: x = self.dropout(x) # [N, in_channels] x = paddle.reshape(x, shape=[-1, self.in_channels]) # [N, in_channels] score = self.fc(x) # [N, num_class] # x = F.softmax(x) # NOTE remove return score def loss(self, scores, labels, valid_mode=False, **kwargs): """Calculate the loss accroding to the model output ```scores```, and the target ```labels```. Args: scores (paddle.Tensor): The output of the model. labels (paddle.Tensor): The target output of the model. Returns: losses (dict): A dict containing field 'loss'(mandatory) and 'top1_acc', 'top5_acc'(optional). """ if len(labels) == 1: #commonly case labels = labels[0] losses = dict() if self.ls_eps != 0. and not valid_mode: # label_smooth loss = self.label_smooth_loss(scores, labels, **kwargs) else: loss = self.loss_func(scores, labels, **kwargs) top1, top5 = self.get_acc(scores, labels, valid_mode) losses['top1'] = top1 losses['top5'] = top5 losses['loss'] = loss return losses elif len(labels) == 3: # mix_up labels_a, labels_b, lam = labels lam = lam[0] # get lam value losses = dict() if self.ls_eps != 0: loss_a = self.label_smooth_loss(scores, labels_a, **kwargs) loss_b = self.label_smooth_loss(scores, labels_b, **kwargs) else: loss_a = self.loss_func(scores, labels_a, **kwargs) loss_b = self.loss_func(scores, labels_b, **kwargs) loss = lam * loss_a + (1 - lam) * loss_b top1a, top5a = self.get_acc(scores, labels_a, valid_mode) top1b, top5b = self.get_acc(scores, labels_b, valid_mode) top1 = lam * top1a + (1 - lam) * top1b top5 = lam * top5a + (1 - lam) * top5b losses['top1'] = top1 losses['top5'] = top5 losses['loss'] = loss return losses else: raise NotImplemented def label_smooth_loss(self, scores, labels, **kwargs): labels = F.one_hot(labels, self.num_classes) labels = F.label_smooth(labels, epsilon=self.ls_eps) labels = paddle.squeeze(labels, axis=1) loss = self.loss_func(scores, labels, soft_label=True, **kwargs) return loss def get_acc(self, scores, labels, valid_mode): top1 = paddle.metric.accuracy(input=scores, label=labels, k=1) top5 = paddle.metric.accuracy(input=scores, label=labels, k=5) _, world_size = get_dist_info() #NOTE(shipping): deal with multi cards validate if world_size > 1 and valid_mode: #reduce sum when valid top1 = paddle.distributed.all_reduce( top1, op=paddle.distributed.ReduceOp.SUM) / world_size top5 = paddle.distributed.all_reduce( top5, op=paddle.distributed.ReduceOp.SUM) / world_size return top1, top5
2.3 训练配置
In [28]
logger_initialized = []def setup_logger(output=None, name="paddlevideo", level="INFO"): """ Initialize the paddlevideo logger and set its verbosity level to "INFO". Args: output (str): a file name or a directory to save log. If None, will not save log file. If ends with ".txt" or ".log", assumed to be a file name. Otherwise, logs will be saved to `output/log.txt`. name (str): the root module name of this logger Returns: logging.Logger: a logger """ def time_zone(sec, fmt): real_time = datetime.datetime.now() return real_time.timetuple() logging.Formatter.converter = time_zone logger = logging.getLogger(name) if level == "INFO": logger.setLevel(logging.INFO) elif level=="DEBUG": logger.setLevel(logging.DEBUG) logger.propagate = False if level == "DEBUG": plain_formatter = logging.Formatter( "[%(asctime)s] %(name)s %(levelname)s: %(message)s", datefmt="%m/%d %H:%M:%S") else: plain_formatter = logging.Formatter( "[%(asctime)s] %(message)s", datefmt="%m/%d %H:%M:%S") # stdout logging: master only local_rank = ParallelEnv().local_rank if local_rank == 0: ch = logging.StreamHandler(stream=sys.stdout) ch.setLevel(logging.DEBUG) formatter = plain_formatter ch.setFormatter(formatter) logger.addHandler(ch) # file logging: all workers if output is not None: if output.endswith(".txt") or output.endswith(".log"): filename = output else: filename = os.path.join(output, ".log.txt") if local_rank > 0: filename = filename + ".rank{}".format(local_rank) # PathManager.mkdirs(os.path.dirname(filename)) os.makedirs(os.path.dirname(filename), exist_ok=True) # fh = logging.StreamHandler(_cached_log_stream(filename) fh = logging.FileHandler(filename, mode='a') fh.setLevel(logging.DEBUG) fh.setFormatter(plain_formatter) logger.addHandler(fh) logger_initialized.append(name) return loggerlogger = setup_logger("./", name="paddlevideo", level="INFO")def load_ckpt(model, weight_path): """ """ # model.set_state_dict(state_dict) if not osp.isfile(weight_path): raise IOError(f'{weight_path} is not a checkpoint file') # state_dicts = load(weight_path) state_dicts = paddle.load(weight_path) tmp = {} total_len = len(model.state_dict()) with tqdm(total=total_len, position=1, bar_format='{desc}', desc="Loading weights") as desc: for item in tqdm(model.state_dict(), total=total_len, position=0): name = item desc.set_description('Loading %s' % name) tmp[name] = state_dicts[name] time.sleep(0.01) ret_str = "loading {:3d}/{:<3d}]".format(epoch_id, total_epoch) step_str = "{:s} step:{:<4d}".format(mode, batch_id) print("{:s} {:s} {:s}s {}".format( coloring(epoch_str, "HEADER") if batch_id == 0 else epoch_str, coloring(step_str, "PURPLE"), coloring(metric_str, 'OKGREEN'), ips))def log_epoch(metric_list, epoch, mode, ips): metric_avg = ' '.join([str(m.mean) for m in metric_list.values()] + [metric_list['batch_time'].total]) end_epoch_str = "END epoch:{:<3d}".format(epoch) print("{:s} {:s} {:s}s {}".format(coloring(end_epoch_str, "RED"), coloring(mode, "PURPLE"), coloring(metric_avg, "OKGREEN"), ips))class AverageMeter(object): """ Computes and stores the average and current value """ def __init__(self, name='', fmt='f', need_avg=True): self.name = name self.fmt = fmt self.need_avg = need_avg self.reset() def reset(self): """ reset """ self.val = 0 self.avg = 0 self.sum = 0 self.count = 0 def update(self, val, n=1): """ update """ if isinstance(val, paddle.Tensor): val = val.numpy()[0] self.val = val self.sum += val * n self.count += n self.avg = self.sum / self.count @property def total(self): return '{self.name}_sum: {self.sum:{self.fmt}}'.format(self=self) @property def total_minute(self): return '{self.name}_sum: {s:{self.fmt}} min'.format(s=self.sum / 60, self=self) @property def mean(self): return '{self.name}_avg: {self.avg:{self.fmt}}'.format( self=self) if self.need_avg else '' @property def value(self): return '{self.name}: {self.val:{self.fmt}}'.format(self=self)framework = 'Recognizer2D'pretrained="/home/aistudio/work/pretrained_model/ResNet50_vd_ssld_v2_pretrained.pdparams" #Optional, pretrained model path.layers = 50 #Optional, the depth of backbone architecture.num_classes = 101 #Optional, the number of classes to be classified.in_channels = 2048 #input channel of the extracted feature.drop_ratio = 0.4 #the ratio of dropoutstd = 0.01 #std value in params initializationls_eps = 0.1batch_size = 32 #Mandatory, bacth sizevalid_batch_size = 32test_batch_size = 1num_workers = 0 #Mandatory, XXX the number of subprocess on each GPU.train_file_path = '/home/aistudio/work/data/ucf101/ucf101_train_split_1_rawframes.txt' # 训练数据valid_file_path = '/home/aistudio/work/data/ucf101/ucf101_val_split_1_rawframes.txt' # 验证数据test_file_path = '/home/aistudio/work/data/ucf101/ucf101_val_split_1_rawframes.txt' # 验证数据suffix = 'img_{:05}.jpg'train_num_seg = 3valid_num_seg = 3test_num_seg = 25seg_len = 1select_left = Truemodel_name = "ppTSN"log_interval = 20 #Optional, the interal of logger, default:10save_interval = 10epochs = 80 #Mandatory, total epochlog_level = "INFO" #Optional, the logger level. default: "INFO"momentum=0.9weight_decay = 0.0001return_list = True
2.4 模型训练
每个 epoch 都需要在训练集与测试集上运行,并打印出训练集上的 loss 和模型在训练和验证集上的准确率。
paddle.io.DataLoader中collate_fn参数是一个函数,通过合并样本的方式生成min-batch数据。默认是None,堆叠每个样本的轴0的值。
In [29]
def mix_collate_fn(batch): mix_up = Mixup(alpha=0.2) batch = mix_up(batch) slots = [] for items in batch: for i, item in enumerate(items): if len(slots) best: best = record_list[top_flag].avg best_flag = True return best, best_flag # 5. Validation if validate or epoch == epochs - 1: with paddle.no_grad(): best, save_best_flag = evaluate(best) # save best if save_best_flag: paddle.save(optimizer.state_dict(), osp.join(output_dir, model_name + "_best.pdopt")) paddle.save(model.state_dict(), osp.join(output_dir, model_name + "_best.pdparams")) if model_name == "AttentionLstm": print(f"Already save the best model (hit_at_one){best}") else: print(f"Already save the best model (top1 acc){int(best * 10000) / 10000}") # 6. Save model and optimizer if epoch % save_interval == 0 or epoch == epochs - 1: paddle.save(optimizer.state_dict(), osp.join(output_dir, model_name + f"_epoch_{epoch + 1:05d}.pdopt")) paddle.save(model.state_dict(), osp.join(output_dir, model_name + f"_epoch_{epoch + 1:05d}.pdparams")) print(f'training {model_name} finished')#train_model(True)
2.5 模型评估
评估类如下:
In [30]
class CenterCropMetric(object): def __init__(self, data_size, batch_size, log_interval=1): """prepare for metrics """ self.data_size = data_size self.batch_size = batch_size _, self.world_size = get_dist_info() self.log_interval = log_interval self.top1 = [] self.top5 = [] def update(self, batch_id, data, outputs): """update metrics during each iter """ labels = data[1] top1 = paddle.metric.accuracy(input=outputs, label=labels, k=1) top5 = paddle.metric.accuracy(input=outputs, label=labels, k=5) #NOTE(shipping): deal with multi cards validate if self.world_size > 1: top1 = paddle.distributed.all_reduce( top1, op=paddle.distributed.ReduceOp.SUM) / self.world_size top5 = paddle.distributed.all_reduce( top5, op=paddle.distributed.ReduceOp.SUM) / self.world_size self.top1.append(top1.numpy()) self.top5.append(top5.numpy()) # preds ensemble if batch_id % self.log_interval == 0: logger.info("[TEST] Processing batch {}/{} ...".format( batch_id, self.data_size // (self.batch_size * self.world_size))) def accumulate(self): """accumulate metrics when finished all iters. """ logger.info('[TEST] finished, avg_acc1= {}, avg_acc5= {} '.format( np.mean(np.array(self.top1)), np.mean(np.array(self.top5))))
为了能够有一个比较好的评估效果,这里我们选用训练好的模型,模型存放在 /home/aistudio/output/PP-TSN 目录下。具体评估代码如下:
In [31]
def test_model(weights): # 1. Construct model tsn = ResNetTweaksTSN(layers=layers, pretrained=None) head = ppTSNHead(num_classes=num_classes, in_channels=in_channels,drop_ratio=drop_ratio,std=std,ls_eps=ls_eps) model = Recognizer2D(backbone=tsn , head=head) # 2. Construct dataset and dataloader. test_pipeline = Compose(mode='Valid') test_dataset = FrameDataset(file_path=valid_file_path, pipeline=test_pipeline, suffix=suffix) test_sampler = paddle.io.DistributedBatchSampler( test_dataset, batch_size=test_batch_size, ) test_loader = paddle.io.DataLoader( test_dataset, batch_sampler=test_sampler, places=paddle.set_device('gpu'), num_workers=num_workers, collate_fn = mix_collate_fn ) model.eval() state_dicts = paddle.load(weights) model.set_state_dict(state_dicts) # add params to metrics data_size = len(test_dataset) metric = CenterCropMetric(data_size=data_size, batch_size=batch_size) for batch_id, data in enumerate(test_loader): outputs = model.test_step(data) metric.update(batch_id, data, outputs) metric.accumulate()weights = "/home/aistudio/work/data/output/ppTSN/ppTSN_best.pdparams"##test_model(weights)
2.6 模型推理
这部分将随机抽取 UCF101 中的若干条数据集,演示模型预测的结果。
In [32]
index_class = [x.strip().split() for x in open('/home/aistudio/work/data/ucf101/annotations/classInd.txt')]drop_last = True@paddle.no_grad()def inference(): model_file = '/home/aistudio/work/data/output/ppTSN/ppTSN_best.pdparams' # 1. Construct dataset and dataloader. test_pipeline = Compose(mode='Test') test_dataset = FrameDataset(file_path=valid_file_path, pipeline=test_pipeline, suffix=suffix) test_sampler = paddle.io.DistributedBatchSampler( test_dataset, batch_size=1, shuffle=True, drop_last=drop_last ) test_loader = paddle.io.DataLoader( test_dataset, batch_sampler=test_sampler, places=paddle.set_device('gpu'), num_workers=num_workers, return_list=return_list ) # 1. Construct model. # 创建模型 pptsn = ResNetTweaksTSN(layers=layers, pretrained=None) head = ppTSNHead(num_classes=num_classes, in_channels=in_channels,drop_ratio=drop_ratio,std=std,ls_eps=ls_eps) model = Recognizer2D(backbone=pptsn , head=head) # 将模型设置为评估模式 model.eval() # 加载权重 state_dicts = paddle.load(model_file) model.set_state_dict(state_dicts) for batch_id, data in enumerate(test_loader): _, labels = data # 预测 outputs = model.test_step(data) # 经过 softmax 输出置信度分数 scores = F.softmax(outputs) # 从预测结果中取出置信度分数最高的 class_id = paddle.argmax(scores, axis=-1) pred = class_id.numpy()[0] label = labels.numpy()[0][0] print('真实类别:{}, 模型预测类别:{}'.format(index_class[pred][1], index_class[label][1])) if batch_id > 5: break# 启动推理inference()
真实类别:BodyWeightSquats, 模型预测类别:BodyWeightSquats真实类别:BlowingCandles, 模型预测类别:BlowingCandles真实类别:Surfing, 模型预测类别:Rafting真实类别:TableTennisShot, 模型预测类别:TableTennisShot真实类别:CleanAndJerk, 模型预测类别:CleanAndJerk真实类别:StillRings, 模型预测类别:StillRings真实类别:Fencing, 模型预测类别:Fencing
以上就是【官方】Paddle2.1实现视频理解优化模型 — PP-TSN的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/68680.html
 微信扫一扫
 支付宝扫一扫