Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
语句生成之胡编乱造哲理和爱情生成器_创想鸟

语句生成之胡编乱造哲理和爱情生成器

这是一个基于GRU的哲理与爱情文本生成器。用wordstest.txt作数据集,通过字映射构建字表,模型含嵌入层、双向GRU层和全连接层。训练时以固定长度文本为输入预测下一字,迭代优化参数。使用时输入开头文字,模型生成指定长度文本,生字会提示未学会。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
语句生成之胡编乱造哲理和爱情生成器 - 创想鸟

胡编乱造哲理和爱情生成器

高人打造计划

因为数据集偏向哲理和爱情

效果展示:

输入:

我对你的爱

输出:

我对你的爱恋中,我愿为此生,爱爱可多少善果才能与他漫步人生路?朋友如海水般,承载你无数的泪花;欢乐时,白浪掀天,波涛声依旧没有能够脱离其中。执子之手,往事既往不咎,执子之手,往事既往不咎,执子之手,我们注定?一昧的消沉,失落,伪装出虚伪的自己,只愿愿以一袭泯念过无数的看着,安慰着,轻抚疼痛的心。

再不会为了一句话,而和人争得面红耳赤;再不会为了一句话,而和此刻绽放。   站在都市的一隅,感受那些渐行渐远,耳际忽而响起<怒放的生命>的旋律,激起我心中一股莫名的渴望。轻轻拉开窗帘,一场春雨,淋湿了虔诚向往的花朵,许许多多的回忆片段如同雨浇开的花香,坐在窗帘的边缘点燃生命的歌喉。

古藤老树昏鸦,断肠人在天涯。韶光荏苒,记不起年少的轻狂,不再想当年的慷慨激昂。一路奔波流浪,一路磕磕绊绊。笑荏苒燃的前世与无奈,尘世中没有哪一空中的征程时,点出事情中痴迷,无奈生命里伏伏起起,你有经的青春很
爱图表 爱图表

AI驱动的智能化图表创作平台

爱图表 305 查看详情 爱图表

操作使用方法

就是从上到下运行全部代码,注释掉倒数第二个代码块,这个为训练的,然后最后一个代码块就是测试代码块,就是玩的。

让你输入开头几个字,然后输出自定义字数的句段。

简单的技术

本项目主要就是用了GRU,然后数据集构造非常简单,就是放在wordstest.txt里面,也可以自己改数据集训练哦。

为了简单,本项目的batch_size为1,没有使用dataset这些。

定义基本工具函数

In [1]

import numpy as np import paddleimport paddle.nn.functional as Fimport timeimport randomfrom collections import CounterRANDOM_SEED = 123paddle.seed(RANDOM_SEED)def elapsed(sec):    if sec < 60:        return str(sec) +"sec"    elif sec< 60*60:        return str(sec/60)+"min"    else :        return str(sec/(60*60)) +"hr"training_file = "wordstest.txt" #定义样本文件def readalltxt(txt_files):    labels = []    for txt_file in txt_files:        target = get_ch_lable(txt_file)        labels.append(target)    return training_filedef get_ch_lable(txt_file):    labels = ""    with open(txt_file,"rb") as f:        # print(f) #        for label in f:            labels = labels + label.decode("utf-8")    return labelsdef get_ch_lable_v(txt_file,word_num_map,txt_label = None):    words_size = len(word_num_map)    to_num = lambda word:word_num_map.get(word,words_size)#如果word没有在训练集出现过,就输出words_size    if txt_file != None:        txt_label = get_ch_lable(txt_file)    labels_vector = list(map(to_num,txt_label))    return labels_vectortraining_data = get_ch_lable(training_file)print("loaded training data...")print("样本长度:",len(training_data))counter  = Counter(training_data)# print(counter)words = sorted(counter)# print(words)words_size = len(words)word_num_map = dict(zip(words,range(words_size))) # 字映射到对应的独热编码print("字表大小",words_size)wordlabel = get_ch_lable_v(training_file,word_num_map)# print(wordlabel)
loaded training data...样本长度: 4240字表大小 1016

模型主体

In [2]

class GRURNN(paddle.nn.Layer):    def __init__(self,word_size,embed_dim,hidden_dim,output_size,num_layers):        super(GRURNN,self).__init__()        self.num_layers = num_layers        self.hidden_dim = hidden_dim        self.embed = paddle.nn.Embedding(word_size,embed_dim)        self.gru = paddle.nn.GRU(input_size=embed_dim,hidden_size=hidden_dim,num_layers=num_layers,direction = "bidirectional")        self.fc = paddle.nn.Linear(hidden_dim*2,output_size)#输出概率    def forward(self,features,hidden):        embedded = self.embed(features.reshape([1,-1]))        output,hidden = self.gru(embedded.reshape([1,1,-1]),hidden)        # output = self.attention(output)        output = self.fc(output.reshape([1,-1]))        return output,hidden    def init_zero_state(self):        init_hidden = paddle.zeros([self.num_layers*2,1,self.hidden_dim])        return init_hidden

训练前的小小准备

In [3]

EMBEDDING_DIM = 10HIDDEN_DIM = 20NUM_LAYERS = 1model = GRURNN(words_size, EMBEDDING_DIM, HIDDEN_DIM, words_size, NUM_LAYERS)optimizer = paddle.optimizer.Adam(learning_rate=0.005,parameters=model.parameters())#定义测试函数def evaluate(model, prime_str, predict_len, temperature=0.8):    hidden = model.init_zero_state()    predicted = ''    #处理输入语义    for p in range(len(prime_str) - 1):        _, hidden = model(prime_str[p], hidden)        predicted +=words[prime_str[p]]    inp = prime_str[-1]    predicted +=words[inp]        for p in range(predict_len):        output, hidden = model(inp, hidden)                #从多项式分布中采样        output_dist = output.reshape([-1]).divide(paddle.to_tensor(temperature)).exp()        inp = paddle.multinomial(output_dist, 1)[0]                predicted += words[inp]    return predicted
W0309 22:03:40.237079  1212 device_context.cc:447] Please NOTE: device: 0, GPU Compute Capability: 7.0, Driver API Version: 10.1, Runtime API Version: 10.1W0309 22:03:40.242807  1212 device_context.cc:465] device: 0, cuDNN Version: 7.6.

正式训练(如果不想训练可以直接注释掉本代码块,然后直接运行全部的代码,最后一个代码块就可以直接玩了)

In [4]

# #定义参数训练模型# training_iters = 20000# display_step = 1000# n_input = 20# step = 0# offset = random.randint(0,n_input+1)# end_offset = n_input + 1# while step  (len(training_data)-end_offset):#         offset = random.randint(0, n_input+1)   #     inwords =wordlabel[offset:offset+n_input]#     inwords = np.reshape(np.array(inwords), [n_input, -1,  1])#     out_onehot = wordlabel[offset+1:offset+n_input+1]#     hidden = model.init_zero_state()#     # print(hidden)#     optimizer.clear_grad()    #     loss = 0.#     inputs, targets = paddle.to_tensor(inwords), paddle.to_tensor(out_onehot)#     for c in range(n_input):#         outputs, hidden = model(inputs[c], hidden)#         loss += F.cross_entropy(outputs, targets[c].reshape([1]))#     loss /= n_input#求每个字的平均loss#     loss.backward()#     optimizer.step()#     #输出日志#     with paddle.set_grad_enabled(False):#         if (step+1) % display_step == 0:#             print(f'Time elapsed: {(time.time() - start_time)/60:.4f} min')#             print(f'step {step+1} | Loss {loss.item():.2f}nn')#             with paddle.no_grad():#                 print(evaluate(model, inputs, 32), 'n')#             print(50*'=')#             paddle.save(model.state_dict(), 'model_state'+str(2)+'.pdparams')#     step += 1#     offset += (n_input+1)#中间隔了一个,作为预测# print("Finished!")

可以直接玩的代码(如果字在txt中没有出现,就会进行提示“该字我还没学会”)

In [ ]

import paddlen_input =20 layer_state_dictm = paddle.load("model_state2.pdparams")model.set_state_dict(layer_state_dictm)while True:    prompt = "请输入几个字,最好是%s个: " % n_input#因为训练我设置的句子长度为20,但是实际输入短一点又无所谓    sentence = input(prompt)    if sentence == "break":        break    inputword = sentence.strip()        try:        inputword = get_ch_lable_v(None,word_num_map,inputword)        keys = np.reshape(np.array(inputword), [ len(inputword),-1, 1])        zi_num = 400        model.eval()        with paddle.no_grad():            sentence =evaluate(model, paddle.to_tensor(keys), zi_num)# zi_num就代表后面继续模型输出字数 总共为n_input + zi_num        print(sentence)    # break    except:        print("该字我还没学会")
请输入几个字,最好是20个:  风的悲伤
风的悲伤着?茫然的心境,遥远的梦幻,飘荡,游离恍若几个世纪,那么漫长。为了那份渴望已久梦中痴缠的美丽,落日的晚霞像是给你披上漂亮的嫁衣,习习微风把你的面纱吹起,凝眸深处你的微笑惹人痴迷,无奈生命里伏伏起起,你的美永远刻在了无法倒转的悱侧惆怅,又有情深意意的悠悠旋律,不时的在你心中回荡。徘徊。萦绕间的人陶醉的温柔。往事都成过往云烟,无须无奈,尘世,无须追究,执子之手,我们注定?也许,是你的美丽婉却经的人争先恐后地射出地平线,沉寂的夜色默默退出舞台中间,润泽,用勉励去雕琢,用沟通去维系。  当我们踏上人生的征程时,可拨不可多问,无须追究,执子之手,我们注定?那些盛开在流淌。而我一场前世的你的娇嘀。是我熏醉。绕完圈,又回到原点。再回去,那片记忆中的怅惘是否已布满历史风尘的青苔?美丽的花。岁月荏苒,什么都可以改变,唯一手抚平处你的笑容岸,我爱泡一杯清茶,一片片盈绿,舞动翩翩,茗香阵阵,享受
请输入几个字,最好是20个:  风的吹
风的吹起,凝眸深处你的微笑惹人痴迷,无奈生命里伏伏起起,你的美永远刻在了最初的单纯,当岁月荒芜了似乎成熟的心田,文字是否仍可以承受很回;石桥上飘荡的魂灵,都舍得了前尘旧梦,断前因后果,忘尽一世浮沉得失,一生爱恨情仇。而我,千年华满天下就人生的方向,从痴痴地心。  有时偏执于一己的看法,旁观者清,当局者迷,朋友善意的提点,点出事情的利弊,道出性格的缺陷,为的是希望大家一起进步。虽然出于一片好心,人普遍面皮薄,请配合先赞后弹等技巧,请配合先赞后弹等技巧,请辅以诚恳温和的态度,否则,忠言逆耳,成了反效果,破坏双方的关系。  每一天的早晨我们还是需要坚强,即使远离你无数日子,我依偎在三生石畔夜。  再不会为了一句话,而和人争得面红耳赤;每心上的青面拼凑起。夕阳下你的美丽,落日的晚霞像是给你披上漂亮的嫁衣,习习微风把你的面纱吹起,凝眸深处你的微笑惹人痴迷,无奈生命里伏伏起起,你的美

以上就是语句生成之胡编乱造哲理和爱情生成器的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/744233.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

mysql高可用集群怎么搭建
上一篇 2025年11月25日 16:50:25
如何在composer.json中为一个包指定多个备用版本约束?
下一篇 2025年11月25日 16:50:29

相关推荐

  • 卢伟冰:功能手机、智能手机之后 手机行业正进入新周期

    9月4日,小米集团总裁卢伟冰表示,继功能机时代与智能机时代之后,全球手机产业正迈入一个全新时代。 卢伟冰今日在社交平台发文提到:“我从2002年进入手机行业,有幸完整见证了功能手机和智能手机两大发展阶段。如今,AI时代已经到来,整个行业正在酝酿深刻变革,步入全新的发展周期。” 回望过去,功能手机时期…

    2026年9月21日
    200
  • 谷歌浏览器官方主站入口 最新Chrome在线登录页面

    谷歌浏览器官方主站入口是https://www.google.com,该页面具备界面简洁、操作流畅、集成化服务入口和个性化推荐等特点,支持多设备访问且无广告干扰。 谷歌浏览器官方主站入口在哪里?这是不少网友都关注的,接下来由PHP小编为大家带来谷歌浏览器最新Chrome在线登录页面相关信息,感兴趣的…

    2026年9月21日
    000
  • win11怎么退回win10系统_win11降级回win10系统操作教程

    可在10天内通过系统恢复功能退回Windows 10,保留文件但卸载新增应用;超期则需用媒体工具或第三方软件重装,后者操作更简便但会清除数据。 如果您最近将系统升级到 Windows 11,但发现使用不习惯或存在兼容性问题,则可以考虑退回至 Windows 10。在特定时间窗口内,Windows 提…

    2026年9月21日
    000
  • Java 正则表达式:查找双引号内所有指定字符串的出现次数

    本文旨在解决在 Java 中使用正则表达式查找双引号内特定字符串(例如 “variant”)的所有出现次数的问题。我们将提供一个完整的解决方案,包括正则表达式的构建、代码示例以及详细的解释,帮助开发者准确高效地完成此类任务。 在 Java 中,使用正则表达式查找字符串中特定模…

    2026年9月21日
    000
  • MySQL 大型历史数据表结构设计与优化指南

    本文旨在为处理大量客户历史交易数据的MySQL数据库设计提供专业指导。我们将探讨如何构建高效、可扩展的表结构,重点关注主键设计、数据分区、实时数据摄入以及性能优化策略,以确保系统能够稳定支持百万级乃至亿级数据量的查询需求。 MySQL大型历史数据表结构设计与优化 在处理大量历史数据,特别是涉及到多用…

    2026年9月21日
    000
  • MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录

    MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录

    处理mysql重复数据的核心步骤是识别并清理,可使用group by或窗口函数定位重复项,再通过分批删除或倒腾法安全清理;sublime text可用于高效生成和编辑sql语句。1. 识别重复数据常用group by+having或row_number()窗口函数;2. 清理策略包括分批删除、使用临…

    2026年9月21日 用户投稿
    100
  • 如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    PyTorch大模型训练需综合运用分布式训练、内存优化与高效计算策略。首先采用DistributedDataParallel实现多GPU并行,配合DistributedSampler确保数据均衡;通过混合精度训练、梯度累积和激活检查点缓解显存压力;使用torch.compile优化模型计算效率;选择…

    2026年9月21日 用户投稿
    100
  • vim 学习笔记(一)—— vim模式与创建、编辑文件

    vim 学习笔记(一)—— vim模式与创建、编辑文件vim 学习笔记(一)—— vim模式与创建、编辑文件vim 学习笔记(一)—— vim模式与创建、编辑文件vim 学习笔记(一)—— vim模式与创建、编辑文件

    vim 是基于linux开发的一款强大文本编辑器,源自vi并进行了扩展,具有跨平台和广泛工具支持的特性。据说,vim的高手能够以思想的速度在键盘上操作文本,因此我决定加入学习的行列。学习资料是b站上的生肉教程【公开课】完美的vim课程【生肉】,该教程侧重于讲解vim的思想和精髓,而非具体命令的详细介…

    2026年9月21日 用户投稿
    100
  • QQ好友消息不提示怎么办 QQ消息通知设置与恢复方法

    手机QQ收不到消息提示通常因通知权限关闭或设置问题,需检查QQ内【新消息通知】开关是否开启;2. 查看手机系统设置中QQ的通知权限,确保允许显示通知并开启声音、震动等提醒;3. 使用QQ内置的【消息通知修复】工具自动修复异常;4. 关闭省电模式或将QQ加入电池优化白名单,确保后台正常运行。 手机QQ…

    2026年9月21日
    000
  • win10打开图片提示“没有注册类”怎么办_win10图片打开注册类错误解决方案

    首先重置照片应用并修复系统文件,再通过PowerShell重新注册应用包,最后调整默认应用关联以解决“没有注册类”错误。 如果您尝试在Windows 10中打开图片文件,但系统弹出“没有注册类”的错误提示,则可能是由于默认图片查看应用的注册信息丢失或损坏。以下是解决此问题的步骤: 本文运行环境:De…

    2026年9月21日
    200
  • 一部手机+蝴蝶号账号,开启你的直播副业之路

    一部手机+蝴蝶号账号,开启你的直播副业之路一部手机+蝴蝶号账号,开启你的直播副业之路一部手机+蝴蝶号账号,开启你的直播副业之路一部手机+蝴蝶号账号,开启你的直播副业之路

    开启直播副业确实可行,但需系统规划与长期坚持。1.选择舒适且有热情的内容领域,如技能教学、生活经验或兴趣分享,确保可持续输出;2.利用智能手机基础设备,搭配支架、补光灯等低成本工具提升画面稳定与光线效果;3.注册直播平台账号后,熟悉后台功能以优化直播体验;4.初期通过社交媒体预告宣传引流,并以高质量…

    2026年9月21日 用户投稿
    000
  • 怎么全选VSCode多个光标_VSCode多光标操作与批量选择文本教程

    VSCode中高效创建多光标的方法包括:Alt+Click手动添加光标,适用于不规则位置;Ctrl+Alt+方向键垂直添加光标,适合连续多行操作;Ctrl+D逐个选择匹配项,精准控制选择范围;Ctrl+Shift+L一次性选择所有匹配项,实现全局批量修改。结合查找替换和列选择模式可进一步提升编辑效率…

    2026年9月21日
    000
  • MySQL自动化性能测试方案_MySQL持续监控调优数据库效率

    MySQL自动化性能测试方案_MySQL持续监控调优数据库效率MySQL自动化性能测试方案_MySQL持续监控调优数据库效率MySQL自动化性能测试方案_MySQL持续监控调优数据库效率MySQL自动化性能测试方案_MySQL持续监控调优数据库效率

    mysql自动化性能测试和持续监控的核心在于构建闭环反馈系统,包含模拟真实负载、全面数据采集、自动化执行与分析、数据驱动的持续调优四大环节。①测试环境需与生产一致并隔离,使用docker、虚拟机或云沙盒,解决数据同步与脱敏问题;②负载生成工具如sysbench、jmeter、locust或自定义脚本…

    2026年9月21日 用户投稿
    200
  • UC浏览器如何将网页内容分享到微信_UC浏览器网页分享至微信教程

    打开UC浏览器进入目标网页,点击右上角三点菜单选择“分享”,在应用列表中点击微信好友或朋友圈并发送;2. 若分享功能异常,可长按地址栏复制链接后粘贴至微信聊天窗口发送;3. 如需分享特定图文内容,可通过电源键加音量减键截图,再从相册选择图片发送给微信联系人。 如果您想将UC浏览器中浏览的网页内容快速…

    2026年9月21日
    000
  • mac怎么查看具体的内存型号_mac内存型号查询方法

    首先通过“关于本机”查看内存容量与类型,再进入“系统报告”的内存页面获取各插槽的制造商、型号、部件编号和速度等详细信息,最后使用“活动监视器”分析内存使用情况以判断是否需要升级。 如果您想了解Mac设备中安装的内存具体型号和规格,但系统概览仅显示总容量,则需要通过特定工具深入查看硬件信息。以下是查询…

    2026年9月21日
    000
  • CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法

    CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法

    答案:CyberLink MediaSuite(核心为PowerDirector)通过AI艺术风格转换、智能对象选取、AI天空替换、音频降噪与运动追踪等功能,显著提升视频制作效率与创意表现。结合模板应用、快捷键操作、媒体库管理及代理编辑等实战技巧,可实现快速剪辑与专业输出,适用于Vlog创作、教育视…

    2026年9月21日 用户投稿
    300
  • 罕见!麒麟9020冲上热搜:华为发布会再度公布麒麟型号

    罕见!麒麟9020冲上热搜:华为发布会再度公布麒麟型号罕见!麒麟9020冲上热搜:华为发布会再度公布麒麟型号罕见!麒麟9020冲上热搜:华为发布会再度公布麒麟型号罕见!麒麟9020冲上热搜:华为发布会再度公布麒麟型号

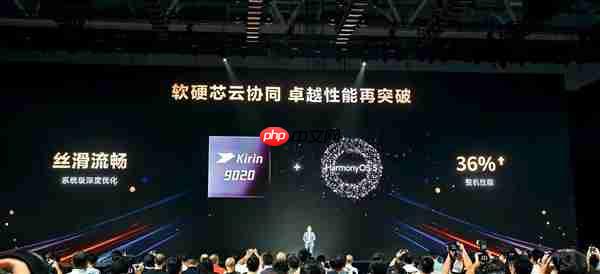
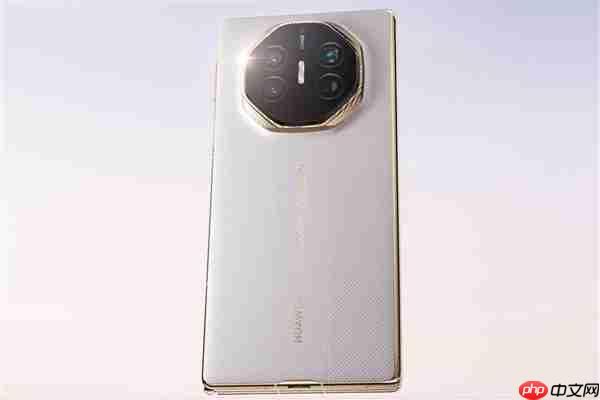
    9月4日消息,今天下午,微博话题“麒麟9020”冲上热搜榜,引发关注。 据了解,华为Mate XTs非凡大师及全场景新品发布会在深圳正式召开,与此前不同,华为此次在发布会上公布了芯片型号。 全新三折叠Mate XTs非凡大师搭载麒麟9020芯片,这款新品已在华为商城上架,相关页面也展示了芯片型号。 …

    2026年9月21日 用户投稿
    200
  • Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]

    Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]

    大家好,很高兴再次与大家见面,我是你们的老朋友全栈君。 作为一个初学者,为了满足自己的求知欲,我按照几位大神写的教程尝试了一遍安装过程,现在来和大家分享一下。 1、Win10安装(如果已经安装,请跳过) 1)制作系统U盘(参考微信公众号“软件安装管家”): https://www.php.cn/li…

    2026年9月21日 用户投稿
    400
  • 百家号视频怎么隐藏?百家号怎么设置仅自己可见

    随着短视频平台的快速发展,其已成为人们获取资讯和休闲娱乐的重要方式。作为国内知名的自媒体平台之一,百家号吸引了大量用户。然而,在享受便捷的同时,隐私安全问题也日益突出。本文将介绍百家号视频隐藏的方法,帮助用户更好地保护个人内容,维护隐私安全。 一、百家号视频隐藏方法 设置隐私权限 在百家号后台,用户…

    2026年9月21日
    200
  • MySQL数据库如何设计适合大数据量的表结构_案例分析?

    MySQL数据库如何设计适合大数据量的表结构_案例分析?MySQL数据库如何设计适合大数据量的表结构_案例分析?MySQL数据库如何设计适合大数据量的表结构_案例分析?MySQL数据库如何设计适合大数据量的表结构_案例分析?

    设计适合大数据量的mysql表结构,核心在于数据类型选对、索引用好、适当拆分。1. 合理选择字段类型,如根据数据范围选用tinyint/smallint代替bigint,固定值字段用enum类型,大文本字段单独拆表;2. 精准建立索引,高频查询字段建联合索引并遵循最左前缀原则,避免低区分度字段建索引…

    2026年9月21日 用户投稿
    100

发表回复

登录后才能评论
关注微信