文生图的基石CLIP模型的发展综述

clip stands for contrastive language-image pre-training, which is a pre-training method or model based on contrastive text-image pairs. it is a multimodal model that relies on contrastive learning. the training data for clip consists of text-image pairs, where an image is paired with its corresponding text description. through contrastive learning, the model aims to understand the relationship between text and image pairs.

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜
文生图的基石CLIP模型的发展综述

Open AI在2021年1月份发布了DALL-E和CLIP,这两个模型都是多模态模型,能够结合图像和文本。DALL-E是一种基于文本生成图像的模型,而CLIP则是利用文本作为监督信号来训练可迁移的视觉模型。

在Stable Diffusion模型中,通过cross attention将CLIP文本编码器提取的文本特征嵌入到扩散模型的UNet中。具体来说,文本特征被用作attention的key和value,而UNet的特征则被用作query。换句话说,CLIP实际上是将文字和图片之间建立连接的关键桥梁,将文本信息与图像信息有机地结合起来。这种结合方式使得模型能够更好地理解和处理不同模态之间的信息,从而在处理复杂任务时取得更好的效果。通过这种方式,Stable Diffusion模型能够更加有效地利用CLIP的文本编码能力,从而提升整体性能并拓展应用领域。

CLIP
文生图的基石CLIP模型的发展综述

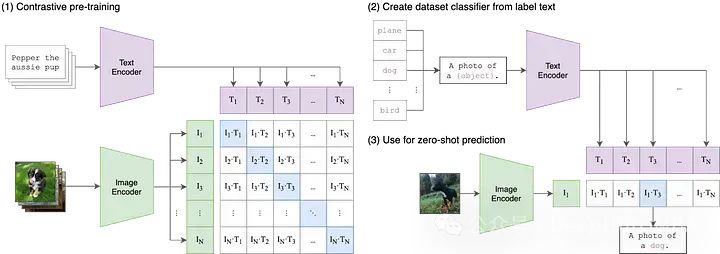
这是OpenAI在21年最早发布的论文,要想理解CLIP,我们需要将缩略词解构为三个组成部分:(1)Contrastive ,(2)Language-Image,(3)Pre-training。

我们先从Language-Image开始。

在传统机器学习模型中,通常只能接受单一模态的输入数据,比如文本、图像、表格数据或音频。如果需要使用不同模态的数据来进行预测,就必须训练多个不同的模型。而在CLIP中,“Language-Image”表示该模型可以同时接受文本(语言)和图像两种类型的输入数据。这种设计使得CLIP能够更灵活地处理不同模态的信息,从而提高了其预测能力和应用范围。

CLIP通过使用两个不同的编码器处理文本和图像输入,分别是文本编码器和图像编码器。这两个编码器将输入数据映射到较低维度的潜在空间中,为每个输入生成相应的嵌入向量。一个重要的细节是,文本和图像编码器将数据嵌入到相同的空间中,即原始的CLIP空间是一个512维向量空间。这种设计使得文本和图像之间可以进行直接的比较和匹配,无需额外的转换或处理。这样一来,CLIP可以在同一个向量空间中表示文本描述和图像内容,从而实现了跨模态的语义对齐和检索功能。这种共享的嵌入空间的设计使得CLIP具有更好的泛化能力和适应性,使其能够在各种任务和数据集上表现出色。

Contrastive

虽然将文本和图像数据嵌入到同一向量空间可能是一个有用的起点,但仅仅做到这一点并不能确保模型能够有效地比较文本和图像的表示。举例来说,建立文本中“狗”或“一张狗的照片”的嵌入与狗图像的嵌入之间的合理且可解释的关系是很重要的。然而,我们需要一种方法来弥合这两种模式之间的差距。

在多模态机器学习中,有各种各样的技术来对齐两个模态,但目前最流行的方法是对比。对比技术从两种模式中获取成对的输入:比如一张图像和它的标题并训练模型的两个编码器尽可能接近地表示这些输入的数据对。与此同时,该模型被激励去接受不配对的输入(如狗的图像和“汽车的照片”的文本),并尽可能远地表示它们。CLIP并不是第一个图像和文本的对比学习技术,但它的简单性和有效性使其成为多模式应用的支柱。

Pre-training

虽然CLIP本身对于诸如零样本分类、语义搜索和无监督数据探索等应用程序很有用,但CLIP也被用作大量多模式应用程序的构建块,从Stable Diffusion和DALL-E到StyleCLIP和OWL-ViT。对于大多数这些下游应用程序,初始CLIP模型被视为“预训练”的起点,并且整个模型针对其新用例进行微调。

虽然OpenAI从未明确指定或共享用于训练原始CLIP模型的数据,但CLIP论文提到该模型是在从互联网收集的4亿对图像-文本上进行训练的。

https://www.php.cn/link/7c1bbdaebec5e20e91db1fe61221228f

ALIGN: Scaling Up Visual and Vision-Language Representation Learning With Noisy Text Supervision
文生图的基石CLIP模型的发展综述

使用CLIP, OpenAI使用了4亿对图像-文本,因为没有提供细节,所以我们不可能确切地知道如何构建数据集。但是在描述新的数据集时,他们参考了谷歌的Google’s Conceptual Captions 作为灵感——一个相对较小的数据集(330万图像描述对,这个数据集使用了昂贵的过滤和后处理技术,虽然这些技术很强大,但不是特别可扩展)。

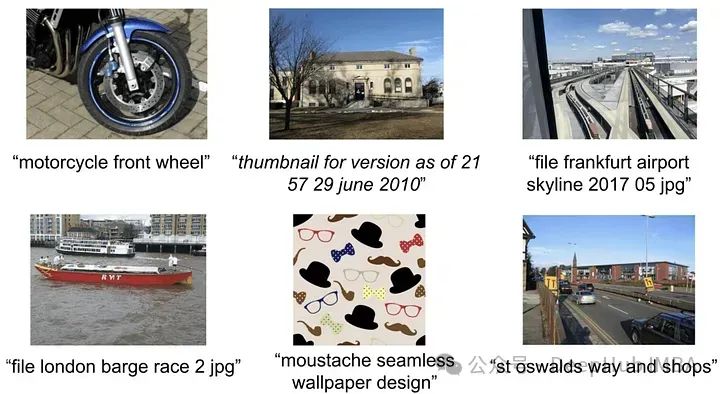
所以高质量的数据集就成为了研究的方向,在CLIP之后不久,ALIGN通过规模过滤来解决这个问题。ALIGN不依赖于小的、精心标注的、精心策划的图像字幕数据集,而是利用了18亿对图像和替代文本。

虽然这些替代文本描述平均而言比标题噪音大得多,但数据集的绝对规模足以弥补这一点。作者使用基本的过滤来去除重复的,有1000多个相关的替代文本的图像,以及没有信息的替代文本(要么太常见,要么包含罕见的标记)。通过这些简单的步骤,ALIGN在各种零样本和微调任务上达到或超过了当时最先进的水平。

https://arxiv.org/abs/2102.05918

K-LITE: Learning Transferable Visual Models with External Knowledge
文生图的基石CLIP模型的发展综述

与ALIGN一样,K-LITE也在解决用于对比预训练的高质量图像-文本对数量有限的问题。
DALL·E 2 DALL·E 2

OpenAI基于GPT-3模型开发的AI绘图生成工具,可以根据自然语言的描述创建逼真的图像和艺术。

DALL·E 2 44 查看详情 DALL·E 2

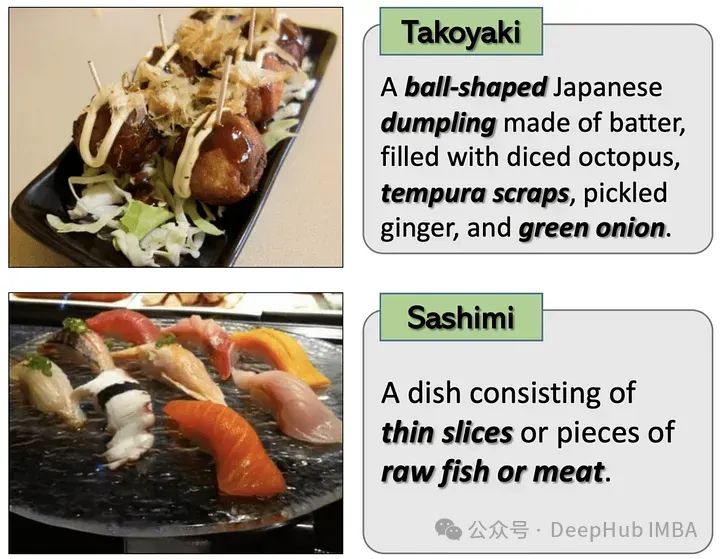
K-LITE专注于解释概念,即将定义或描述作为上下文以及未知概念可以帮助发展广义理解。一个通俗的解释就是人们第一次介绍专业术语和不常用词汇时,他们通常会简单地定义它们!或者使用一个大家都知道的事物作为类比。

为了实现这种方法,微软和加州大学伯克利分校的研究人员使用WordNet和维基词典来增强图像-文本对中的文本。对于一些孤立的概念,例如ImageNet中的类标签,概念本身被增强,而对于标题(例如来自GCC),最不常见的名词短语被增强。通过这些额外的结构化知识,对比预训练模型在迁移学习任务上表现出实质性的改进。

https://arxiv.org/abs/2204.09222

OpenCLIP: Reproducible scaling laws for contrastive language-image learning

文生图的基石CLIP模型的发展综述

到2022年底,transformer 模型已经在文本和视觉领域建立起来。在这两个领域的开创性经验工作也清楚地表明,transformer 模型在单峰任务上的性能可以通过简单的缩放定律来很好地描述。也就是说随着训练数据量、训练时间或模型大小的增加,人们可以相当准确地预测模型的性能。

OpenCLIP通过使用迄今为止发布的最大的开源图像-文本对数据集(5B)将上面的理论扩展到多模式场景,系统地研究了训练数据对模型在零样本和微调任务中的性能的影响。与单模态情况一样,该研究揭示了模型在多模态任务上的性能在计算、所见样本和模型参数数量方面按幂律缩放。

比幂律的存在更有趣的是幂律缩放和预训练数据之间的关系。保留OpenAI的CLIP模型架构和训练方法,OpenCLIP模型在样本图像检索任务上表现出更强的缩放能力。对于ImageNet上的零样本图像分类,OpenAI的模型(在其专有数据集上训练)表现出更强的缩放能力。这些发现突出了数据收集和过滤程序对下游性能的重要性。

https://arxiv.org/abs/2212.07143

但是在OpenCLIP发布不久,LAION数据集因包含非法图像已从互联网上被下架了。

MetaCLIP: Demystifying CLIP Data
文生图的基石CLIP模型的发展综述

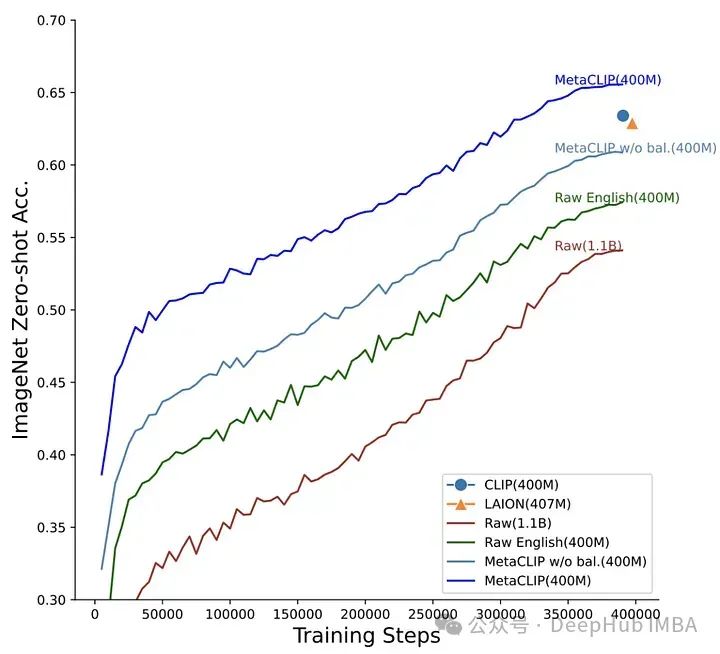
OpenCLIP试图理解下游任务的性能如何随数据量、计算量和模型参数数量的变化而变化,而MetaCLIP关注的是如何选择数据。正如作者所说,“我们认为CLIP成功的主要因素是它的数据,而不是模型架构或预训练目标。”

为了验证这一假设,作者固定了模型架构和训练步骤并进行了实验。MetaCLIP团队测试了与子字符串匹配、过滤和平衡数据分布相关的多种策略,发现当每个文本在训练数据集中最多出现20,000次时,可以实现最佳性能,为了验证这个理论他们甚至将在初始数据池中出现5400万次的单词 “photo”在训练数据中也被限制为20,000对图像-文本。使用这种策略,MetaCLIP在来自Common Crawl数据集的400M图像-文本对上进行了训练,在各种基准测试中表现优于OpenAI的CLIP模型。

https://arxiv.org/abs/2309.16671

DFN: Data Filtering Networks
文生图的基石CLIP模型的发展综述

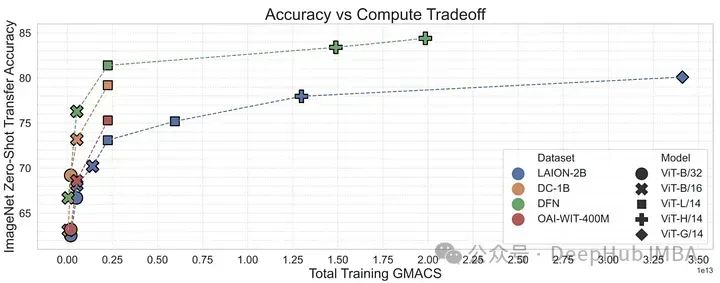
有了MetaCLIP的研究,可以说明数据管理可能是训练高性能多模态模型(如CLIP)的最重要因素。MetaCLIP的过滤策略非常成功,但它也主要基于启发式的方法。研究人员又将研究目标变为是否可以训练一个模型来更有效地进行这种过滤。

为了验证这一点,作者使用来自概念性12M的高质量数据来训练CLIP模型,从低质量数据中过滤高质量数据。这个数据过滤网络(DFN)被用来构建一个更大的高质量数据集,方法是只从一个未经管理的数据集(在本例中是Common Crawl)中选择高质量数据。在过滤后的数据上训练的CLIP模型优于仅在初始高质量数据上训练的模型和在大量未过滤数据上训练的模型。

https://arxiv.org/abs/2309.17425

总结

OpenAI的CLIP模型显著地改变了我们处理多模态数据的方式。但是CLIP只是一个开始。从预训练数据到训练方法和对比损失函数的细节,CLIP家族在过去几年中取得了令人难以置信的进步。ALIGN缩放噪声文本,K-LITE增强外部知识,OpenCLIP研究缩放定律,MetaCLIP优化数据管理,DFN增强数据质量。这些模型加深了我们对CLIP在多模态人工智能发展中的作用的理解,展示了在连接图像和文本方面的进步。

以上就是文生图的基石CLIP模型的发展综述的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/798474.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
小米Civi 8 系统权限管理_小米Civi 8 应用权限设置教程
上一篇 2025年11月26日 16:56:06
《刺客信条:影》发布版本更新 新增故事与修复调整
下一篇 2025年11月26日 16:56:10

相关推荐

  • 曹德旺:我承诺捐100亿元办大学一定算数

    全球每3块汽车玻璃,就有1块来自中国的福耀集团。近年来,这位将一块玻璃“做到极致”的企业家曹德旺,又将大量的资金和精力,投入到了筹建福耀科技大学的事业中。 近日,人民日报记者对曹德旺进行了专访,就其办学初衷、对传统制造业转型以及民营经济发展的理解等热点问题,进行了深入的探讨。 谈办学:“期待培养出对…

    2026年9月23日
    200
  • 前端危!Gemini 3 内测结果获网友一致好评,“有史以来最强前端开发模型”

    前端危!Gemini 3 内测结果获网友一致好评,“有史以来最强前端开发模型”前端危!Gemini 3 内测结果获网友一致好评,“有史以来最强前端开发模型”前端危!Gemini 3 内测结果获网友一致好评,“有史以来最强前端开发模型”前端危!Gemini 3 内测结果获网友一致好评,“有史以来最强前端开发模型”

    谷歌下一代旗舰模型gemini 3未发布便已悄然走红! 原因很简单:强,实在是太强了。 在国外社交媒体平台上,一大波网友激动地分享了 Gemini 3 的内测结果—— 从曝光的这些案例来看,Gemini 3尤为擅长前端、SVG 矢量图生成,而且多模态能力变得更强。 立即学习“前端免费学习笔记(深入)…

    2026年9月23日 用户投稿
    000
  • X 旗下 Grok 推出即时语音搜索功能 向 Google 发起挑战?

    近日,X 平台的人工智能助手 Grok 正式上线“即时语音搜索”功能,用户现在可通过语音直接提问,触发实时网络检索,并迅速获得整合后的精准答复。这项新能力意在优化信息查询流程,推动人机互动向更自然、高效的形态发展。 根据官方说明与实际用户体验,Grok 的语音搜索实现了“说话即搜、即时回应”的流畅体…

    2026年9月23日
    100
  • AdobePhotoshop的AI混合工具怎么用?掌握智能图像编辑的教程

    Photoshop的AI混合工具以生成式填充和神经网络滤镜为代表,通过语义理解实现智能图像融合。生成式填充可依据文本提示添加、移除或扩展内容,自动匹配光影与纹理;神经网络滤镜如和谐化则优化颜色与光照匹配。与传统基于像素计算的混合模式不同,AI工具理解图像内容,实现“生成并融合”。使用时需精准输入英文…

    2026年9月23日
    100
  • 如何利用Swoole实现高性能的分布式机器学习

    在当今大数据时代,机器学习作为一种强大的工具被广泛应用于各个领域。然而,由于数据量的急剧增大和模型的复杂度增加,传统的机器学习方法已经不能满足处理大数据的需求。分布式机器学习应运而生,它将单台机器的处理能力拓展到多台机器上,大大提高了处理效率和模型准确率。而swoole作为一种轻量级的高性能的网络通…

    用户投稿 2026年9月23日
    100
  • 如何在PhotoFiltre中使用AI裁剪图片?快速掌握精准裁剪方法

    如何在PhotoFiltre中使用AI裁剪图片?快速掌握精准裁剪方法如何在PhotoFiltre中使用AI裁剪图片?快速掌握精准裁剪方法如何在PhotoFiltre中使用AI裁剪图片?快速掌握精准裁剪方法如何在PhotoFiltre中使用AI裁剪图片?快速掌握精准裁剪方法

    PhotoFiltre无原生AI裁剪功能,需结合手动裁剪技巧与外部AI工具如Remove.bg、Cutout.pro等协同使用,先用AI完成智能抠图,再导入PhotoFiltre进行精细调整与合成,实现高效精准图像处理。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 Deep…

    2026年9月23日 用户投稿
    200
  • 如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧

    如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧

    Krita虽无内置AI裁剪功能,但可通过其构图辅助线、选区与变换工具实现“智能”裁剪,并结合外部AI工具完成内容扩展与智能构图,形成高效工作流。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Krita本身,作为一款强大的开源数字绘画与图像…

    2026年9月23日 用户投稿
    300
  • 赛力斯与字节跳动合作研发具身智能机器人技术

    赛力斯集团旗下子公司重庆凤凰技术近日与字节跳动旗下的火山引擎正式签署战略合作协议,双方将携手推进具身智能机器人技术的联合研发。 此次合作聚焦于“多模态云边协同的智能机器人决策、控制与人机增强技术”,旨在建立“技术研发—场景验证”一体化闭环体系。火山引擎将提供包括AI算法、多模态大模型及强大算力在内的…

    2026年9月23日
    300
  • 如何在Procreate中使用AI导出图片?保存高质量图像的正确方法

    Procreate无内置AI导出功能,但可通过导出高质量图像(如PSD、TIFF、PNG)供外部AI工具优化;选择格式需根据用途,PSD适合协作,TIFF用于印刷,PNG支持透明背景,JPEG慎用以避免压缩损失;画布应高DPI创建,色彩配置优先sRGB,印刷时后期转CMYK更精准。 ☞☞☞AI 智能…

    2026年9月23日
    100
  • 蚂蚁开源业内首个高性能扩散语言模型推理框架 dInfer

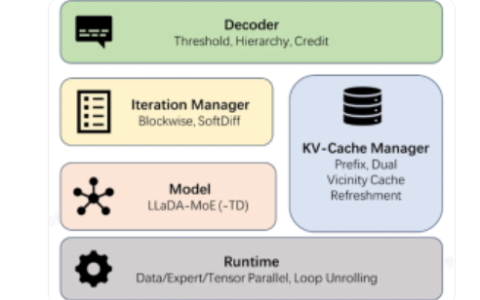
    蚂蚁集团近日正式开源了业界首个高性能扩散语言模型推理框架dinfer。 在多项基准测试中,dInfer展现出卓越的性能表现:其推理速度相较英伟达推出的扩散模型推理框架Fast-dLLM提升了10.7倍;在代码生成任务HumanEval中,单批次推理速度达到惊人的1011 Tokens/秒,首次在开源…

    2026年9月23日
    100
  • Reflection AI 完成 20 亿美元融资,打造“开放智能”

    美国人工智能初创企业 reflection ai 宣布成功募集 20 亿美元资金,其中英伟达领衔投资 8 亿美元,推动公司估值跃升至 80 亿美元。这家成立仅一年的科技新星,致力于打造“人人可及的前沿开放智能(open intelligence)”。 Reflection AI 表示,已集结一支由顶…

    2026年9月23日
    500
  • Airtable的AI混合工具怎么用?快速管理数据的智能化操作步骤

    Airtable的AI混合工具通过将AI能力嵌入数据管理流程,实现自动化处理、分析与内容生成。首先明确AI需求,如总结反馈或生成文案;接着选择AI字段或在自动化中添加AI动作;然后配置模型与提示词,精准设计指令以确保输出质量;指定输入输出字段后进行测试迭代,优化提示词直至满意;最后部署并持续监控。该…

    2026年9月23日
    200
  • 日本科幻战斗飞行游戏《G-Rebels》实机宣传片

    日本科幻战斗飞行游戏《G-Rebels》实机宣传片日本科幻战斗飞行游戏《G-Rebels》实机宣传片日本科幻战斗飞行游戏《G-Rebels》实机宣传片日本科幻战斗飞行游戏《G-Rebels》实机宣传片

    日本开发商reakktor studios公开了飞行模拟游戏《g-rebels》的实机宣传视频,该作是一款开放世界战斗飞行模拟游戏,玩家可以一览《g-rebels》中活力四射和密集的城市群,从精英家园伊甸园到饱受战争蹂躏和被海啸淹没的城市威尼斯。 《G-Rebels》将登陆PC Steam平台,目前…

    2026年9月22日 用户投稿
    200
  • 影目INMO获中国移动创新大奖,10.16发布会AI+AR生态要搞“大动作”?

    2025年中国移动全球合作伙伴大会在广州圆满落幕,影目科技作为智能眼镜领域的领军企业受邀出席,并荣膺“终端创新贡献合作伙伴”殊荣。作为中国移动在ai+ar终端生态中的关键战略伙伴,影目科技正携手中国移动共同推进ai智能眼镜在中国市场的规模化落地,助力打造“ai+万物互联”的智慧新生态。此次获奖恰逢影…

    2026年9月22日
    000
  • 如何在RunwayML导出AI生成的4K图片?保存高清图像的教程

    要从RunwayML获得4K图像,需结合高分辨率生成设置与AI放大工具。首先在RunwayML中选择最高可用分辨率(如1024×1024或更高),并通过精细提示词和负面提示词优化生成质量;随后利用内置增强功能或外部AI放大工具(如Topaz Gigapixel AI、Upscayl)将图像…

    2026年9月22日
    100
  • 如何在CorelDRAW导出AI生成的分层图片?保存矢量图像的步骤

    CorelDRAW无法直接将AI生成的位图导出为分层矢量图,需先导入位图,使用PowerTRACE功能进行描摹矢量化,手动取消组合并按元素类型创建图层分类整理,最后导出AI格式时勾选“保留图层和页面”并设置文本转曲线以确保完整性。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用…

    2026年9月22日
    000
  • AdobePremierePro的AI混合工具怎么用?简化视频编辑的实用方法

    Adobe Premiere Pro的AI混合工具通过变形剪辑、重混音、自动重构图和颜色匹配等功能,显著提升剪辑效率。变形剪辑智能平滑跳剪,使转场更自然;重混音自动调整音乐长度,适配视频节奏;自动重构图利用AI跟踪主体,快速适配多平台比例;颜色匹配则快速统一多素材色彩基调。这些AI功能虽非万能,但在…

    2026年9月22日
    100
  • 巧文书AI官网首页官方入口 巧文书AI在线文档编辑官网链接直达

    巧文书AI官网首页官方入口是https://qiaowenshu.cn,该平台提供AI驱动的文档生成、智能解析、语义扩展、在线编辑与保存等功能,支持多场景文案创作和跨设备同步,具备一键润色、风格推荐及模板管理等智能化写作辅助体验。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用…

    2026年9月21日
    100
  • AI钉钉1.0联动雅里数科 共探“酒旅+AI”的工作新范式

    在数字化浪潮席卷全球的当下,人工智能正以前所未有的速度重塑各行各业,酒旅产业也正在迎来由ai驱动的深刻变革。10月11日,阿里巴巴钉钉再度走进雅里数科集团,开启一场关于“酒旅行业ai原生工作方式”的深度对话。此次交流标志着双方合作迈入全新阶段,致力于共同探索ai原生工作范式,引领酒旅行业迈向智能化发…

    2026年9月21日
    200
  • Figma中AI插件生成的图片如何导出?快速导出的详细操作指南

    AI插件生成的图片在Figma中以普通图层形式存在,需选中后通过右侧导出面板设置格式(PNG/JPG)、尺寸倍数(1x/2x/3x)并点击导出;支持多选图层或使用切片工具批量导出,结合命名规范与质量权衡可高效管理大量AI图像资产。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用…

    2026年9月21日
    500

发表回复

登录后才能评论
关注微信