Spring Data R2DBC中@Query注解与Flux参数的深度解析

Spring Data R2DBC中@Query注解与Flux参数的深度解析

本文深入探讨了spring data r2dbc在使用`@query`注解时,将`flux`作为方法参数所遇到的`illegalargumentexception: value must not be null`错误。我们分析了该问题的根源在于`@query`注解不支持直接处理响应式流参数,并提供了解决方案:优先利用spring data的派生查询机制处理`flux`参数,以实现类似`findallbyid(publisher idstream)`的功能,避免不必要的`@query`使用。

理解Spring Data R2DBC与自定义查询

Spring Data R2DBC为响应式关系型数据库操作提供了强大的抽象层。通过定义Repository接口并继承ReactiveCrudRepository等,开发者可以轻松实现基本的CRUD操作。对于更复杂的查询,Spring Data提供了多种机制,其中@Query注解允许开发者直接编写SQL语句,以实现高度定制化的数据访问逻辑。

然而,在处理响应式流(如Flux)作为查询参数时,@Query注解的行为可能与预期有所不同,尤其是在试图模拟内置的批量操作时。

@Query注解与Flux参数的冲突

当尝试在自定义Repository方法中使用@Query注解,并传入一个Flux类型的参数时,例如:

public interface PersonRepository extends ReactiveCrudRepository {    @Query("SELECT id, name FROM Person WHERE id = ?")    Flux myMethod(Flux person); // 尝试使用Flux作为参数}

在实际执行时,这会导致一个IllegalArgumentException: Value must not be null的错误。完整的异常堆栈会指向org.springframework.util.Assert.notNull和org.springframework.r2dbc.core.Parameter.from,表明在参数绑定阶段,Spring Data R2DBC未能从Flux参数中解析出一个具体的、非空的绑定值。

问题分析:

这个问题的核心在于@Query注解的设计目的。它主要用于绑定单个、已解析的参数值到SQL语句中的占位符(如?或命名参数:param)。当@Query遇到一个Flux或Publisher类型的参数时,它并不会像内置的findAllById(Publisher idStream)方法那样,自动“订阅”这个流并为流中的每个元素执行一次查询,或者将其收集起来生成一个IN子句。相反,它试图将整个Flux对象本身作为一个单一值进行绑定,而Flux对象本身(作为流的描述符而非具体数据)对于SQL参数绑定来说是无效的,因此抛出Value must not be null异常。

换句话说,@Query注解在参数绑定层面,不具备对响应式流进行“解包”或“扁平化映射”(flatMap)的能力。

解决方案:优先使用派生查询

在Spring Data R2DBC中,对于需要以Flux或Publisher作为参数进行批量查询的场景,最佳实践是利用其强大的派生查询(Derived Queries)机制。如果方法名遵循特定的命名约定,Spring Data可以自动生成相应的查询,而无需@Query注解。
面试猫 面试猫

AI面试助手,在线面试神器,助你轻松拿Offer

面试猫 352 查看详情 面试猫

例如,如果你想实现一个根据一系列ID查询Person对象的功能,并且这些ID以Flux的形式提供,你可以这样定义你的Repository方法:

public interface PersonRepository extends ReactiveCrudRepository { // 注意ID类型应与实体ID类型匹配    // Spring Data会自动根据方法名生成查询,支持Flux/Publisher参数    Flux findAllByIdIn(Flux ids); // 或者直接使用 findAllById(Publisher ids)    // 也可以根据其他字段进行批量查询    Flux findAllByNameIn(Flux names);    // 对于单个字段的精确匹配,也可以这样定义    Flux findAllByName(Flux names);}

示例代码:

假设我们有以下Person实体:

import lombok.*;import org.springframework.data.annotation.Id;import org.springframework.data.relational.core.mapping.Column;import org.springframework.data.relational.core.mapping.Table;import reactor.core.publisher.Flux; // 引入Flux@Getter@Setter@ToString@Data@NoArgsConstructor@AllArgsConstructor@Table(value = "Person", schema = "mySchema")public class Person {    @Id    @Column("id")    Long id;    @Column("name")    String name;}

以及其对应的Repository接口:

import org.springframework.data.r2dbc.repository.ReactiveCrudRepository;import reactor.core.publisher.Flux;public interface PersonRepository extends ReactiveCrudRepository {    // 正确的用法:利用派生查询,无需@Query注解    Flux findAllById(Flux idStream); // 效果等同于findAllByIdIn    // 如果需要更具体的名称,也可以使用In关键字    Flux findAllByIdIn(Flux idStream);    // 根据名称批量查询    Flux findAllByNameIn(Flux names);}

在你的主应用中调用:

import org.slf4j.Logger;import org.slf4j.LoggerFactory;import org.springframework.boot.CommandLineRunner;import org.springframework.boot.SpringApplication;import org.springframework.boot.autoconfigure.SpringBootApplication;import org.springframework.boot.context.properties.EnableConfigurationProperties;import org.springframework.context.annotation.Bean;import reactor.core.publisher.Flux;import java.util.function.LongSupplier;import java.util.stream.LongStream;import org.apache.commons.lang3.RandomUtils; // 假设已引入此依赖@SpringBootApplication@EnableConfigurationProperties({ApplicationProperties.class}) // 替换为你的配置属性类public class MyApplication {    private static final Logger logger = LoggerFactory.getLogger(MyApplication.class);    public static void main(String[] args) {        SpringApplication.run(MyApplication.class, args);    }    @Bean    public CommandLineRunner consume(PersonRepository personRepository) {        return args -> {            LongSupplier randomLong = () -> RandomUtils.nextLong(1L, 10L); // 假设ID范围为1-10            Flux personIds = Flux.fromStream(LongStream.generate(randomLong).boxed()).take(3);            logger.info("Generated Person IDs to query: " + personIds.collectList().block()); // 打印生成的ID            // 使用派生查询方法,传入Flux参数            personRepository.findAllById(personIds)                .doOnNext(person -> logger.info("Processed Person: " + person))                .doOnError(e -> logger.error("Error during processing: " + e.getMessage(), e))                .doOnComplete(() -> logger.info("All persons processed."))                .subscribe(); // 订阅以触发执行            // 确保应用程序不会立即退出,以便观察异步结果            Thread.sleep(2000); // 生产环境中不推荐,仅为示例演示        };    }}

注意事项:

Repository方法参数类型: 确保Flux中的元素类型与Repository的ID类型或实体字段类型匹配。方法命名约定: 严格遵循Spring Data的派生查询命名约定(如findBy…、findAllBy…In)。@Query的适用场景: @Query注解更适用于那些无法通过方法名表达的复杂查询,且其参数通常是单个、非响应式的值。如果确实需要自定义SQL且参数是Flux,你可能需要考虑在业务逻辑层先处理Flux,将其收集为List,然后将List作为参数传递给带有IN子句的@Query方法(例如@Query(“SELECT id, name FROM Person WHERE id IN (:ids)”) Flux findByIdsInList(@Param(“ids”) List ids);),但这会引入额外的内存开销和阻塞点(collectList().block())。对于纯响应式场景,派生查询是更优的选择。

总结

在Spring Data R2DBC中,当Repository方法需要以Flux或Publisher作为输入参数时,应优先考虑使用Spring Data提供的派生查询机制,例如findAllById(Flux)或findAllByPropertyIn(Flux)。直接在@Query注解中使用Flux作为参数会导致参数绑定失败,因为它不支持自动解包响应式流。理解这一限制对于编写高效、响应式的Spring Data R2DBC应用至关重要。

以上就是Spring Data R2DBC中@Query注解与Flux参数的深度解析的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/851534.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
《刺客信条:影》1.0.7更新上线 “新游戏+”模式来了
上一篇 2025年11月27日 17:40:23
Perplexity的Discover页面怎么玩 Perplexity探索新热点功能介绍【详解】
下一篇 2025年11月27日 17:40:45

相关推荐

  • fun-汉字转拼音-再也不担心这个字怎么读啦

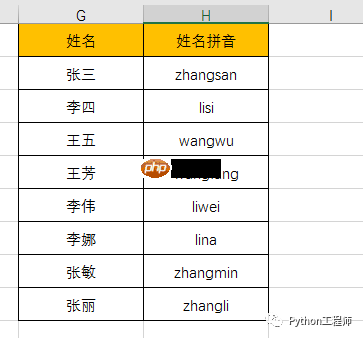
    fun-汉字转拼音-再也不担心这个字怎么读啦fun-汉字转拼音-再也不担心这个字怎么读啦fun-汉字转拼音-再也不担心这个字怎么读啦fun-汉字转拼音-再也不担心这个字怎么读啦

    系统:windows 7语言版本:anaconda3-4.3.0.1-windows-x86_64编辑器:pycharm-community-2016.3.2 这个系列就是整些好玩的今天目标是将汉字转化成拼音 Part 1:目标 根据Excel中G列的姓名,将其转换为拼音对于多个汉字,将其拼音整合成…

    2026年9月29日 • 用户投稿
    100
  • sublime怎样使用模糊文件搜索 sublime快速定位文件的秘诀

    sublime怎样使用模糊文件搜索 sublime快速定位文件的秘诀sublime怎样使用模糊文件搜索 sublime快速定位文件的秘诀sublime怎样使用模糊文件搜索 sublime快速定位文件的秘诀sublime怎样使用模糊文件搜索 sublime快速定位文件的秘诀

    sublime text快速定位文件的核心是ctrl+p(mac为cmd+p)触发的模糊搜索功能,无需输入完整文件名或路径即可智能匹配;2. 其底层采用多维度评分的模糊匹配算法,优先考虑字符连续性、顺序、首字母匹配、路径深度及文件活跃度,实现高效精准的“上下文感知”搜索;3. 该模糊搜索不仅限于文件…

    2026年9月29日 • 用户投稿
    000
  • 亿级流量下线程池参数动态调整方案_Java线程池在高流量场景的优化策略

    亿级流量下线程池参数动态调整方案_Java线程池在高流量场景的优化策略亿级流量下线程池参数动态调整方案_Java线程池在高流量场景的优化策略亿级流量下线程池参数动态调整方案_Java线程池在高流量场景的优化策略亿级流量下线程池参数动态调整方案_Java线程池在高流量场景的优化策略

    java线程池的核心参数包括corepoolsize、maximumpoolsize、keepalivetime、unit、workqueue、threadfactory和rejectedexecutionhandler,它们共同决定线程池的行为;其中corepoolsize表示核心线程数,用于维持…

    2026年9月29日 • 用户投稿
    000
  • 【IPO一线】奇瑞、长安座舱方案供应商镁佳股份正式递表港交所

    【IPO一线】奇瑞、长安座舱方案供应商镁佳股份正式递表港交所【IPO一线】奇瑞、长安座舱方案供应商镁佳股份正式递表港交所【IPO一线】奇瑞、长安座舱方案供应商镁佳股份正式递表港交所【IPO一线】奇瑞、长安座舱方案供应商镁佳股份正式递表港交所

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 6月30日,镁佳股份有限公司(简称:镁佳股份)正式递表港交所。 镁佳股份是一家创新驱动的领先汽车科技公司,致力于重塑未来出行。镁佳股份专注于研发并交付以人工智能(AI)为核心的集成式域控解决方案…

    2026年9月29日 • 用户投稿
    000
  • ​Figma 推出新功能,让 AI 与设计工具无缝对接

    ​Figma 推出新功能,让 AI 与设计工具无缝对接​Figma 推出新功能,让 AI 与设计工具无缝对接​Figma 推出新功能,让 AI 与设计工具无缝对接​Figma 推出新功能,让 AI 与设计工具无缝对接

    Figma 最近发布了一系列重要更新,目标是让 AI 模型能够直接与 Figma 的应用构建工具交互,并实现远程访问设计内容。这些新功能的核心在于 Figma 的模型上下文协议(MCP)服务器,它作为桥梁,使 AI 模型可以深入访问在 Figma 中创建的设计和原型背后的代码逻辑。 据 Figma …

    2026年9月29日 • 用户投稿
    000
  • 蚂蚁数科提出隐私保护 AI 新算法,可将推理效率提升超过 100 倍

    蚂蚁数科提出隐私保护 AI 新算法,可将推理效率提升超过 100 倍蚂蚁数科提出隐私保护 AI 新算法,可将推理效率提升超过 100 倍蚂蚁数科提出隐私保护 AI 新算法,可将推理效率提升超过 100 倍蚂蚁数科提出隐私保护 AI 新算法,可将推理效率提升超过 100 倍

    近日,全球信息安全领域顶级会议ACM CCS与权威期刊IEEE TDSC相继公布最新录用论文名单,蚂蚁数科两项关于隐私计算的前沿研究成果成功入选。这两项技术聚焦于当前跨机构联合建模中应用最为广泛的梯度提升决策树(GBDT)模型,通过创新性的隐私保护算法设计,攻克了在确保数据安全的前提下实现高效联合训…

    2026年9月29日 • 用户投稿
    000
  • sublime如何集成外部编译系统 sublime自定义编译命令的教程

    sublime如何集成外部编译系统 sublime自定义编译命令的教程sublime如何集成外部编译系统 sublime自定义编译命令的教程sublime如何集成外部编译系统 sublime自定义编译命令的教程sublime如何集成外部编译系统 sublime自定义编译命令的教程

    解决sublime text集成外部编译系统的问题需创建并配置.sublime-build文件:进入preferences -> browse packages…目录,新建文件夹如mybuildsystem,并在其中创建类似java.sublime-build的文件;2. 编辑该文…

    2026年9月29日 • 用户投稿
    000
  • windows怎么清理缩略图缓存_windows缩略图缓存清理方法

    windows怎么清理缩略图缓存_windows缩略图缓存清理方法windows怎么清理缩略图缓存_windows缩略图缓存清理方法windows怎么清理缩略图缓存_windows缩略图缓存清理方法windows怎么清理缩略图缓存_windows缩略图缓存清理方法

    首先通过磁盘清理工具删除缩略图缓存,再手动或命令行清除Thumbs.db文件,最后可禁用缩略图功能防止问题复发。 如果您发现Windows系统中缩略图显示异常或占用过多磁盘空间,可能是缩略图缓存积累过多导致的。清理缩略图缓存可以释放存储空间并修复显示问题。以下是解决此问题的步骤: 本文运行环境:De…

    2026年9月29日 • 用户投稿
    000
  • 苹果官网登录入口定位-如何便捷访问苹果官方账号

    苹果官网登录入口定位-如何便捷访问苹果官方账号苹果官网登录入口定位-如何便捷访问苹果官方账号苹果官网登录入口定位-如何便捷访问苹果官方账号苹果官网登录入口定位-如何便捷访问苹果官方账号

    苹果官网登录入口位于https://appleid.apple.com/,用户可在此输入邮箱或手机号及密码登录,完成双重认证后管理设备、密码、iCloud存储、支付方式,并实现通讯录、照片、Safari书签等跨平台同步。 苹果官网登录入口定位在哪里?这是不少网友都关注的,接下来由PHP小编为大家带来…

    2026年9月29日 • 用户投稿
    100
  • 构建灵活的参数类型:使用 Builder 模式实现函数式编程

    构建灵活的参数类型:使用 Builder 模式实现函数式编程构建灵活的参数类型:使用 Builder 模式实现函数式编程构建灵活的参数类型:使用 Builder 模式实现函数式编程构建灵活的参数类型:使用 Builder 模式实现函数式编程

    本文介绍如何使用 Builder 模式来构建一个接受 Function 或 Float/Double 作为参数的函数,用于流式处理。通过 Builder 模式,可以避免方法重载带来的代码冗余,并提供一种优雅的方式来处理动态类型的输入,从而简化创意编码应用中的参数配置。 在函数式编程中,我们经常需要构…

    2026年9月29日 • 用户投稿
    000
  • 如何在Java中使用Vector类

    Vector是线程安全的动态数组,位于java.util包中,支持自动扩容;通过new Vector()创建,可用add()添加、get()获取、set()修改、remove()删除元素,支持增强for、迭代器或索引遍历;因同步开销大,性能低于ArrayList,多线程环境适用。 Java中的Vec…

    2026年9月29日
    000
  • 如何在SublimeText中设置代码对比工具?实现文件对比的教程

    如何在SublimeText中设置代码对比工具?实现文件对比的教程如何在SublimeText中设置代码对比工具?实现文件对比的教程如何在SublimeText中设置代码对比工具?实现文件对比的教程如何在SublimeText中设置代码对比工具?实现文件对比的教程

    最直接的方法是安装Diffy插件,通过Package Control安装后,可实现文件、选区或与磁盘文件的对比,操作直观高效,适合日常代码审查与差异追踪。 在Sublime Text中设置代码对比工具,最直接有效的方法通常是安装一个专门的插件,比如广受欢迎的 Diffy ,它能让你在编辑器内部直接进…

    2026年9月29日 • 用户投稿
    100
  • 如何利用数据压缩减少网络传输延迟?

    如何利用数据压缩减少网络传输延迟?如何利用数据压缩减少网络传输延迟?如何利用数据压缩减少网络传输延迟?如何利用数据压缩减少网络传输延迟?

    数据压缩能有效减少网络传输延迟,尤其适用于带宽受限或大数据传输场景。其核心原理是通过消除冗余信息缩小数据包体积,从而缩短传输时间。根据数据类型选择合适的压缩算法至关重要:文本常用gzip、deflate等无损压缩,图像可选JPEG、WebP,音频则用MP3、AAC,其中无损压缩保证数据完整,有损压缩…

    2026年9月29日 • 用户投稿
    100
  • PC版谷歌Play Games服务新功能 语音直接播放攻略

    PC版谷歌Play Games服务新功能 语音直接播放攻略PC版谷歌Play Games服务新功能 语音直接播放攻略PC版谷歌Play Games服务新功能 语音直接播放攻略PC版谷歌Play Games服务新功能 语音直接播放攻略

    谷歌近日宣布,其安卓游戏服务Google Play Games的PC版本正式上线。该平台允许用户在Windows设备上通过虚拟化技术运行安卓游戏,实现跨设备畅玩。目前,支持多平台同步的游戏库已收录超过20万款游戏。 此次发布的一大亮点是全新功能Sidekick。该功能以内置AI助手为核心,基于谷歌自…

    2026年9月29日 • 用户投稿
    100
  • 为什么专业工作站电脑的价格如此昂贵?

    为什么专业工作站电脑的价格如此昂贵?为什么专业工作站电脑的价格如此昂贵?为什么专业工作站电脑的价格如此昂贵?为什么专业工作站电脑的价格如此昂贵?

    专业工作站高价源于其在稳定性、可靠性、性能和认证上的全面优化。首先,采用支持ECC内存的Xeon或Threadripper Pro处理器,保障数据完整性;其次,配备经ISV认证的专业显卡(如Quadro、Radeon Pro),确保专业软件兼容性与高精度计算;再者,主板、电源、散热与企业级存储均按2…

    2026年9月29日 • 用户投稿
    000
  • 微信群消息收不到如何处理

    微信群消息收不到如何处理微信群消息收不到如何处理微信群消息收不到如何处理微信群消息收不到如何处理

    先检查群聊设置和手机权限,90%消息接收问题可解决。1. 关闭微信群“消息免打扰”;2. 开启微信全局通知及声音振动;3. 安卓允许微信后台自启动,苹果开启后台App刷新;4. 切换网络、清理缓存、重启微信或手机;5. 更新微信至最新版本。 微信群消息收不到,别急着找客服,大多数情况是设置或网络问题…

    2026年9月29日 • 用户投稿
    000
  • 如何在SublimeText中设置项目管理?实现多项目切换的配置教程

    如何在SublimeText中设置项目管理?实现多项目切换的配置教程如何在SublimeText中设置项目管理?实现多项目切换的配置教程如何在SublimeText中设置项目管理?实现多项目切换的配置教程如何在SublimeText中设置项目管理?实现多项目切换的配置教程

    答案:通过保存和编辑.sublime-project文件实现项目管理,配置folders和settings定义项目结构与个性化设置,使用“Rebuild Index”解决索引问题,结合Git插件集成版本控制,备份项目文件及用户配置目录确保配置安全。 Sublime Text 的项目管理功能,能让你在…

    2026年9月29日 • 用户投稿
    100
  • Azure Blob 存储上传文件失败:权限问题排查与解决

    Azure Blob 存储上传文件失败:权限问题排查与解决Azure Blob 存储上传文件失败:权限问题排查与解决Azure Blob 存储上传文件失败:权限问题排查与解决Azure Blob 存储上传文件失败:权限问题排查与解决

    Azure Blob 存储上传文件时,有时会遇到“AuthorizationFailure: This request is not authorized to perform this operation”错误。这个错误通常表明您的应用程序没有足够的权限执行上传操作。本文将详细介绍如何排查和解决这…

    2026年9月29日 • 用户投稿
    100
  • Azure Blob 存储上传文件失败:权限错误排查与解决方案

    Azure Blob 存储上传文件失败:权限错误排查与解决方案Azure Blob 存储上传文件失败:权限错误排查与解决方案Azure Blob 存储上传文件失败:权限错误排查与解决方案Azure Blob 存储上传文件失败:权限错误排查与解决方案

    本文档旨在帮助开发者解决在使用 Azure Blob 存储上传文件时遇到的 “AuthorizationFailure” 错误,即权限不足的问题。文章将详细介绍该错误的常见原因,并提供通过配置 Azure 存储账户的网络防火墙规则,添加客户端 IP 地址来解决问题的具体步骤,…

    2026年9月29日 • 用户投稿
    000
  • PHP多维数组:高效提取嵌套结构中最后一个元素的特定值

    本文详细介绍了如何在PHP多维数组中,通过迭代和end()函数,准确获取特定嵌套层级下最后一个子数组中指定元素的值。教程提供了两种实现方式:直接输出和将值存储到新数组中,并强调了数据验证的重要性,以确保处理复杂或动态数据结构的健壮性。 1. 理解问题背景与数组结构 在处理复杂数据,尤其是通过解析xm…

    2026年9月29日
    000

发表回复

登录后才能评论
关注微信