Gremlin-Java中动态插入未知数量顶点的高效策略

Gremlin-Java中动态插入未知数量顶点的高效策略

本文探讨了在gremlin-java中动态插入未知数量顶点的高效策略,避免了特定后端依赖。我们介绍了三种核心方法:通过增量构建遍历实现迭代插入、利用`inject().unfold()`批量处理数据,以及使用tinkerpop 3.6+引入的`mergev()`进行更强大的查找或创建操作。文章提供了详细的代码示例、使用场景分析及注意事项,旨在帮助开发者构建灵活且可扩展的图数据插入方案。

在图数据库应用开发中,尤其是在Gremlin-Java环境中,开发者经常面临需要动态插入未知数量顶点数据的场景。这通常发生在从数据流、CSV文件或其他外部源获取数据时。挑战在于如何构建灵活且后端无关的Gremlin遍历,以高效地处理这些变长的数据批次。本文将深入探讨几种实现此目标的策略,并提供相应的代码示例和最佳实践。

1. 增量构建Gremlin遍历进行迭代插入

对于小批量或需要逐个处理的顶点数据,可以通过在代码中逐步构建Gremlin遍历来实现。这种方法直观且易于理解,适用于对每个顶点进行精细控制的场景。

实现原理:通过反复调用addV()和property()方法,将新的顶点及属性追加到现有的图遍历对象上。最终,通过一个终端步骤(如iterate()或next())提交整个遍历。

示例代码:

import org.apache.tinkerpop.gremlin.process.traversal.dsl.graph.GraphTraversalSource;import org.apache.tinkerpop.gremlin.process.traversal.dsl.graph.GraphTraversal;import org.apache.tinkerpop.gremlin.structure.Vertex;import static org.apache.tinkerpop.gremlin.process.traversal.AnonymousTraversal.anon;import static org.apache.tinkerpop.gremlin.process.traversal.P.eq;import static org.apache.tinkerpop.gremlin.structure.T.id;import static org.apache.tinkerpop.gremlin.structure.T.label;import java.util.List;import java.util.Map;import java.util.HashMap;import java.util.Arrays;public class DynamicVertexInsertion {    // 假设g是一个已初始化的GraphTraversalSource实例    // GraphTraversalSource g = ...;     /**     * 增量构建遍历,插入多个顶点     * @param g GraphTraversalSource实例     * @param verticesToInsert 待插入的顶点数据列表,每个Map代表一个顶点及其属性     * @return 最终的GraphTraversal对象     */    public GraphTraversal insertVerticesIncrementally(GraphTraversalSource g, List<Map> verticesToInsert) {        GraphTraversal query = g.V().as("start"); // 初始化一个起始遍历,不实际执行任何操作        for (Map vertexData : verticesToInsert) {            String vertexLabel = (String) vertexData.getOrDefault("label", "default");            Object vertexId = vertexData.get("id"); // 假设ID是必需的            query = query.addV(vertexLabel);            if (vertexId != null) {                query = query.property(id, vertexId);            }            vertexData.forEach((key, value) -> {                if (!key.equals("id") && !key.equals("label")) { // 避免重复设置id和label                    query.property(key, value);                }            });        }        return query;    }    public static void main(String[] args) {        // 模拟GraphTraversalSource,实际应用中会连接到图数据库        // For demonstration, we'll just show the query building.        // In a real scenario, 'g' would be initialized from a TinkerGraph, Neptune, etc.        GraphTraversalSource g = null; // Placeholder        List<Map> data = Arrays.asList(            new HashMap() {{                put("id", "v1");                put("label", "person");                put("name", "Alice");                put("age", 30);            }},            new HashMap() {{                put("id", "v2");                put("label", "person");                put("name", "Bob");                put("city", "New York");            }},            new HashMap() {{                put("id", "v3");                put("label", "company");                put("name", "Gremlin Inc.");            }}        );        DynamicVertexInsertion inserter = new DynamicVertexInsertion();        GraphTraversal finalTraversal = inserter.insertVerticesIncrementally(g, data);        // 打印生成的Gremlin查询(此为概念性展示,实际执行需要GraphTraversalSource实例)        // System.out.println(finalTraversal.asAdmin().getBytecode());         // 实际执行:        // finalTraversal.iterate(); // 或 .toList() 等终端步骤        System.out.println("Generated Gremlin traversal for incremental insertion (conceptual representation):");        System.out.println("g.addV('person').property(id, 'v1').property('name', 'Alice').property('age', 30).addV('person').property(id, 'v2').property('name', 'Bob').property('city', 'New York').addV('company').property(id, 'v3').property('name', 'Gremlin Inc.').iterate()");    }}

注意事项:

立即学习“Java免费学习笔记(深入)”;

笔魂AI 笔魂AI

笔魂AI绘画-在线AI绘画、AI画图、AI设计工具软件

笔魂AI 403 查看详情 笔魂AI 此方法在处理大量顶点时可能效率不高,因为每个addV和property操作都会增加遍历的长度和复杂性。Java的泛型在构建复杂遍历时可能导致类型推断问题,但对于简单的addV().property()链式调用通常不是大问题。

2. 使用inject().unfold()进行批量插入

对于中等规模的批量插入,inject().unfold()模式提供了一种更简洁和高效的方式。它允许你将一个数据集合注入到遍历中,然后逐个处理这些数据项。

实现原理:

inject()步骤将一个Java集合(如列表)作为数据源注入到遍历中。unfold()步骤将集合中的每个元素展开成独立的流对象。后续的步骤(如addV()、property()、select())可以对这些展开的元素进行操作。select()用于从当前流元素中提取特定键的值。

示例代码:

import org.apache.tinkerpop.gremlin.process.traversal.dsl.graph.GraphTraversalSource;import org.apache.tinkerpop.gremlin.process.traversal.dsl.graph.GraphTraversal;import org.apache.tinkerpop.gremlin.structure.Vertex;import static org.apache.tinkerpop.gremlin.process.traversal.AnonymousTraversal.anon;import static org.apache.tinkerpop.gremlin.process.traversal.P.eq;import static org.apache.tinkerpop.gremlin.process.traversal.dsl.graph.__.select;import static org.apache.tinkerpop.gremlin.structure.T.id;import static org.apache.tinkerpop.gremlin.structure.T.label;import java.util.List;import java.util.Map;import java.util.HashMap;import java.util.Arrays;public class BulkVertexInsertion {    /**     * 使用inject().unfold()批量插入顶点     * @param g GraphTraversalSource实例     * @param verticesToInsert 待插入的顶点数据列表,每个Map代表一个顶点及其属性     */    public void insertVerticesBulk(GraphTraversalSource g, List<Map> verticesToInsert) {        if (verticesToInsert == null || verticesToInsert.isEmpty()) {            return;        }        // 实际执行时,g会是一个连接到图数据库的实例        // 这里只是构建并打印查询        GraphTraversal traversal = g.inject(verticesToInsert) // 注入数据列表                                                     .unfold()               // 展开列表中的每个Map                                                     .addV(select(label))    // 使用Map中的'label'键作为顶点标签                                                     .property(id, select(id)) // 使用Map中的'id'键作为顶点ID                                                     .property("name", select("name")); // 使用Map中的'name'键作为'name'属性        // 如果有其他动态属性,可以继续添加property步骤,或者使用更复杂的逻辑处理所有键值对        // 例如,遍历Map中的所有键值对并添加属性,但Gremlin DSL通常需要显式指定属性键        // 对于动态属性,可能需要更复杂的子遍历或在应用层处理        // 实际执行:        // traversal.iterate();         System.out.println("Generated Gremlin traversal for bulk insertion using inject().unfold() (conceptual representation):");        System.out.println("g.inject([" +                           "    [ id: 'v1', label: 'person', name: 'Alice' ]," +                           "    [ id: 'v2', label: 'person', name: 'Bob' ]," +                           "    [ id: 'v3', label: 'company', name: 'Gremlin Inc.' ]" +                           "]).unfold()." +                           "   addV(select('label')).property(id, select('id')).property('name', select('name')).iterate()");    }    public static void main(String[] args) {        GraphTraversalSource g = null; // Placeholder        List<Map> data = Arrays.asList(            new HashMap() {{                put("id", "v1");                put("label", "person");                put("name", "Alice");            }},            new HashMap() {{                put("id", "v2");                put("label", "person");                put("name", "Bob");            }},            new HashMap() {{                put("id", "v3");                put("label", "company");                put("name", "Gremlin Inc.");            }}        );        BulkVertexInsertion inserter = new BulkVertexInsertion();        inserter.insertVerticesBulk(g, data);    }}

注意事项:

立即学习“Java免费学习笔记(深入)”;

此方法显著提高了效率,因为它将所有数据作为一个整体提交给Gremlin服务器处理。inject()的数据量不宜过大,过大的数据量可能导致内存问题或请求超时。建议进行批处理,将大数据集拆分为多个小批次。对于每个顶点具有不同属性集的情况,需要更复杂的property()链式调用或条件逻辑。如果属性非常动态,可能需要在应用层构建更精细的Gremlin子遍历。

3. 利用mergeV()进行查找或创建(TinkerPop 3.6+)

TinkerPop 3.6及更高版本引入了mergeV()和mergeE()步骤,它们提供了更强大的“查找或创建”(upsert)功能。这对于需要根据某些属性检查顶点是否存在,如果不存在则创建,如果存在则更新其属性的场景非常有用。

实现原理:mergeV()步骤接受一个Map作为参数,其中包含用于匹配现有顶点的键值对,以及用于创建新顶点或更新现有顶点的属性。

示例代码(概念性):

import org.apache.tinkerpop.gremlin.process.traversal.dsl.graph.GraphTraversalSource;import org.apache.tinkerpop.gremlin.structure.Vertex;import java.util.Map;import java.util.HashMap;import java.util.List;import java.util.Arrays;public class MergeVertexExample {    /**     * 使用mergeV()进行查找或创建顶点(TinkerPop 3.6+)     * @param g GraphTraversalSource实例     * @param verticesToUpsert 待处理的顶点数据列表     */    public void upsertVerticesWithMergeV(GraphTraversalSource g, List<Map> verticesToUpsert) {        if (verticesToUpsert == null || verticesToUpsert.isEmpty()) {            return;        }        // 实际执行时,g会是一个连接到图数据库的实例        // 这里只是构建并打印查询        System.out.println("Generated Gremlin traversal for upsert using mergeV() (conceptual representation, TinkerPop 3.6+):");        verticesToUpsert.forEach(vertexData -> {            // 构建匹配条件和创建/更新属性            Map matchCriteria = new HashMap();            matchCriteria.put("id", vertexData.get("id")); // 假设ID是唯一的匹配键            Map onCreate = new HashMap();            onCreate.put(label.getAccessor(), vertexData.getOrDefault("label", "default"));            onCreate.put("name", vertexData.get("name"));            // ... 其他创建时设置的属性            Map onMatch = new HashMap();            onMatch.put("name", vertexData.get("name"));            // ... 其他匹配时更新的属性            // 在Gremlin-Java中构建mergeV()通常需要将Map转换为MapStep            // g.mergeV(matchCriteria).option(onCreate, onCreate).option(onMatch, onMatch).iterate();            System.out.println(String.format(                "g.mergeV([id: '%s']).option(onCreate, [label: '%s', name: '%s']).option(onMatch, [name: '%s']).iterate()",                vertexData.get("id"), vertexData.getOrDefault("label", "default"), vertexData.get("name"), vertexData.get("name")            ));        });    }    public static void main(String[] args) {        GraphTraversalSource g = null; // Placeholder        List<Map> data = Arrays.asList(            new HashMap() {{                put("id", "v1");                put("label", "person");                put("name", "Alice");            }},            new HashMap() {{                put("id", "v2");                put("label", "person");                put("name", "Bob");            }}        );        MergeVertexExample merger = new MergeVertexExample();        merger.upsertVerticesWithMergeV(g, data);    }}

注意事项:

立即学习“Java免费学习笔记(深入)”;

mergeV()是TinkerPop 3.6+版本的新特性。在撰写本文时,某些图数据库(如AWS Neptune)可能尚未完全支持此版本。在部署前务必检查目标后端对TinkerPop版本的支持情况。mergeV()提供了onCreate和onMatch选项,允许你分别定义创建新顶点和匹配现有顶点时的属性设置逻辑,这极大地简化了upsert操作。对于批量upsert,可以结合inject().unfold()与mergeV(),将数据注入并展开,然后对每个元素执行mergeV()操作。

总结与最佳实践

在Gremlin-Java中动态插入未知数量的顶点数据时,选择合适的方法至关重要:

增量构建遍历:适用于少量顶点,或需要高度定制每个顶点插入逻辑的场景。代码直观,但效率较低。inject().unfold()批量插入:对于中等规模的批量插入,这是推荐的通用方法。它将数据作为一个整体提交,减少了网络往返次数,提高了效率。务必注意批次大小,避免单次提交数据量过大。mergeV()(TinkerPop 3.6+):如果你需要执行“查找或创建”(upsert)操作,并且目标图数据库支持TinkerPop 3.6或更高版本,mergeV()是最佳选择。它提供了简洁且功能强大的语义。

通用注意事项:

后端兼容性:始终检查目标图数据库对特定Gremlin步骤和TinkerPop版本的支持。例如,AWS Neptune等托管服务可能在TinkerPop版本更新上有所滞后。性能优化:对于大规模数据,即使使用inject().unfold(),也应考虑将数据分批处理,以避免单个Gremlin请求过大。事务管理:在生产环境中,确保你的插入操作被包含在事务中,以保证数据的一致性和原子性。Gremlin通常在终端步骤(如iterate())执行时自动处理事务,但具体行为可能因后端而异。错误处理:在实际应用中,务必添加健壮的错误处理机制,例如捕获Gremlin执行异常并进行适当的日志记录或重试。

通过理解和应用这些策略,开发者可以在Gremlin-Java中构建出高效、灵活且后端无关的图数据插入解决方案。

以上就是Gremlin-Java中动态插入未知数量顶点的高效策略的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/933948.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Swoole如何实现TCP服务?TCP客户端如何连接?
上一篇 2025年11月29日 14:07:27
mysql数据库设计时如何避免数据冗余
下一篇 2025年11月29日 14:07:30

相关推荐

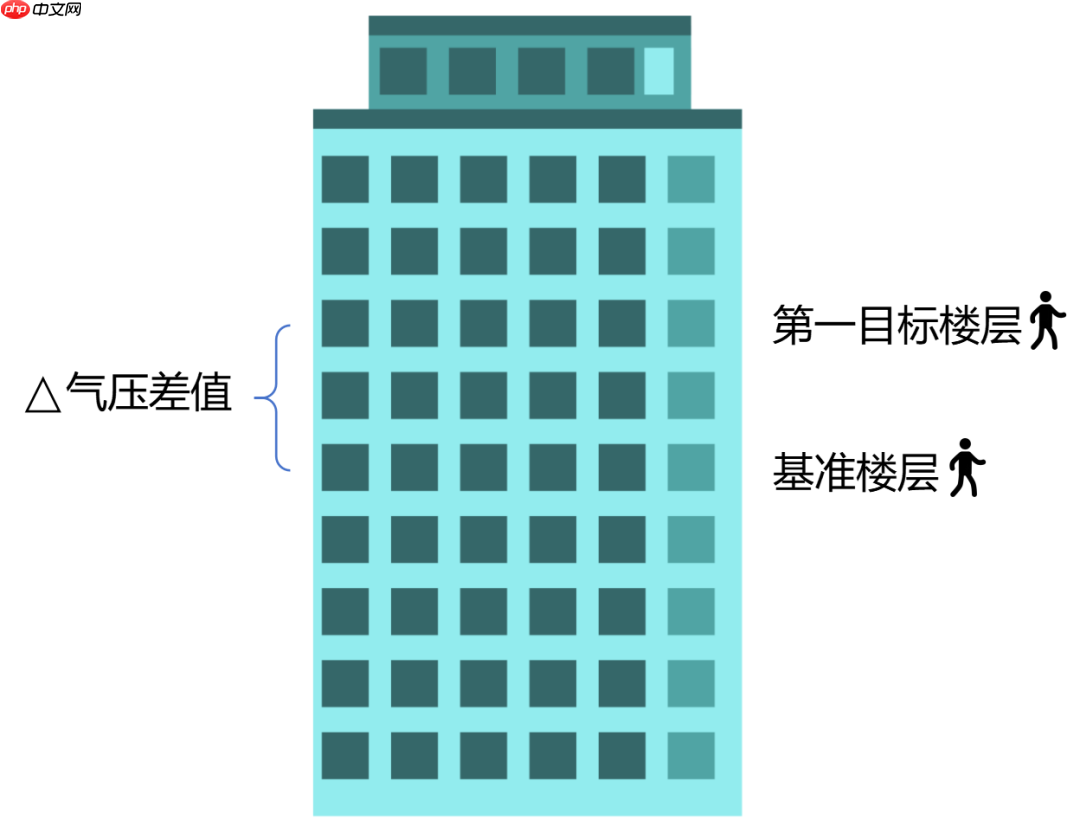
  • 楼层定位,是如何实现的?

    楼层定位,是如何实现的?楼层定位,是如何实现的?楼层定位,是如何实现的?楼层定位,是如何实现的?

    最近带孩子在外地旅行,频繁使用小天才 Z10 儿童电话手表。某次打开配套 App 查看定位时,我注意到一个令人惊讶的细节:App 的地图界面竟然能准确显示孩子当前所在的建筑楼层。 作为一名通信领域的工程师,这个现象立刻引起了我的注意。 我们都知道,常见的电子设备定位方式主要包括 GPS、北斗(GNS…

    2026年9月27日 • 用户投稿
    000
  • sublime怎么让自动补全菜单显示更多信息_sublime自动补全菜单增强信息显示

    sublime怎么让自动补全菜单显示更多信息_sublime自动补全菜单增强信息显示sublime怎么让自动补全菜单显示更多信息_sublime自动补全菜单增强信息显示sublime怎么让自动补全菜单显示更多信息_sublime自动补全菜单增强信息显示sublime怎么让自动补全菜单显示更多信息_sublime自动补全菜单增强信息显示

    启用LSP插件并配置语言服务器,可使Sublime Text补全菜单显示函数签名、参数、类型及文档等详细信息,提升编码效率。 Sublime Text 默认的自动补全菜单只显示简单的函数名或变量名,信息有限。想要让补全项显示更多上下文信息(如参数列表、类型、文档摘要等),可以通过配置设置和安装插件来…

    2026年9月27日 • 用户投稿
    000
  • 什么是泛型?泛型擦除是什么意思?有什么好处和局限?

    什么是泛型?泛型擦除是什么意思?有什么好处和局限?什么是泛型?泛型擦除是什么意思?有什么好处和局限?什么是泛型?泛型擦除是什么意思?有什么好处和局限?什么是泛型?泛型擦除是什么意思?有什么好处和局限?

    泛型通过类型参数提升代码复用与编译期类型安全,Java采用泛型擦除机制以兼容旧版本并简化JVM,但导致运行时无法获取泛型信息,需通过Class对象、通配符、类型令牌等策略应对。 泛型,简单来说,就是我们在编写代码时,能够让方法、类或接口处理多种数据类型的一种能力。它就像给我们的代码加了一层“智能外壳…

    2026年9月27日 • 用户投稿
    000
  • sublime怎么处理超大日志文件_sublime超大日志文件处理技巧

    sublime怎么处理超大日志文件_sublime超大日志文件处理技巧sublime怎么处理超大日志文件_sublime超大日志文件处理技巧sublime怎么处理超大日志文件_sublime超大日志文件处理技巧sublime怎么处理超大日志文件_sublime超大日志文件处理技巧

    通过设置大文件提示阈值和关闭高亮索引功能,可提升Sublime Text处理大日志文件的性能;2. 启用只读模式并分段查看,结合外部工具拆分文件,能有效避免卡顿崩溃;3. 对于GB级日志,建议配合Less、LogExpert等专用工具使用以获得更佳效率。 Sublime Text 虽然轻量高效,但在…

    2026年9月27日 • 用户投稿
    000
  • 创维数字发布H1业绩预告,归母净利润同比预跌76%至65%

    创维数字发布H1业绩预告,归母净利润同比预跌76%至65%创维数字发布H1业绩预告,归母净利润同比预跌76%至65%创维数字发布H1业绩预告,归母净利润同比预跌76%至65%创维数字发布H1业绩预告,归母净利润同比预跌76%至65%

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 7月8日,创维数字发布半年度业绩预告称,报告期内实现归母净利润盈利4300万元至6300万元,与上年同期相比,将减少13882.37万元至11882.37万元,同比下滑76.35%至65.35%…

    2026年9月27日 • 用户投稿
    000
  • 荣耀Magic8系列影像有惊喜 罗巍:没有任何人见过 属于绝密

    荣耀Magic8系列影像有惊喜 罗巍:没有任何人见过 属于绝密荣耀Magic8系列影像有惊喜 罗巍:没有任何人见过 属于绝密荣耀Magic8系列影像有惊喜 罗巍:没有任何人见过 属于绝密荣耀Magic8系列影像有惊喜 罗巍:没有任何人见过 属于绝密

    9月27日,荣耀终端首席影像工程师罗巍透露,荣耀magic8系列将在影像系统上实现重大飞跃。 他提到,手机摄影领域已经多年未见真正意义上的革新,而此次发布会将揭晓未来的发展方向——一项前所未有的技术路径,完全契合我之前提出的硬件投资理念,甚至超越了所有人的想象。 罗巍强调,这一创新项目自他一年前加入…

    2026年9月27日 • 用户投稿
    000
  • SpringCloud 2025微服务架构实战:实现99.99%高可用性的5个关键设计

    SpringCloud 2025微服务架构实战:实现99.99%高可用性的5个关键设计SpringCloud 2025微服务架构实战:实现99.99%高可用性的5个关键设计SpringCloud 2025微服务架构实战:实现99.99%高可用性的5个关键设计SpringCloud 2025微服务架构实战:实现99.99%高可用性的5个关键设计

    要实现99.99%高可用,需融合多区域部署、熔断限流、异步通信、高可用数据存储与自动化运维;通过地理冗余防止单点故障,利用Resilience4j等工具实现服务自我保护,采用消息队列解耦服务并保障最终一致性,确保数据库、缓存、消息队列集群化部署,并依托监控、日志、自动化运维实现快速恢复,构建具备韧性…

    2026年9月27日 • 用户投稿
    000
  • 智能客服真的能7×24小时响应?晓多XPT大模型如何实现淘宝/京东咨询秒回?淘宝/京东咨询秒回!揭秘晓多XPT大模型如何实现7×24小时智能响应

    智能客服真的能7×24小时响应?晓多XPT大模型如何实现淘宝/京东咨询秒回?淘宝/京东咨询秒回!揭秘晓多XPT大模型如何实现7×24小时智能响应智能客服真的能7×24小时响应?晓多XPT大模型如何实现淘宝/京东咨询秒回?淘宝/京东咨询秒回!揭秘晓多XPT大模型如何实现7×24小时智能响应智能客服真的能7×24小时响应?晓多XPT大模型如何实现淘宝/京东咨询秒回?淘宝/京东咨询秒回!揭秘晓多XPT大模型如何实现7×24小时智能响应智能客服真的能7×24小时响应?晓多XPT大模型如何实现淘宝/京东咨询秒回?淘宝/京东咨询秒回!揭秘晓多XPT大模型如何实现7×24小时智能响应

    还在为客服响应迟缓、夜间无人应答、大促期间咨询量激增而烦恼?晓多xpt大模型依托国家生成式人工智能服务备案认证技术,真正实现全天候7×24小时秒级回复,助力淘宝、京东等电商平台牢牢抓住每一个关键转化时刻!基于20亿条电商对话数据训练的语义理解系统,xpt大模型可精准捕捉98.7%的用户需求,响应时间…

    2026年9月27日 • 用户投稿
    000
  • 怎么用豆包AI实现Python数据合并

    怎么用豆包AI实现Python数据合并怎么用豆包AI实现Python数据合并怎么用豆包AI实现Python数据合并怎么用豆包AI实现Python数据合并

    使用豆包ai实现python数据合并的方法如下:1. 描述清楚需求,例如按某一字段合并两个数据表;2. 豆包ai会生成基于pandas的代码示例,如pd.merge或pd.concat;3. 根据反馈调整参数,如连接方式how、拼接方向axis等;4. 利用ai解释代码含义或优化结果。常见合并方式包…

    2026年9月27日 • 用户投稿
    100
  • 多核处理器在运行单线程任务时为何表现不佳?

    多核处理器在运行单线程任务时为何表现不佳?多核处理器在运行单线程任务时为何表现不佳?多核处理器在运行单线程任务时为何表现不佳?多核处理器在运行单线程任务时为何表现不佳?

    多核处理器在运行单线程任务时表现不佳,根本原因在于任务的串行性使其无法并行执行,即便拥有更多核心也难以提升性能。1. 单线程任务只能在一个核心上运行,其他核心无法参与;2. 任务内部存在严格的顺序依赖(如A→B→C),导致无法拆分并行处理;3. 根据Amdahl定律,程序加速比受限于串行部分比例,纯…

    2026年9月27日 • 用户投稿
    500
  • 带动AMD股价上涨7000%:苏妈身家却仅15亿美元!不及黄仁勋1%

    10月12日消息,苏姿丰担任AMD首席执行官已满11年,在其领导下,公司股价累计飙升达7000%。近期因宣布与OpenAI达成合作,股价再度暴涨近40%,市值刷新历史纪录,达到3780亿美元。 尽管带领AMD实现惊人蜕变,并为投资者创造巨额回报,但苏姿丰的个人财富仍未跻身全球富豪前500名。 据《福…

    2026年9月26日
    000
  • ️「领域驱动设计」Java微服务拆分策略与界限上下文划分

    ️「领域驱动设计」Java微服务拆分策略与界限上下文划分️「领域驱动设计」Java微服务拆分策略与界限上下文划分️「领域驱动设计」Java微服务拆分策略与界限上下文划分️「领域驱动设计」Java微服务拆分策略与界限上下文划分

    微服务拆分的核心在于通过领域驱动设计(DDD)识别业务的“自然边界”,其中界限上下文(Bounded Context)是关键。它强调从业务语言和领域专家沟通出发,而非技术视角,确保服务高内聚、低耦合。通过事件风暴、通用语言、业务能力分析等方法识别界限上下文,并结合团队结构与上下文映射明确服务边界。在…

    2026年9月26日 • 用户投稿
    000
  • 如何正确配置防火墙规则以平衡安全与性能?

    如何正确配置防火墙规则以平衡安全与性能?如何正确配置防火墙规则以平衡安全与性能?如何正确配置防火墙规则以平衡安全与性能?如何正确配置防火墙规则以平衡安全与性能?

    答案是:防火墙规则需基于最小权限和默认拒绝原则,结合网络拓扑细化规则、定期审计清理僵尸规则,并利用日志监控优化性能与安全;在云环境则需借助自动化工具实现分布式、细粒度的动态防护。 配置防火墙规则以平衡安全与性能,这从来就不是一个一劳永逸的事情,它更像是一场持续的拉锯战。核心在于,你必须清楚地知道自己…

    2026年9月26日 • 用户投稿
    000
  • DeepSeek + 剪映文字成片:AI写文案+AI配音+AI剪辑一条龙

    DeepSeek + 剪映文字成片:AI写文案+AI配音+AI剪辑一条龙DeepSeek + 剪映文字成片:AI写文案+AI配音+AI剪辑一条龙DeepSeek + 剪映文字成片:AI写文案+AI配音+AI剪辑一条龙DeepSeek + 剪映文字成片:AI写文案+AI配音+AI剪辑一条龙

    使用deepseek和剪映制作视频的流程包括三个步骤:首先,通过明确指令和提供示例优化deepseek生成文案;其次,选择合适配音并调整参数提升剪映ai配音自然度;最后,利用剪映ai剪辑快速生成初版视频并手动精细调整以达到理想效果。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使…

    2026年9月26日 • 用户投稿
    000
  • 京东商品没有客服是怎么回事?快递退货该如何报备?退货报备全流程解析

    京东商品没有客服是怎么回事?快递退货该如何报备?退货报备全流程解析京东商品没有客服是怎么回事?快递退货该如何报备?退货报备全流程解析京东商品没有客服是怎么回事?快递退货该如何报备?退货报备全流程解析京东商品没有客服是怎么回事?快递退货该如何报备?退货报备全流程解析

    在京东购物时,许多用户会发现某些商品页面缺少直接的客服联系入口,一旦遇到商品质量问题或需要售后服务,往往会产生焦虑情绪。此外,在退货过程中如何正确申报快递信息、避免售后纠纷,也成为消费者普遍关心的问题。本文将深入解读京东客服系统的运行逻辑,并详细演示退货报备的完整操作流程。 一、为何部分京东商品不显…

    2026年9月26日 • 用户投稿
    500
  • PHP中动态设置HTML 背景色的正确实践

    <img src="https://img.php.cn/upload/article/001/246/273/175965168921241.jpg" alt="php中动态设置html 背景色的正确实践”>背景色的正确实践” /&…

    用户投稿 2026年9月26日
    000
  • 时隔 6 年,诺基亚 800 Tough 三防神机迎来改款

    时隔 6 年,诺基亚 800 Tough 三防神机迎来改款时隔 6 年,诺基亚 800 Tough 三防神机迎来改款时隔 6 年,诺基亚 800 Tough 三防神机迎来改款时隔 6 年,诺基亚 800 Tough 三防神机迎来改款

    近日有消息源发文爆料,称 hmd global 计划更新诺基亚 800 tough 三防功能机,在保留原版设计前提下,端口升级到 usb-c 接口,系统升级到 kaios 3.1 版本。 据了解,HMD Global 在 2019 年发布经典三防功能手机 —— 诺基亚 800 Tough,而时隔 6…

    2026年9月26日 • 用户投稿
    000
  • Maven进阶实战:多模块项目依赖管理与冲突解决

    Maven进阶实战:多模块项目依赖管理与冲突解决Maven进阶实战:多模块项目依赖管理与冲突解决Maven进阶实战:多模块项目依赖管理与冲突解决Maven进阶实战:多模块项目依赖管理与冲突解决

    答案:Maven多模块项目依赖管理核心在于父POM中使用统一版本、合理划分模块实现高内聚低耦合、通过排除冲突传递依赖,并利用mvn dependency:tree等工具分析依赖树,结合BOM引入、版本属性化管理等策略,确保依赖一致性与项目可维护性。 Maven多模块项目中的依赖管理与冲突解决,核心在…

    2026年9月26日 • 用户投稿
    300
  • Java泛型陷阱:Pair中List类型丢失问题及解决方案

    Java泛型陷阱:Pair中List类型丢失问题及解决方案Java泛型陷阱:Pair中List类型丢失问题及解决方案Java泛型陷阱:Pair中List类型丢失问题及解决方案Java泛型陷阱:Pair中List类型丢失问题及解决方案

    本文探讨了在Java中使用包含List的Pair时,若迭代循环中未正确使用泛型,可能导致List类型信息丢失的问题。核心在于,使用裸类型(Raw Type)的Pair会导致其内部泛型参数被擦除为Object,从而无法访问List特有的方法。解决方案是在循环声明中明确指定泛型类型,以确保编译时类型安全…

    2026年9月26日 • 用户投稿
    300
  • WebSailor— 阿里通义实验室开源的网络智能体

    WebSailor— 阿里通义实验室开源的网络智能体WebSailor— 阿里通义实验室开源的网络智能体WebSailor— 阿里通义实验室开源的网络智能体WebSailor— 阿里通义实验室开源的网络智能体

    WebSailor是什么 websailor 是由阿里通义实验室推出的开源网络智能体,专注于处理复杂的检索与推理任务。借助创新的数据合成方法(如 sailorfog-qa)以及训练技术(包括拒绝采样微调和 dupo 算法),该模型在高难度任务中表现出色,在 browsecomp 等评测中超越多个主流…

    2026年9月26日 • 用户投稿
    300

发表回复

登录后才能评论
关注微信