改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

近日,深度学习领域知名研究者、lightning %ignore_a_1% 的首席人工智能教育者 sebastian raschka 在 cvpr 2023 上发表了主题演讲「scaling pytorch model training with minimal code changes」。

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜

改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

为了能与更多人分享研究成果,Sebastian Raschka 将演讲整理成一篇文章。文章探讨了如何在最小代码更改的情况下扩展 PyTorch 模型训练,并表明重点是利用混合精度(mixed-precision)方法和多 GPU 训练模式,而不是低级机器优化。

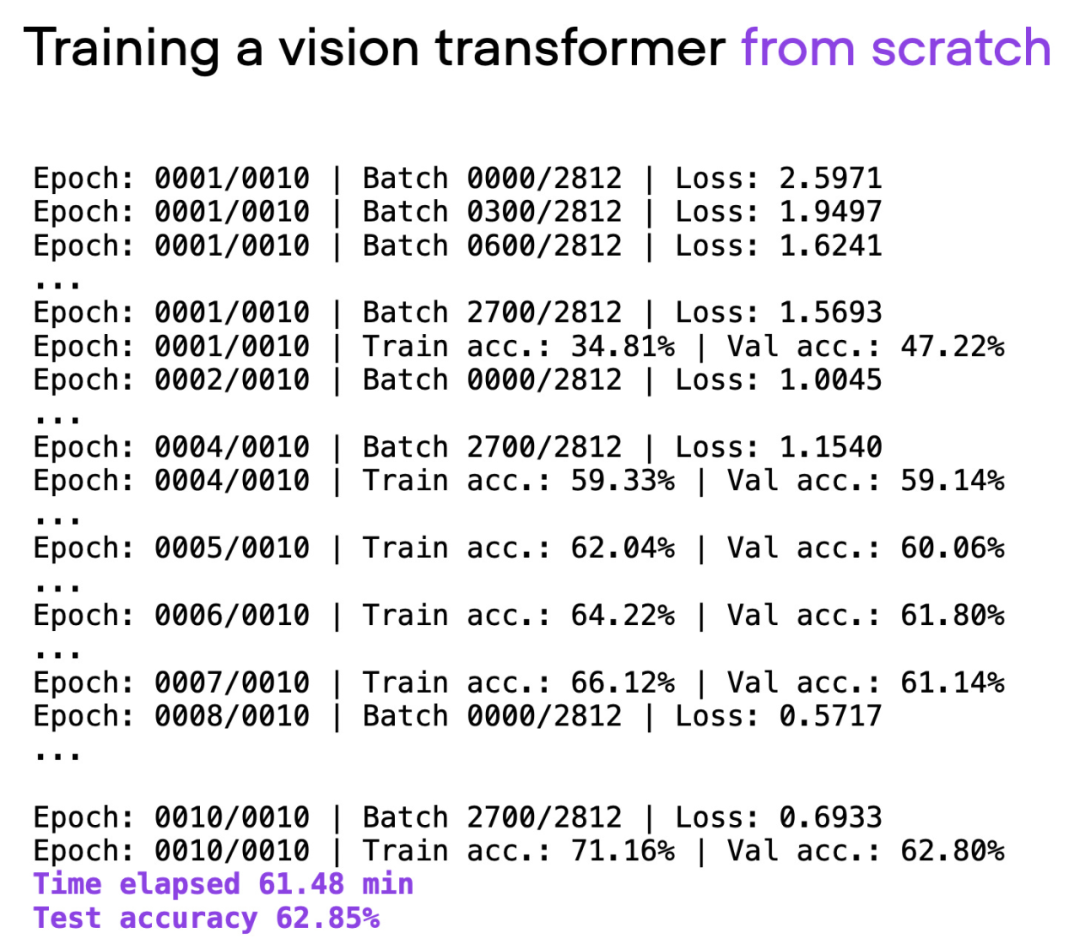
文章使用视觉 Transformer(ViT)作为基础模型,ViT 模型在一个基本数据集上从头开始,经过约 60 分钟的训练,在测试集上取得了 62% 的准确率。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

GitHub 地址:https://github.com/rasbt/cvpr2023

以下是文章原文:

构建基准

在接下来的部分中,Sebastian 将探讨如何在不进行大量代码重构的情况下改善训练时间和准确率。

想要注意的是,模型和数据集的详细信息并不是这里的主要关注点(它们只是为了尽可能简单,以便读者可以在自己的机器上复现,而不需要下载和安装太多的依赖)。所有在这里分享的示例都可以在 GitHub 找到,读者可以探索和重用完整的代码。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

脚本 00_pytorch-vit-random-init.py 的输出。

不要从头开始训练

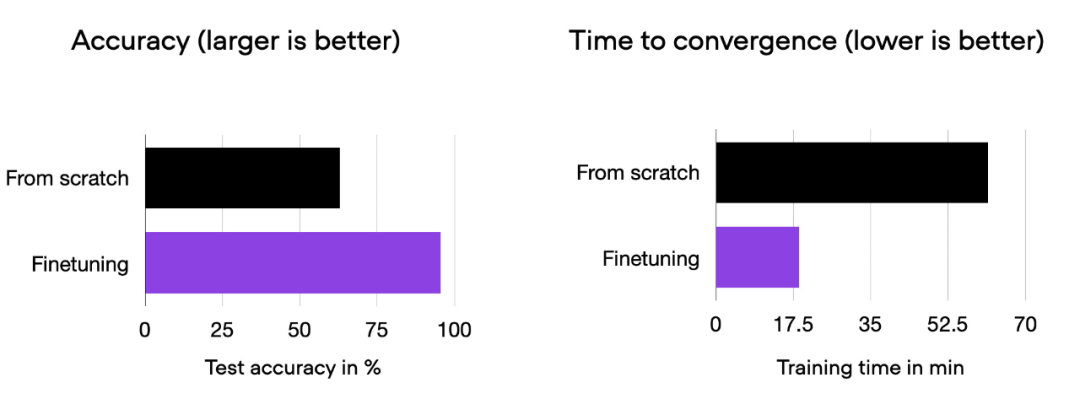
现如今,从头开始训练文本或图像的深度学习模型通常是低效的。我们通常会利用预训练模型,并对模型进行微调,以节省时间和计算资源,同时获得更好的建模效果。

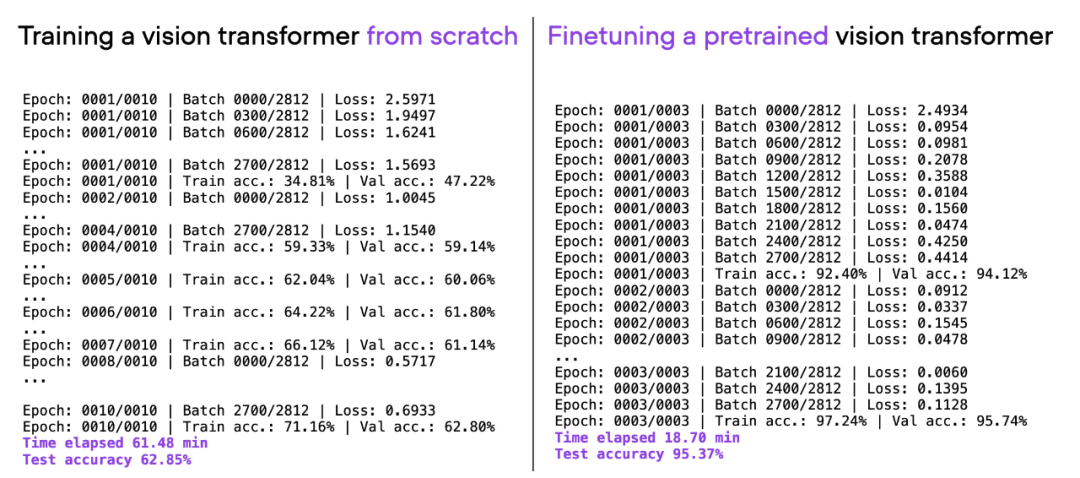
如果考虑上面使用的相同 ViT 架构,在另一个数据集(ImageNet)上进行预训练,并对其进行微调,就可以在更短的时间内实现更好的预测性能:20 分钟(3 个训练 epoch)内达到 95% 的测试准确率。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

00_pytorch-vit-random-init.py 和 01_pytorch-vit.py 的对比。

提升计算性能

我们可以看到,相对于从零开始训练,微调可以大大提升模型性能。下面的柱状图总结了这一点。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

00_pytorch-vit-random-init.py 和 01_pytorch-vit.py 的对比柱状图。

当然,模型效果可能因数据集或任务的不同而有所差异。但对于许多文本和图像任务来说,从一个在通用公共数据集上预训练的模型开始是值得的。

接下来的部分将探索各种技巧,以加快训练时间,同时又不牺牲预测准确性。

开源库 Fabric

在 PyTorch 中以最小代码更改来高效扩展训练的一种方法是使用开源 Fabric 库,它可以看作是 PyTorch 的一个轻量级包装库 / 接口。通过 pip 安装。

pip install lightning

下面探索的所有技术也可以在纯 PyTorch 中实现。Fabric 的目标是使这一过程更加便利。

在探索「加速代码的高级技术」之前,先介绍一下将 Fabric 集成到 PyTorch 代码中需要进行的小改动。一旦完成这些改动,只需要改变一行代码,就可以轻松地使用高级 PyTorch 功能。

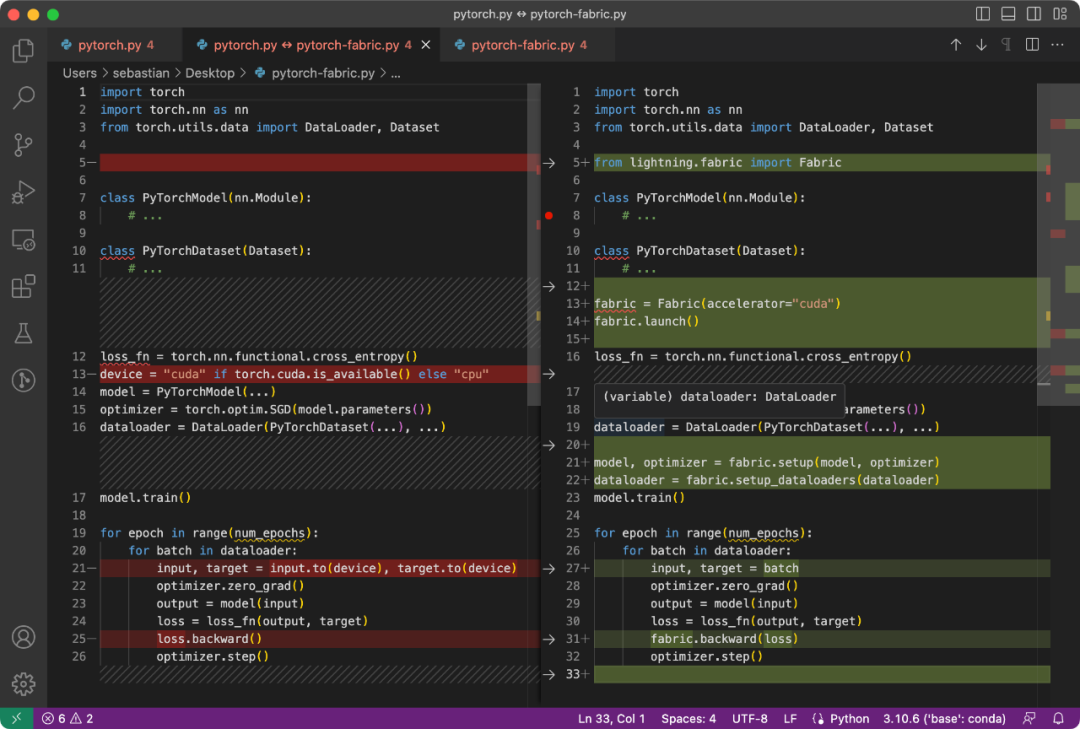
PyTorch 代码和修改后使用 Fabric 的代码之间的区别是微小的,只涉及到一些细微的修改,如下面的代码所示:
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

普通 PyTorch 代码(左)和使用 Fabric 的 PyTorch 代码

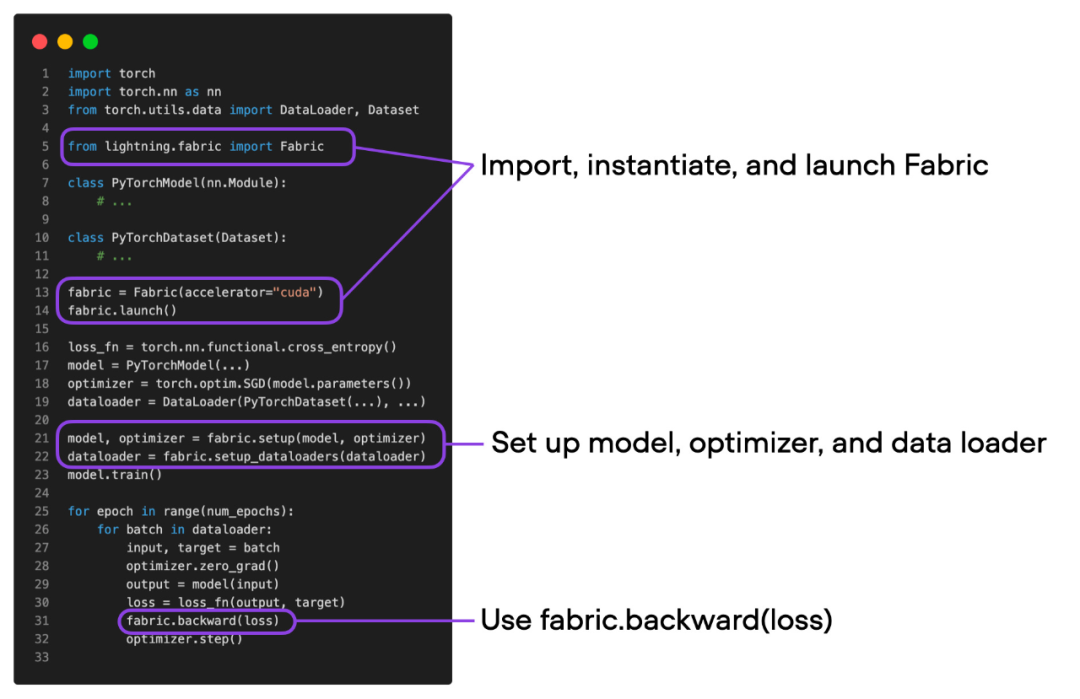
总结一下上图,就可以得到普通的 PyTorch 代码转换为 PyTorch+Fabric 的三个步骤:

导入 Fabric 并实例化一个 Fabric 对象。使用 Fabric 设置模型、优化器和 data loader。损失函数使用 fabric.backward (),而不是 loss.backward ()。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

这些微小的改动提供了一种利用 PyTorch 高级特性的途径,而无需对现有代码进行进一步重构。

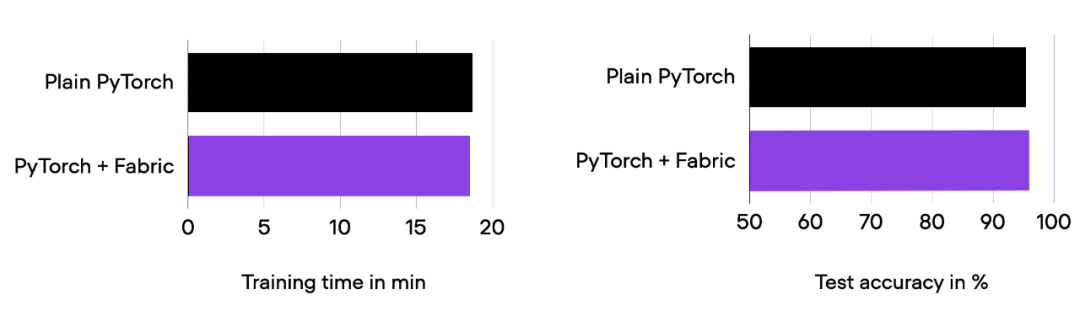
深入探讨下面的「高级特性」之前,要确保模型的训练运行时间、预测性能与之前相同。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

01_pytorch-vit.py 和 03_fabric-vit.py 的比较结果。

正如前面柱状图中所看到的,训练运行时间、准确率与之前完全相同,正如预期的那样。其中,任何波动都可以归因于随机性。

在前面的部分中,我们使用 Fabric 修改了 PyTorch 代码。为什么要费这么大的劲呢?接下来将尝试高级技术,比如混合精度和分布式训练,只需更改一行代码,把下面的代码

fabric = Fabric(accelerator="cuda")

改为

fabric = Fabric(accelerator="cuda", precisinotallow="bf16-mixed")
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

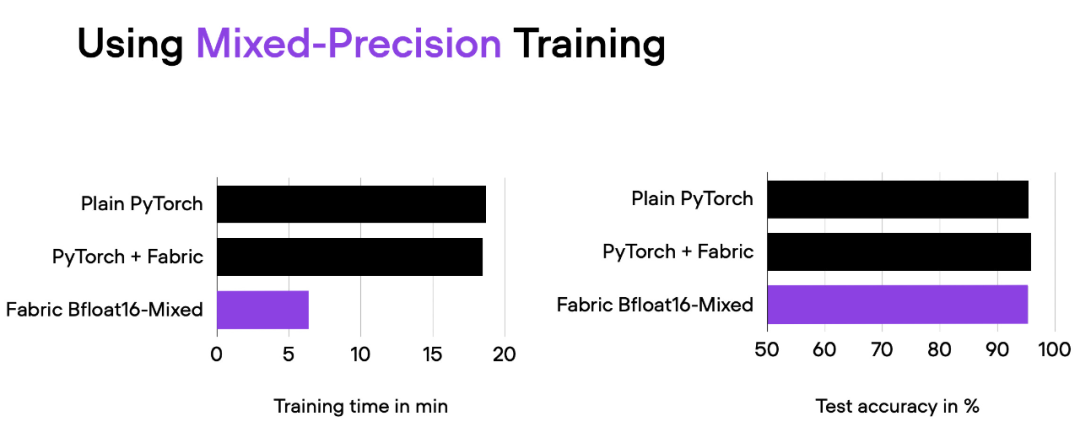
04_fabric-vit-mixed-precision.py 脚本的比较结果。脚本地址:https://github.com/rasbt/cvpr2023/blob/main/04_fabric-vit-mixed-precision.py

通过混合精度训练,我们将训练时间从 18 分钟左右缩短到 6 分钟,同时保持相同的预测性能。这种训练时间的缩短只需在实例化 Fabric 对象时添加参数「precisinotallow=”bf16-mixed”」即可实现。

TextCortex TextCortex

AI写作能手,在几秒钟内创建内容。

TextCortex 62 查看详情 TextCortex

理解混合精度机制

混合精度训练实质上使用了 16 位和 32 位精度,以确保不会损失准确性。16 位表示中的计算梯度比 32 位格式快得多,并且还节省了大量内存。这种策略在内存或计算受限的情况下非常有益。

之所以称为「混合」而不是「低」精度训练,是因为不是将所有参数和操作转换为 16 位浮点数。相反,在训练过程中 32 位和 16 位操作之间切换,因此称为「混合」精度。

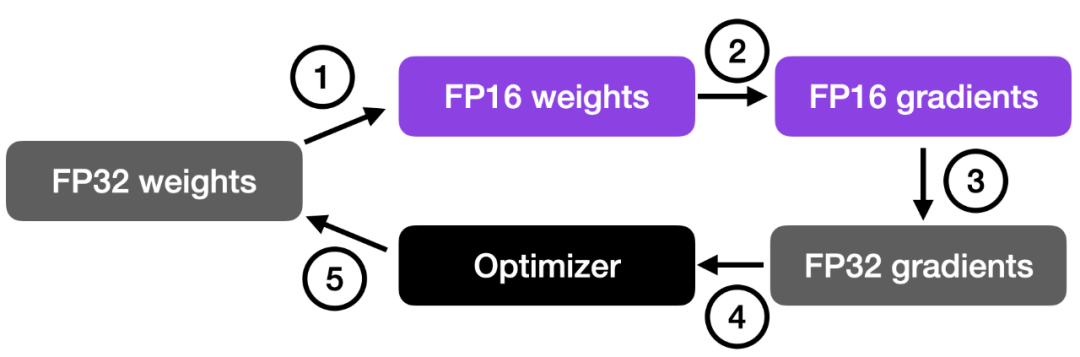
如下图所示,混合精度训练涉及步骤如下:

将权重转换为较低精度(FP16)以加快计算速度;计算梯度;将梯度转换回较高精度(FP32)以保持数值稳定性;使用缩放后的梯度更新原始权重。

这种方法在保持神经网络准确性和稳定性的同时,实现了高效的训练。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

更详细的步骤如下:

将权重转换为 FP16:在这一步中,神经网络的权重(或参数)初始时用 FP32 格式表示,将其转换为较低精度的 FP16 格式。这样可以减少内存占用,并且由于 FP16 操作所需的内存较少,可以更快地被硬件处理。计算梯度:使用较低精度的 FP16 权重进行神经网络的前向传播和反向传播。这一步计算损失函数相对于网络权重的梯度(偏导数),这些梯度用于在优化过程中更新权重。将梯度转换回 FP32:在计算得到 FP16 格式的梯度后,将其转换回较高精度的 FP32 格式。这种转换对于保持数值稳定性非常重要,避免使用较低精度算术时可能出现的梯度消失或梯度爆炸等问题。乘学习率并更新权重:以 FP32 格式表示的梯度乘以学习率将用于更新权重(标量值,用于确定优化过程中的步长)。

步骤 4 中的乘积用于更新原始的 FP32 神经网络权重。学习率有助于控制优化过程的收敛性,对于实现良好的性能非常重要。

Brain Float 16

前面谈到了「float 16-bit」精度训练。需要注意的是,在之前的代码中,指定了 precisinotallow=”bf16-mixed”,而不是 precisinotallow=”16-mixed”。这两个都是有效的选项。

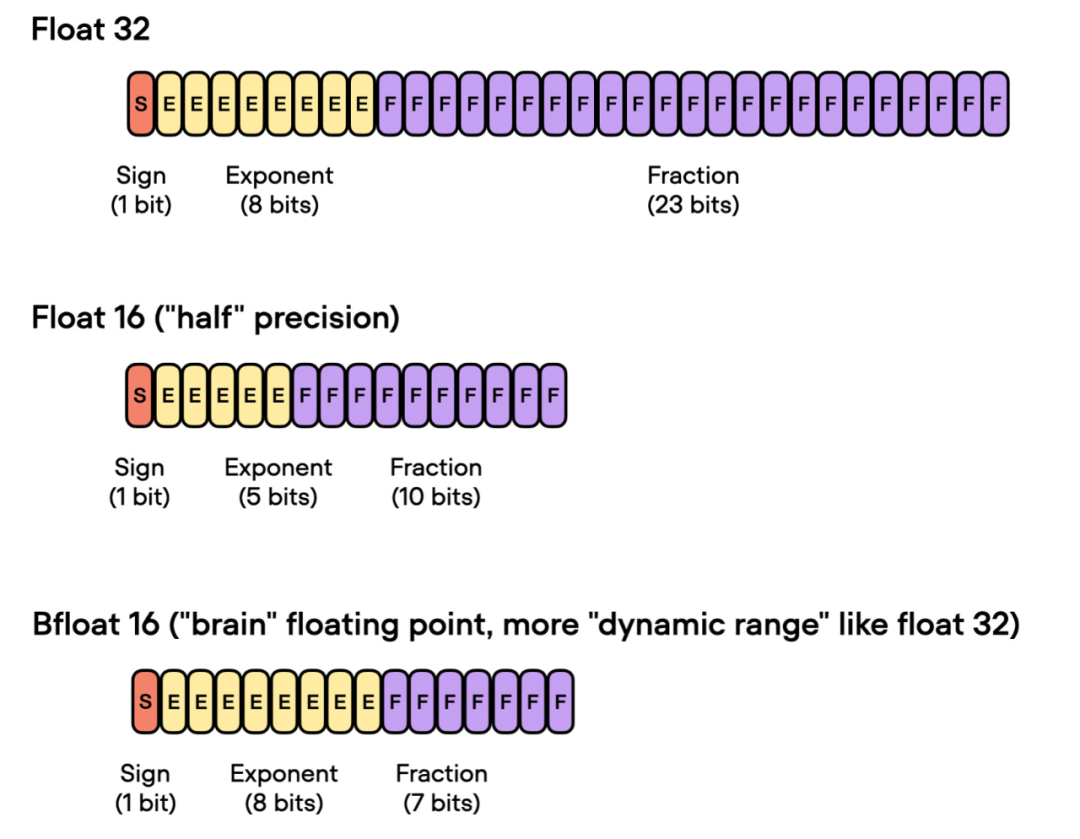
在这里,”bf16-mixed” 中的「bf16」表示 Brain Floating Point(bfloat16)。谷歌开发了这种格式,用于机器学习和深度学习应用,尤其是在张量处理单元(TPU)中。Bfloat16 相比传统的 float16 格式扩展了动态范围,但牺牲了一定的精度。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

扩展的动态范围使得 bfloat16 能够表示非常大和非常小的数字,使其更适用于深度学习应用中可能遇到的数值范围。然而,较低的精度可能会影响某些计算的准确性,或在某些情况下导致舍入误差。但在大多数深度学习应用中,这种降低的精度对建模性能的影响很小。

虽然 bfloat16 最初是为 TPU 开发的,但从 NVIDIA Ampere 架构的 A100 Tensor Core GPU 开始,已经有几种 NVIDIA GPU 开始支持 bfloat16。

我们可以使用下面的代码检查 GPU 是否支持 bfloat16:

>>> torch.cuda.is_bf16_supported()True

如果你的 GPU 不支持 bfloat16,可以将 precisinotallow=”bf16-mixed” 更改为 precisinotallow=”16-mixed”。

多 GPU 训练和完全分片数据并行

接下来要尝试修改多 GPU 训练。如果我们有多个 GPU 可供使用,这会带来好处,因为它可以让我们的模型训练速度更快。

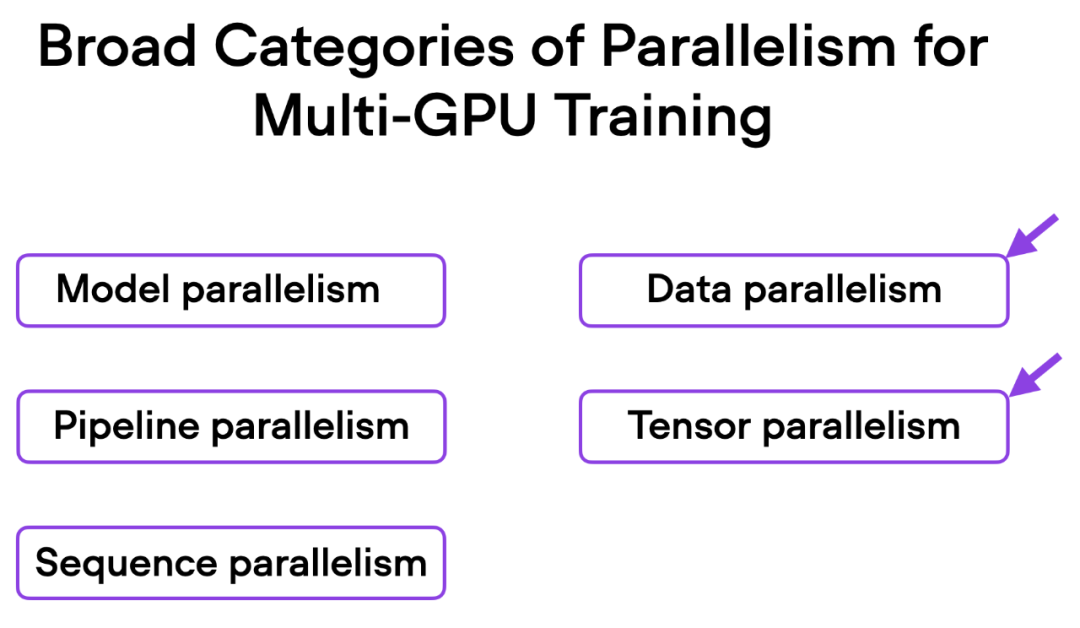
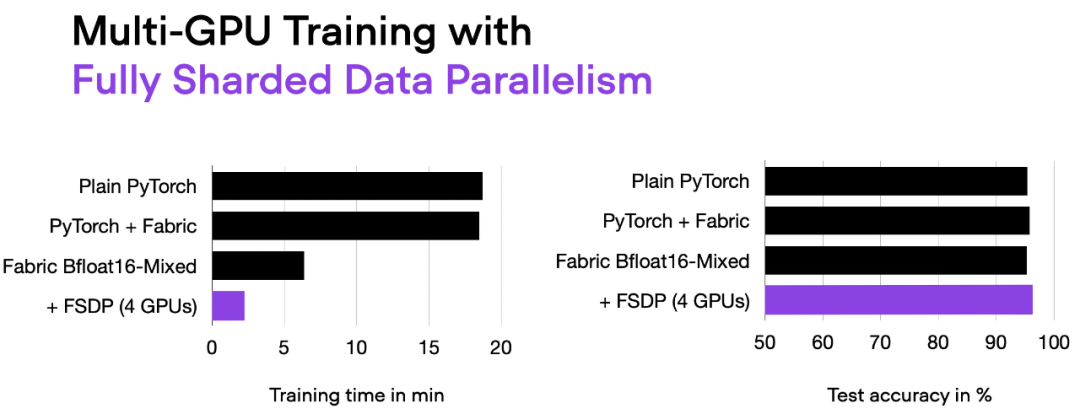
这里介绍一种更先进的技术 — 完全分片数据并行(Fully Sharded Data Parallelism (FSDP)),它同时利用了数据并行性和张量并行性。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

在 Fabric 中,我们可以通过下面的方式利用 FSDP 添加设备数量和多 GPU 训练策略:

fabric = Fabric(accelerator="cuda", precisinotallow="bf16-mixed",devices=4, strategy="FSDP"# new!)
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

06_fabric-vit-mixed-fsdp.py 脚本的输出。

现在使用 4 个 GPU,我们的代码运行时间大约为 2 分钟,是之前仅使用混合精度训练时的近 3 倍。

理解数据并行和张量并行

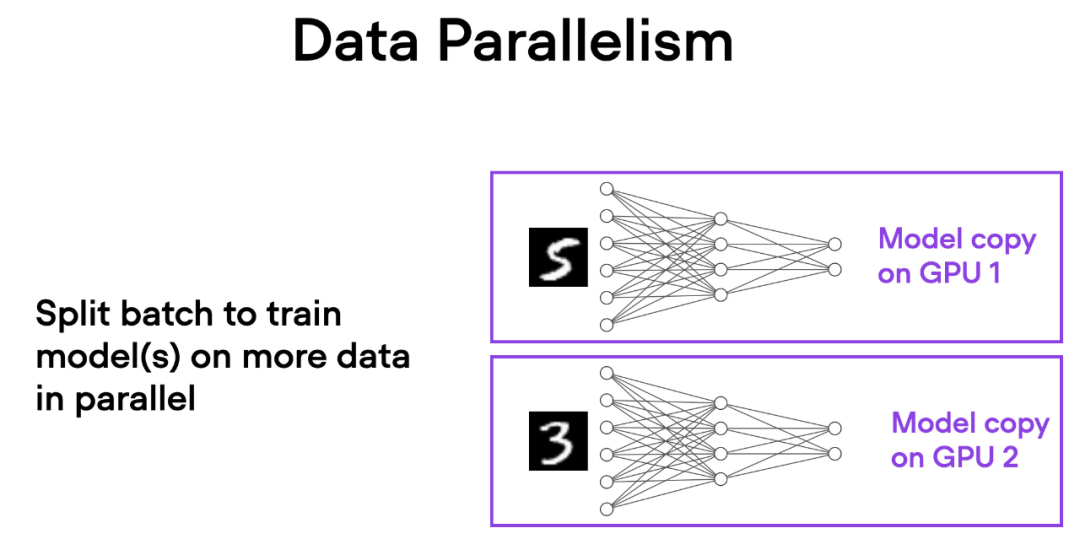
在数据并行中,小批量数据被分割,并且每个 GPU 上都有模型的副本。这个过程通过多个 GPU 的并行工作来加速模型的训练速度。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

如下简要概述了数据并行的工作原理:

同一个模型被复制到所有的 GPU 上。每个 GPU 分别接收不同的输入数据子集(不同的小批量数据)。所有的 GPU 独立地对模型进行前向传播和反向传播,计算各自的局部梯度。收集并对所有 GPU 的梯度求平均值。平均梯度被用于更新模型的参数。

每个 GPU 都在并行地处理不同的数据子集,通过梯度的平均化和参数的更新,整个模型的训练过程得以加速。

这种方法的主要优势是速度。由于每个 GPU 同时处理不同的小批量数据,模型可以在更短的时间内处理更多的数据。这可以显著减少训练模型所需的时间,特别是在处理大型数据集时。

然而,数据并行也有一些限制。最重要的是,每个 GPU 必须具有完整的模型和参数副本。这限制了可以训练的模型大小,因为模型必须适应单个 GPU 的内存。这对于现代的 ViTs 或 LLMs 来说这是不可行的。

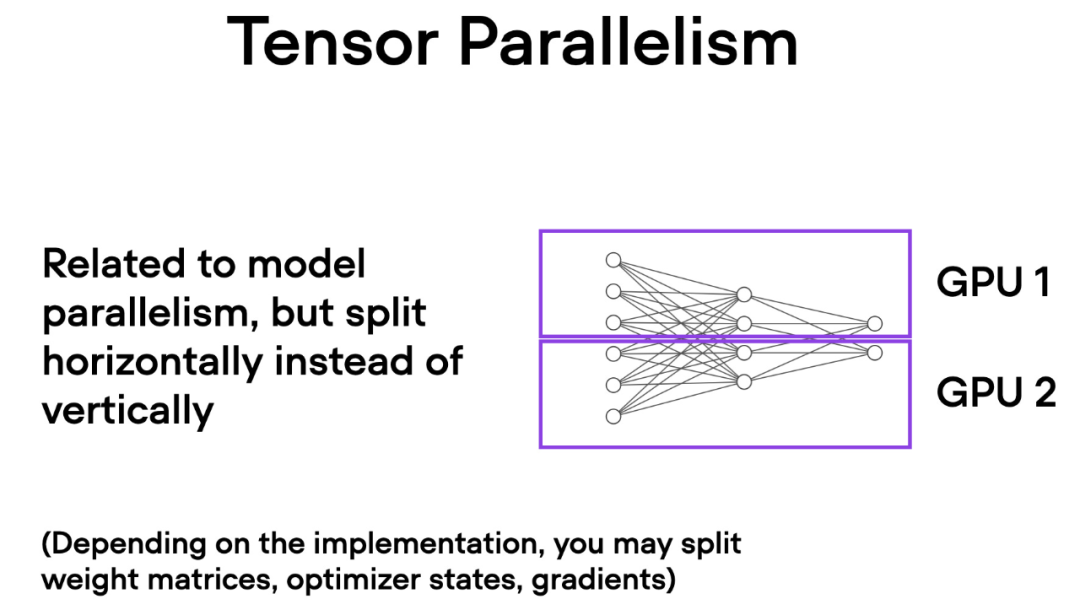
与数据并行不同,张量并行将模型本身划分到多个 GPU 上。并且在数据并行中,每个 GPU 都需要适 应整个模型,这在训练较大的模型时可能成为一个限制。而张量并行允许训练那些对单个 GPU 而言可能过大的模型,通过将模型分解并分布到多个设备上进行训练。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

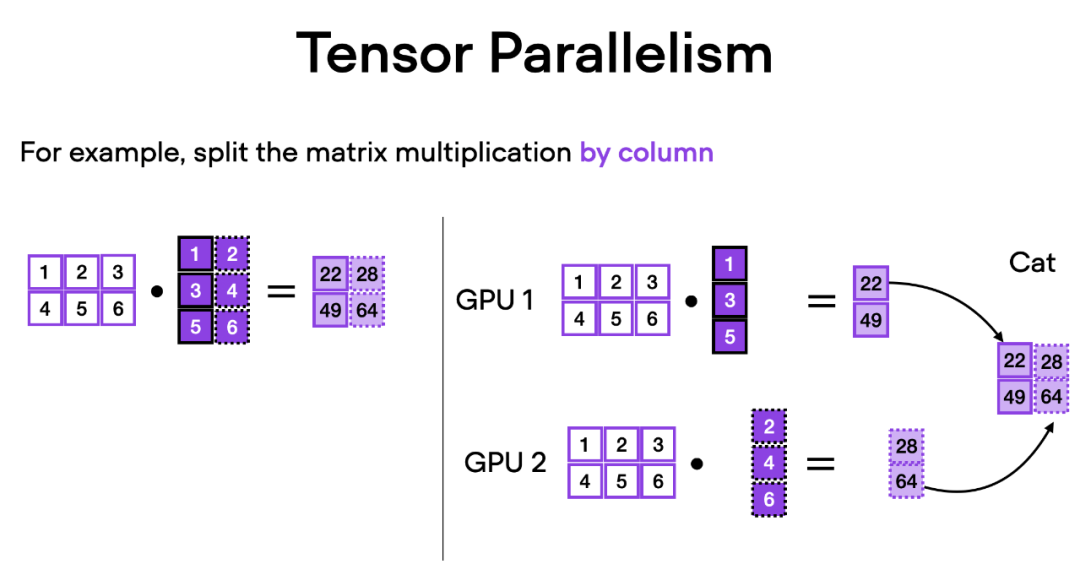
张量并行是如何工作的呢?想象一下矩阵乘法,有两种方式可以进行分布计算 —— 按行或按列。为了简单起见,考虑按列进行分布计算。例如,我们可以将一个大型矩阵乘法操作分解为多个独立的计算,每个计算可以在不同的 GPU 上进行,如下图所示。然后将结果连接起来以获取结果,这有效地分摊了计算负载。
改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键

以上就是改动一行代码,PyTorch训练三倍提速,这些「高级技术」是关键的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/970123.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
正确卸载Smart Audio方法
上一篇 2025年12月1日 19:43:07
iQOO 13 手机中框采用直边大 R 角设计,屏幕黑边“几乎就是 2K 屏的极限”
下一篇 2025年12月1日 19:43:10

相关推荐

  • Java中浮点数比较的陷阱:理解double类型的不精确性与正确比较方法

    java中`double`类型因其二进制浮点表示的固有不精确性,即使在相同java版本和架构下,也可能在不同环境中产生微小的数值差异。直接使用`==`比较浮点数是不可靠的,因为它无法容忍这些细微的舍入误差。正确的做法是采用基于容差(epsilon)的比较方法,通过判断两数之差的绝对值是否小于一个预设…

    2026年9月21日
    100
  • 如何下载豆包电脑网页版_豆包电脑网页版正版链接

    豆包AI电脑及网页版可通过官网和官方应用商店安全获取。1、访问https://www.doubao.com登录使用网页版;2、官网下载电脑客户端,支持Windows和macOS;3、通过Microsoft Store或App Store搜索“豆包 AI”,认准北京字节跳动网络技术有限公司开发,确保正…

    2026年9月21日
    100
  • 如何避免协程中的共享资源竞争?

    避免协程中的共享资源竞争可以通过以下方法:1. 使用锁(locks),如互斥锁或读写锁,确保同一时间只有一个协程访问共享资源。2. 采用无锁数据结构(lock-free data structures),通过原子操作和cas操作提高并发性能。3. 实施消息传递(message passing),通过…

    2026年9月21日
    000
  • Jedis jsonGet 方法返回字节数组值末尾出现 .0 的处理策略

    当使用jedis客户端的`jsonget`方法从redis获取json数据时,如果其中包含字节数组(如xml字符串的字节表示),可能会因底层json库(如gson或org.json)的默认行为,导致数字被统一上转型为`double`类型,从而在输出中显示`.0`后缀。本文将深入探讨此问题产生的原因,…

    2026年9月21日
    200
  • mysql索引的类型和作用有哪些

    MySQL常见索引类型包括:1. 普通索引用于加速查询;2. 唯一索引确保列值唯一;3. 主键索引为唯一非空且自动创建聚簇索引;4. 聚簇索引决定数据物理存储顺序,每表仅一个;5. 非聚簇索引保存主键值,需回表查询;6. 覆盖索引避免回表提升性能;7. 联合索引遵循最左前缀原则;8. 全文索引支持文…

    2026年9月21日
    000
  • AI推文助手如何制作用户指南 AI推文助手的说明文档创作

    AI推文助手如何制作用户指南 AI推文助手的说明文档创作AI推文助手如何制作用户指南 AI推文助手的说明文档创作AI推文助手如何制作用户指南 AI推文助手的说明文档创作AI推文助手如何制作用户指南 AI推文助手的说明文档创作

    答案:配置账户、设定风格模板、生成推文、安排发布时间、监控数据。依次完成绑定社交账号、选择语气类型与关键词、输入主题生成内容、设置定时发布及查看分析仪表板,实现高效创作与优化。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 如果您希望使用A…

    2026年9月21日 用户投稿
    000
  • 安卓跑分第一 Redmi K70 至尊版本月发布

    redmi 今日正式宣布,备受期待的 k70 至尊版将于本月盛大发布,预计将与小米 mix 系列折叠旗舰同台竞技,共同演绎科技之美。据官方最新消息,redmi k70 至尊版将搭载联发科天玑 9300+ 处理器,这款处理器在安兔兔跑分测试中一举突破 238 万分大关,目前稳居安卓性能之巅。天玑 93…

    2026年9月21日
    000
  • 如何为特定语言配置VSCode的语法高亮?

    安装对应语言扩展并关联文件类型,可实现VSCode语法高亮。首先通过扩展面板安装目标语言插件,如Ruby或Rust;若文件扩展名未被识别,需手动将扩展名关联至正确语言;最后可在settings.json中配置editor.tokenColorCustomizations来自定义高亮颜色,确保语法解析…

    2026年9月21日
    000
  • Linux怎么使用systemctl管理服务

    Linux怎么使用systemctl管理服务Linux怎么使用systemctl管理服务Linux怎么使用systemctl管理服务Linux怎么使用systemctl管理服务

    systemctl是Linux中管理systemd服务的核心工具,提供统一命令集来启动、停止、重启、查看服务状态及设置开机自启,支持并行启动、依赖管理与Cgroups资源控制,相比SysVinit更高效;通过创建/etc/systemd/system/下的.service文件可自定义服务,包含[Un…

    2026年9月21日 用户投稿
    100
  • vivo浏览器自带的下载器和迅雷哪个快_vivo浏览器自带下载器与迅雷速度对比说明

    在vivo X90(Android 14)上对比vivo浏览器自带下载器与迅雷的下载速度,需在同一Wi-Fi环境下测试不同大小文件,取多次平均值;2. vivo浏览器依赖系统原生机制,无多线程加速,操作便捷但速度稳定一般;3. 迅雷采用多线程、P2P及缓存技术,大文件下载优势明显,尤其会员开启高速通…

    2026年9月21日
    000
  • Linux如何查看命令别名alias使用方法

    直接输入 alias 命令可列出当前会话所有别名,如需查看特定命令是否为别名可用 type 命令;别名通过简化常用命令提升效率并减少错误,临时别名在当前会话生效,永久别名需写入 ~/.bashrc 或 ~/.zshrc 文件,删除则用 unalias 命令;别名适用于简单命令替换,函数支持参数与逻辑…

    2026年9月21日
    000
  • Java中如何使用Thread.interrupt安全终止线程

    interrupt() 是协作式线程终止机制,设置中断状态并由线程自行处理;2. 阻塞时抛 InterruptedException 且清除状态,需捕获并响应;3. 非阻塞循环中应显式调用 isInterrupted() 检查;4. 捕获异常后应重置中断状态以确保信号传递;5. 使用 Executo…

    2026年9月21日
    200
  • OPPO A3 Pro自动亮度异常解决方法 OPPO A3 Pro屏幕调节技巧

    先检查设置和传感器状态,再排查软硬件问题。关闭省电模式和自动亮度调节,手动调整亮度至50%-70%;清洁屏幕顶部传感器区域,检查手机壳是否遮挡;重启手机,排除第三方应用干扰,更新系统版本;若问题依旧,可能存在非原装屏幕或硬件故障,需联系售后检测。 OPPO A3 Pro出现自动亮度异常,多数情况是设…

    2026年9月21日
    100
  • mysql如何优化子查询

    优先使用JOIN替代相关子查询,减少扫描行数并利用索引;对子查询字段建立合适索引;用EXISTS代替IN处理大量数据;物化不相关子查询结果;避免无索引的标量子查询;通过EXPLAIN分析执行计划优化性能。 MySQL中子查询如果使用不当,容易导致性能下降,尤其是在数据量大的情况下。优化子查询的核心是…

    2026年9月21日
    000
  • 虚拟伴侣AI如何构建记忆库 虚拟伴侣AI长期记忆系统的开发技巧

    虚拟伴侣AI如何构建记忆库 虚拟伴侣AI长期记忆系统的开发技巧虚拟伴侣AI如何构建记忆库 虚拟伴侣AI长期记忆系统的开发技巧虚拟伴侣AI如何构建记忆库 虚拟伴侣AI长期记忆系统的开发技巧虚拟伴侣AI如何构建记忆库 虚拟伴侣AI长期记忆系统的开发技巧

    构建虚拟伴侣AI长期记忆系统需设计分层结构,区分事实、情感与事件记忆,使用向量或图数据库存储并标注元数据;通过自然语言理解提取关键信息,经权重评估后编码存入长期记忆库;借助语义匹配与上下文关联实现记忆唤醒,结合最近邻搜索提升检索效率;引入时间衰减与重复强化机制模拟遗忘规律,定期清理低权记忆;同时实施…

    2026年9月21日 用户投稿
    000
  • 如何在服务器上优化mysql安装

    优化MySQL需从系统环境、配置参数、存储引擎到日常维护多层面入手,首先确保内存合理分配、选用XFS等高性能文件系统、关闭非必要服务并调整内核参数;其次在MySQL配置中优先使用InnoDB引擎,科学设置innodb_buffer_pool_size、innodb_log_file_size、max…

    2026年9月21日
    000
  • 在Java中静态方法能否被重写

    静态方法属于类而非实例,不参与运行时动态绑定,因此不能被重写;2. 子类定义同名静态方法时发生方法隐藏,调用时机由引用类型在编译阶段决定;3. 如示例所示,Parent p = new Child() 调用 p.display() 输出 “Parent static method&#82…

    2026年9月21日
    000
  • Laravel中的服务容器(Service Container)是什么?

    laravel中的服务容器是框架的核心组件,充当服务定位器和依赖注入容器。1)它管理类及其依赖,简化依赖管理,提升代码可测试性和可维护性。2)服务容器是应用架构的基石,帮助拆分复杂业务逻辑成独立服务,提高代码灵活性和可扩展性。3)基本用法包括绑定和解析服务,如app()->bind(&#821…

    2026年9月21日
    100
  • 为什么VSCode的语法高亮有时会失效?

    语法高亮失效通常由语言模式识别错误、扩展冲突或配置问题导致。1. 检查右下角语言模式并手动切换为正确类型,确保文件有正确扩展名;2. 禁用近期安装的扩展或以 code –disable-extensions 启动排查冲突;3. 切换至默认主题并检查 settings.json 是否覆盖颜…

    2026年9月21日
    500
  • 在Java中变量和常量有什么区别

    变量的值可修改,常量(用final修饰)一旦赋值不可变;变量用于动态数据,常量用于固定值,如PI或配置参数。 在Java中,变量和常量的主要区别在于它们的值能否被修改。变量的值可以在程序运行过程中改变,而常量一旦赋值就不能再更改。 变量(Variable) 变量是用于存储数据的基本单元,其值在程序执…

    2026年9月21日
    100

发表回复

登录后才能评论
关注微信