Kafka消费者批量拉取策略:基于字节大小动态控制消息数量

Kafka消费者批量拉取策略:基于字节大小动态控制消息数量

在kafka消费者配置中,`max_poll_records_config`默认限制每次拉取的消息数量。然而,当需要根据消息总字节大小而非固定记录数来动态控制批次时,应优先使用`fetch_max_bytes_config`。通过将`max_poll_records_config`设置为一个足够大的值,并合理配置`fetch_max_bytes_config`,消费者能够实现更灵活、更高效的基于字节的批量消息处理,从而优化资源利用和吞吐量。

理解Kafka消费者批次拉取机制

Kafka消费者通过调用poll()方法从Broker拉取消息。默认情况下,每次poll()调用返回的消息数量受max.poll.records(即MAX_POLL_RECORDS_CONFIG)参数限制,其默认值为500。这意味着无论消息大小如何,最多只能拉取500条消息。

然而,在实际应用中,消息的大小可能差异很大。如果消息都很小,500条可能不足以充分利用网络带宽;如果消息很大,500条消息可能会导致消费者在一次拉取中处理过多的数据,甚至引发内存问题。因此,固定数量的记录限制在某些场景下显得不够灵活,尤其是在希望根据总数据量来控制批次大小以优化性能和资源利用率时。

基于字节大小的动态批次控制:FETCH_MAX_BYTES_CONFIG

为了解决固定记录数限制的不足,Kafka提供了fetch.max.bytes(即FETCH_MAX_BYTES_CONFIG)参数。这个参数用于设置Broker在单次Fetch请求中返回给消费者的最大字节数。它直接影响底层的数据抓取行为,而不仅仅是poll()方法返回的逻辑限制。

通过配置fetch.max.bytes,我们可以实现基于总字节大小的批次控制。例如,如果希望每次拉取的数据总量不超过1MB,就可以将fetch.max.bytes设置为1MB。当Broker准备好发送数据时,它会确保发送的数据总量不超过这个限制。

实现策略

要实现基于字节大小的动态批次控制,需要结合使用fetch.max.bytes和max.poll.records:

闪念贝壳 闪念贝壳

闪念贝壳是一款AI 驱动的智能语音笔记,随时随地用语音记录你的每一个想法。

闪念贝壳 218 查看详情 闪念贝壳 设置fetch.max.bytes: 将此参数设置为你期望的每次拉取批次的最大字节数。例如,如果你希望每次拉取的数据总量不超过1MB,可以将其设置为1048576(字节)。设置max.poll.records为大值: 为了确保fetch.max.bytes成为主要的限制因素,而不是max.poll.records,你需要将max.poll.records设置为一个足够大的值,使其在通常情况下不会达到。例如,可以将其设置为Integer.MAX_VALUE或一个远超日常拉取量的数值。这样,批次大小将主要由fetch.max.bytes决定,即当达到指定字节数时,Broker就会停止发送数据,无论此时发送了多少条记录。

示例代码:

以下是一个Kafka消费者配置的Java示例,展示如何设置这些参数:

import org.apache.kafka.clients.consumer.ConsumerConfig;import org.apache.kafka.clients.consumer.KafkaConsumer;import org.apache.kafka.common.serialization.StringDeserializer;import java.util.Collections;import java.util.Properties;public class ByteAwareKafkaConsumer {    public static void main(String[] args) {        Properties props = new Properties();        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");        props.put(ConsumerConfig.GROUP_ID_CONFIG, "my-byte-aware-group");        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());        // 设置每次Fetch请求的最大字节数,例如1MB        props.put(ConsumerConfig.FETCH_MAX_BYTES_CONFIG, 1 * 1024 * 1024); // 1 MB        // 将max.poll.records设置为一个非常大的值,使其不成为主要限制        // 确保fetch.max.bytes能够发挥作用        props.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, Integer.MAX_VALUE); // 或一个足够大的数,如 100000        KafkaConsumer consumer = new KafkaConsumer(props);        consumer.subscribe(Collections.singletonList("my_topic"));        try {            while (true) {                // poll()方法会返回一个批次的消息,其总大小由FETCH_MAX_BYTES_CONFIG控制                // 且消息数量不会超过MAX_POLL_RECORDS_CONFIG设置的上限                // 但实际上会先达到FETCH_MAX_BYTES_CONFIG的限制                consumer.poll(java.time.Duration.ofMillis(100));                // 处理接收到的消息                // ...            }        } finally {            consumer.close();        }    }}

注意事项与最佳实践

FETCH_MAX_BYTES_CONFIG的影响: 这个参数直接影响Kafka Broker发送给消费者的数据量。设置过小可能导致频繁的网络请求和低吞吐量;设置过大可能导致消费者在一次拉取中处理过多数据,增加内存压力或处理延迟。max.partition.fetch.bytes: 除了fetch.max.bytes,还有一个相关的配置是max.partition.fetch.bytes。它限制了从单个分区拉取的最大字节数。fetch.max.bytes是所有分区总和的限制,而max.partition.fetch.bytes是单个分区的限制。通常,fetch.max.bytes应大于或等于max.partition.fetch.bytes,且max.partition.fetch.bytes的默认值是1MB。如果max.partition.fetch.bytes设置得比fetch.max.bytes还大,那么实际上会以max.partition.fetch.bytes为准。在实践中,合理配置这两个参数以达到最佳平衡。消费者处理能力: 批次大小的调整应与消费者的实际处理能力相匹配。如果消费者处理速度慢,过大的批次可能导致消息堆积和处理延迟。网络带宽: 合理的批次大小可以更有效地利用网络带宽,减少网络往返次数。内存管理: 较大的批次意味着消费者客户端需要更多的内存来存储这些消息。务必确保JVM堆内存配置足以应对最大批次的消息量。

总结

通过灵活运用FETCH_MAX_BYTES_CONFIG并适当调整MAX_POLL_RECORDS_CONFIG,Kafka消费者可以实现基于字节大小的动态批次控制。这种策略比简单的记录数限制更为精细和高效,尤其适用于消息大小不一的场景。它有助于优化网络资源利用、平衡消费者处理负载,并提升整体Kafka消息处理系统的吞吐量和稳定性。在配置时,务必根据实际业务需求、网络环境和消费者处理能力进行权衡和测试,以找到最适合的参数组合。

以上就是Kafka消费者批量拉取策略:基于字节大小动态控制消息数量的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/979646.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
笔记本电脑电源故障维修指南
上一篇 2025年12月1日 20:27:17
sql 中 asin 用法_sql 中 asin 函数反正弦计算教程
下一篇 2025年12月1日 20:27:20

相关推荐

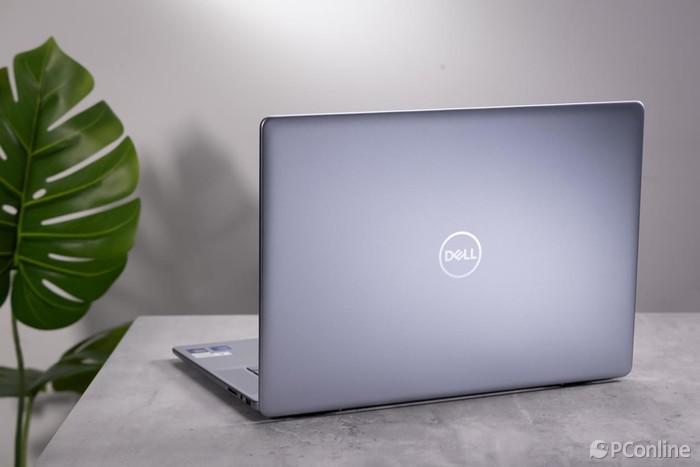
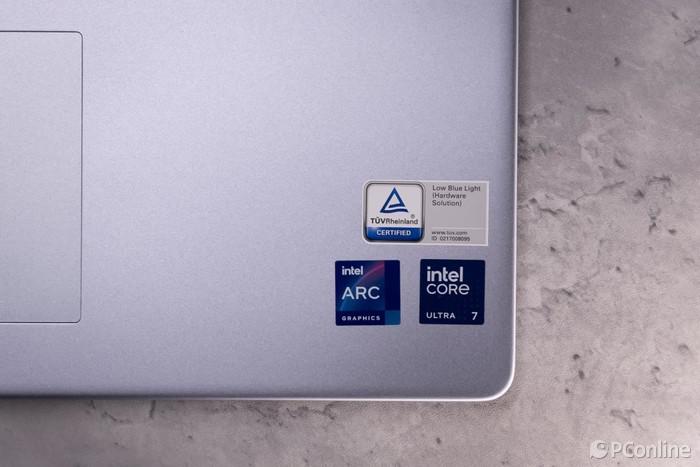
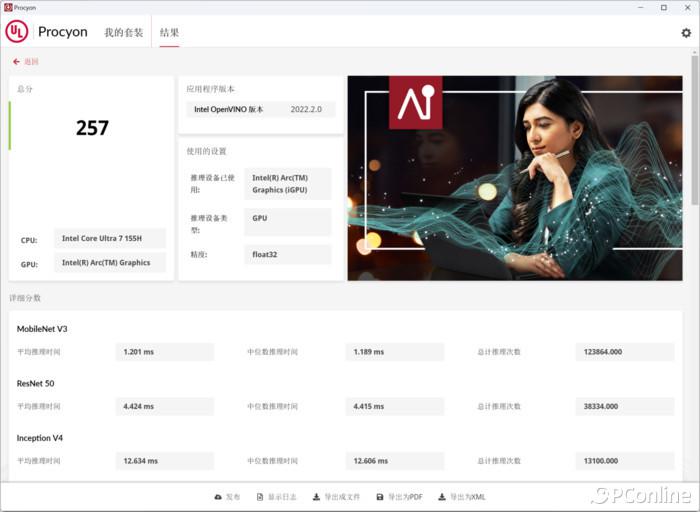
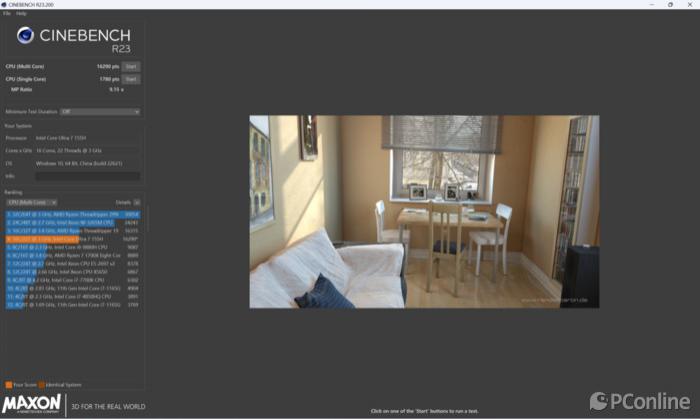
  • 打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

    打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

    进入2024年,无论是硬件厂商还是软件供应商,都开始加大力度,向公众宣扬ai对工作生活乃至游戏的影响。在这样的背景下,选择购买一台全新的笔记本,很难不考量它的ai能力对自身使用的影响。因此,我们可以看到办公轻薄本的 ” 常青树 ” ——戴尔灵越系列,也凭借搭载的英特尔酷睿 u…

    2026年9月21日 用户投稿
    400
  • mysql如何排查磁盘IO瓶颈

    首先检查系统级磁盘IO,使用iostat、iotop等工具分析磁盘利用率和进程IO行为;再通过MySQL慢查询日志、sys.schema视图及SHOW ENGINE INNODB STATUS排查高IO消耗的SQL与内部等待事件;接着评估innodb_buffer_pool_size、innodb_…

    2026年9月21日
    000
  • 在Java中如何创建一个天气查询小应用

    注册OpenWeatherMap获取API密钥;2. 使用Java 11+的HttpClient发送HTTP请求;3. 构造带城市参数的URL并调用天气接口;4. 解析返回的JSON数据提取温度和天气描述;5. 在控制台输出结果,支持中文城市需URL编码。 在Java中创建一个天气查询小应用,核心是…

    2026年9月21日
    000
  • 虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧

    虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧虚拟伴侣AI如何避免对话失误 虚拟伴侣AI错误纠正机制的优化技巧

    当虚拟伴侣AI回应出错时,可通过上下文感知纠错、用户反馈校正、多模型交叉验证、角色规则约束和渐进学习控制五项机制优化。一、建立动态上下文缓存池,比对语义一致性并检测情感或人设冲突,触发重生成;二、捕捉用户显式或隐式反馈,主动确认错误并更新对话状态,积累微调数据;三、部署三个专家模型分别评估逻辑、事实…

    2026年9月21日 用户投稿
    100
  • 如何实现多租户(SaaS)架构?

    多租户架构可以通过三种方法实现:1. 数据库隔离,每个租户有自己的数据库,隔离性好但管理复杂;2. 共享数据库,独立schema,管理较简单但仍需schema管理;3. 共享数据库和schema,通过租户id区分数据,管理最简单但隔离性最差。实现多租户架构需要考虑数据隔离、性能优化、扩展性、自定义和…

    2026年9月21日
    100
  • Java字符串字符计数:避免substring()误用与==比较陷阱

    本文旨在解决java字符串字符计数中常见的陷阱,包括对`substring()`方法的误解、使用`==`进行字符串内容比较的错误以及循环边界条件的设置问题。通过深入解析`charat()`、`equals()`方法,并提供正确的代码示例和调试技巧,帮助开发者编写出高效、准确的字符串处理逻辑,避免初学…

    2026年9月21日
    100
  • mysql如何调试事务问题

    首先通过日志和锁信息确认事务状态,1. 启用通用日志追踪事务操作,2. 查询INNODB_TRX和INNODB_LOCK_WAITS分析活跃事务与阻塞关系,3. 查看死锁日志定位冲突原因,4. 调整隔离级别并优化事务逻辑以避免异常。 调试 MySQL 事务问题需要结合日志分析、锁信息查看和事务状态监…

    2026年9月21日
    100
  • 如何自定义代码的格式化规则?

    自定义代码格式化规则需选择合适工具并配置文件实现统一风格。1. 根据语言选用主流工具如Prettier、Black、clang-format等;2. 在项目根目录创建对应配置文件如.prettierrc、.eslintrc.js或pyproject.toml,定义缩进、引号、行宽等规则;3. 将配置…

    2026年9月21日
    100
  • mysql如何设置自动重连

    答案:通过连接配置、连接池和应用层逻辑实现MySQL自动重连。启用MYSQL_OPT_RECONNECT选项(旧版本),推荐使用连接池如PooledDB、HikariCP并配置ping机制,应用层捕获连接异常后重试,结合指数退避策略提升稳定性。 MySQL 客户端或应用程序在连接断开后无法自动恢复,…

    2026年9月21日
    100
  • 协程调试与性能分析工具

    我们需要协程调试和性能分析工具是因为协程的异步特性使得传统工具难以应对调试和性能优化挑战。1) pycharm 适合基本调试,但处理大量协程时可能变慢。2) aiodebug 适用于检测协程问题,但会增加性能开销。3) asyncio-profiler 用于分析协程性能,但可能难以解读大量协程的结果…

    2026年9月21日
    100
  • AI推文助手如何制作产品教程 AI推文助手的教学内容创作

    AI推文助手如何制作产品教程 AI推文助手的教学内容创作AI推文助手如何制作产品教程 AI推文助手的教学内容创作AI推文助手如何制作产品教程 AI推文助手的教学内容创作AI推文助手如何制作产品教程 AI推文助手的教学内容创作

    使用AI推文助手可高效制作产品教学内容:一、输入产品功能并选择分步教程模板生成图文教程;二、提供操作关键词生成60秒内短视频脚本;三、启用多语言模块并上传术语表生成本地化推文;四、分析客服数据将高频问题转为步骤化解法推文。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 Dee…

    2026年9月21日 用户投稿
    100
  • Android Ksoap2序列化嵌套整数数组到.NET Web服务的解决方案

    本教程旨在解决Android Ksoap2在向.NET Web服务发送包含嵌套整数数组(如`ArrayList`)的自定义对象时遇到的序列化错误。核心解决方案包括将`ArrayList`替换为`Vector`,并为`Vector.class`添加显式Ksoap2类型映射,确保数据正确传输。 在And…

    2026年9月21日
    100
  • 如何利用Draw.io Integration扩展在VSCode中绘制并嵌入架构图?

    安装Draw.io Integration扩展后,可在VSCode中直接创建编辑图表。右键选择“Create Diagram with Draw.io”新建.diagram文件,双击打开内置编辑器,拖拽组件绘制流程图、架构图等。保存后自动生成Base64编码的嵌入代码,粘贴至Markdown即可预览…

    2026年9月21日
    200
  • Java并发编程中CopyOnWriteArrayList使用场景

    CopyOnWriteArrayList适用于读多写少场景,通过写时复制实现线程安全,读操作无锁并发,迭代基于快照不抛异常,适合配置列表、监听器等数据变动少且需高性能读取的并发环境。 在Java并发编程中,CopyOnWriteArrayList 是一种线程安全的List实现,适用于读多写少的并发场…

    2026年9月21日
    100
  • mysql如何理解数据完整性

    数据完整性在MySQL中通过主键、外键、约束等机制确保数据准确一致。1. 实体完整性用主键保证记录唯一,主键非空且不重复;2. 域完整性通过数据类型、CHECK约束、默认值等确保字段数据合法;3. 参照完整性利用外键维护表间关系,支持级联操作;4. 用户定义完整性由开发者通过触发器或程序实现业务规则…

    2026年9月21日
    100
  • 怎样在VSCode中快速生成注释文档?

    安装插件如Document This和Koro File Header,通过快捷键在VSCode中快速生成函数及文件注释,支持自定义模板,提升注释效率与规范性。 在 VSCode 中快速生成注释文档,主要依赖插件和快捷键配合代码语言特性来实现。不同编程语言支持方式略有差异,但核心思路是使用智能提示和…

    2026年9月21日
    200
  • Java中浮点数比较的陷阱:理解double类型的不精确性与正确比较方法

    java中`double`类型因其二进制浮点表示的固有不精确性,即使在相同java版本和架构下,也可能在不同环境中产生微小的数值差异。直接使用`==`比较浮点数是不可靠的,因为它无法容忍这些细微的舍入误差。正确的做法是采用基于容差(epsilon)的比较方法,通过判断两数之差的绝对值是否小于一个预设…

    2026年9月21日
    200
  • 如何下载豆包电脑网页版_豆包电脑网页版正版链接

    豆包AI电脑及网页版可通过官网和官方应用商店安全获取。1、访问https://www.doubao.com登录使用网页版;2、官网下载电脑客户端,支持Windows和macOS;3、通过Microsoft Store或App Store搜索“豆包 AI”,认准北京字节跳动网络技术有限公司开发,确保正…

    2026年9月21日
    200
  • 如何避免协程中的共享资源竞争?

    避免协程中的共享资源竞争可以通过以下方法:1. 使用锁(locks),如互斥锁或读写锁,确保同一时间只有一个协程访问共享资源。2. 采用无锁数据结构(lock-free data structures),通过原子操作和cas操作提高并发性能。3. 实施消息传递(message passing),通过…

    2026年9月21日
    100
  • Java构造方法的执行顺序及注意事项

    构造方法执行顺序为:父类静态代码块→子类静态代码块→父类实例初始化块→父类构造方法→子类实例初始化块→子类构造方法,且super()必须位于子类构造方法首行。 Java构造方法的执行顺序涉及继承关系中父类与子类的初始化过程,理解这一流程对掌握对象创建机制非常重要。当创建一个子类对象时,JVM会自动确…

    2026年9月21日
    100

发表回复

登录后才能评论
关注微信