
udio
-
华为开发者大会2024:HarmonyOS NEXT Beta,AI 大模型开启OS新纪元


2024华为开发者大会(hdc)盛大开幕,重磅发布harmonyos next、盘古大模型5.0等创新成果,展现鸿蒙生态的蓬勃发展和开放实力,为消费者和开发者带来全新体验。 鸿蒙生态:万物互联的新纪元 华为常务董事余承东在主题演讲中分享了鸿蒙生态的显著进展:HarmonyOS设备数量突破9亿,开发者…
-
飞桨常规赛:PALM眼底彩照视盘探测与分割 – 5月第三名方案
该方案为飞桨PALM眼底彩照视盘探测与分割常规赛5月第三名方案。使用PaddleSeg和patta工具,以800张训练图、400张测试图,通过划分训练集和验证集,构建数据集并预处理。采用AttentionUNet模型,结合BCELoss与DiceLoss,经20轮训练,预测时还原图像尺寸,最终生成分…
-
『行远见大』昨日重现 Yesterday Once More


“行远见大”项目借助飞桨开源社区的AI技术修复老视频。通过DeOldify着色、EDVR修复、DAIN插帧等模型,运用GAN等技术,将低质老视频转为高清彩色,提升帧率与画质。项目介绍了修复原理、代码实践流程,致敬开源,让经典在高清中永存,满足人们怀旧与高品质观影需求。 ☞☞☞AI 智能聊天, 问答助…
-
飞桨常规赛:黄斑中央凹定位(GAMMA挑战赛任务二) – 11月第3名方案


本文介绍飞桨常规赛黄斑中央凹定位11月第3名方案。赛题旨在对2D眼底图像中黄斑中央凹定位,预测其坐标,不可见则设为(0,0)。数据集含200个样本,建模为回归问题,用Resnet50vd作backbone,通过数据增强、自定义损失函数等优化,还提及代码结构、复现步骤及不足与改进思路。 ☞☞☞AI 智…
-
【动手学Paddle2.0系列】低配版PP-YoLo代码实战
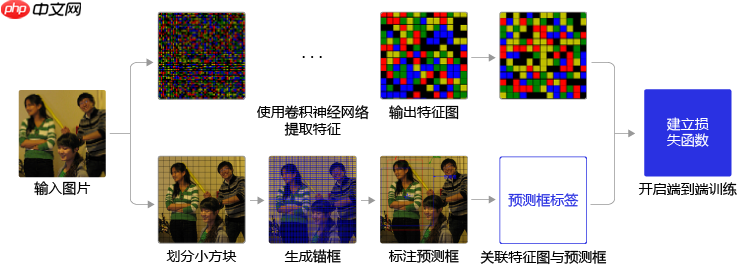
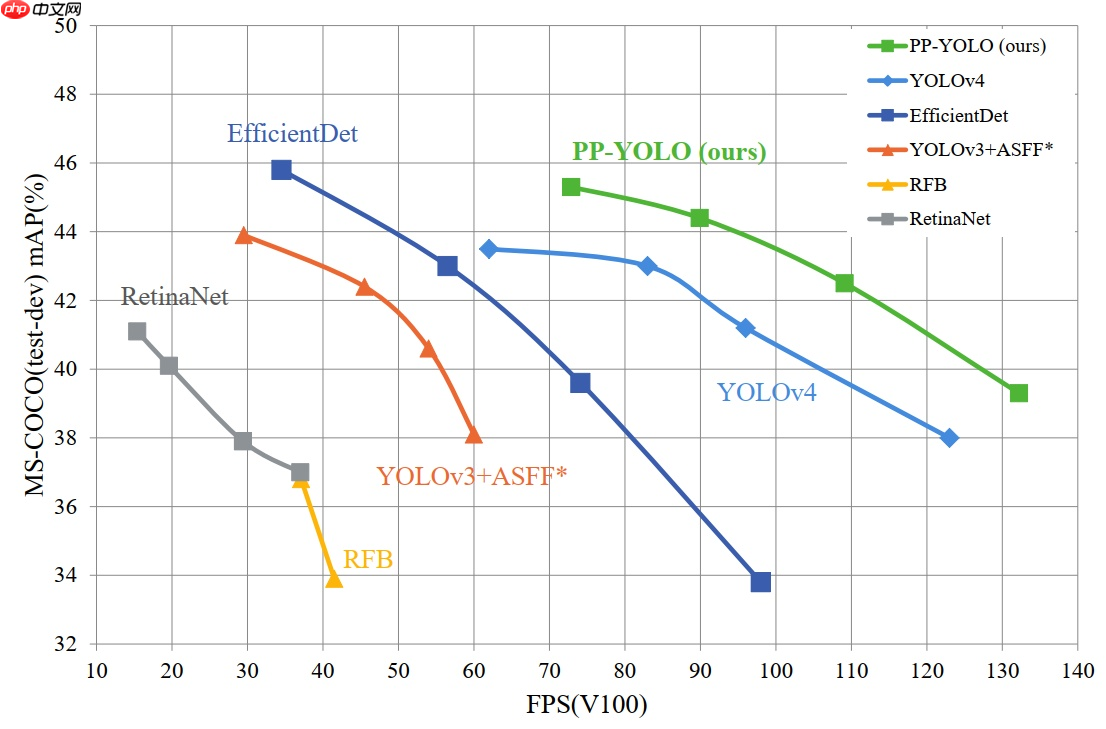
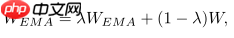
本文介绍低配版PP-YOLO实战过程。使用林业病虫害昆虫数据集,含2183张图片、7类昆虫。先处理数据,读取标注信息并转换格式,用多进程读取。接着构建模型,在backbone用大量可变形卷积,介绍PP-YOLO技巧,还涉及锚框标注、特征提取、预测计算等,最后展示检测效果。 ☞☞☞AI 智能聊天, 问…
-
基于PaddlePaddle复现的CycleMLP
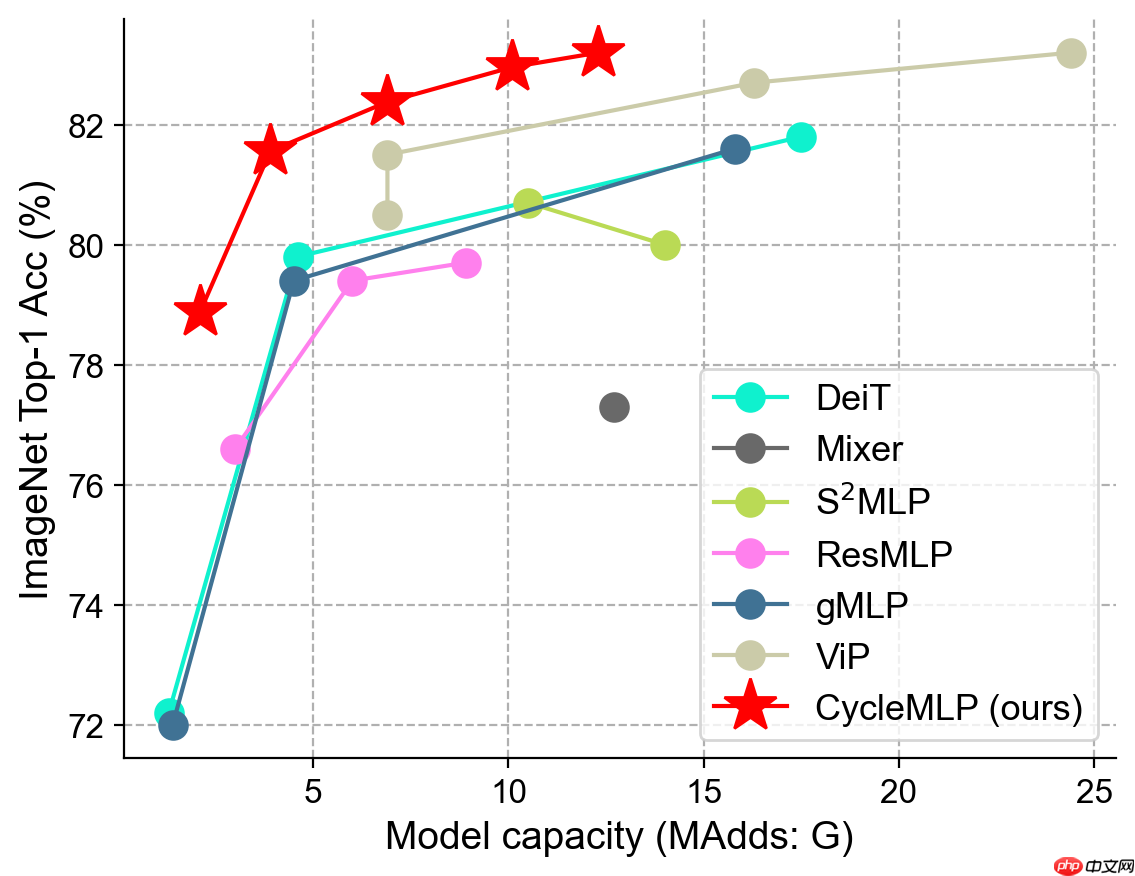
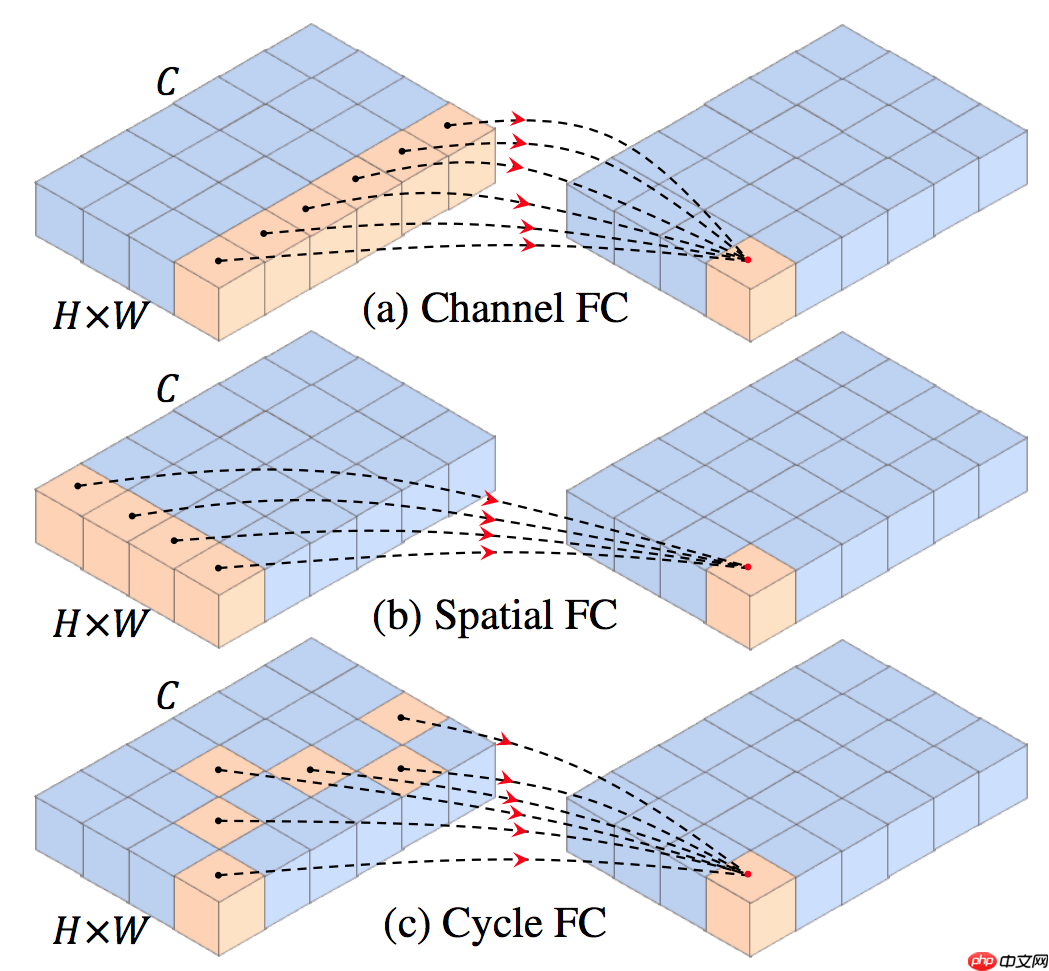
本文提出了一个简单的 MLP-like 的架构 CycleMLP,它是视觉识别和密集预测的通用主干,不同于现代 MLP 架构,例如 MLP-Mixer、ResMLP 和 gMLP,其架构与图像大小相关,因此是在目标检测和分割中不可行。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量…
-
Llasa TTS— 香港科技大学开源的文本转语音模型


Llasa TTS是什么 llasa tts 是香港科技大学基于 llama 架构推出的开源文本转语音(tts)模型,支持高质量语音合成和克隆。llasa tts 基于单层向量量化(vq)编解码器和单个 transformer 架构,与标准 llama 模型完全对齐,生成自然流畅的语音,支持情感表达…
-
MM-StoryAgent— 上海交大联合阿里开源的多智能体故事绘本视频生成框架


mm-storyagent:一个开源的多模态、多智能体故事绘本视频生成框架 上海交通大学X-LANCE实验室和阿里巴巴集团联合打造的MM-StoryAgent,是一个开源框架,旨在生成沉浸式、有声的故事绘本视频。它巧妙地结合了大型语言模型(LLMs)和多种模态的生成工具(包括文本、图像、音频),并采…
-
Gemini 2.0 Flash— Google推出的多模态 AI 模型


Gemini 2.0 Flash是什么 gemini 2.0 flash是google推出的多模态ai模型,结合文本理解和图像生成能力。根据自然语言输入生成高质量的图像,支持多轮对话式的图像编辑,保持上下文连贯性。模型擅长将文本与图像结合,例如为故事生成连贯的插图、根据对话修改图像风格,用世界知识生…
-
Multi-Speaker— AudioShake 推出的多说话人声分离模型


Multi-Speaker是什么 multi-speaker是audioshake推出的全球首个高分辨率多说话人分离模型。支持将音频中的多个说话人精准分离到不同轨道,解决传统音频工具在处理重叠语音时的难题。multi-speaker适用于多种场景,先进神经架构支持高采样率,适合广播级音频,支持处理长…


