
模型
-
SDXL Turbo和LCM带来AI画图的实时生成时代:速度跟打字一样快,图像瞬间呈现


Stability AI在本周二推出了新一代的图像合成模型——Stable Diffusion XL Turbo,这款模型引起了人们的热烈反响。许多人表示,使用该模型进行图像到文本生成变得前所未有的容易 在输入框中输入你的想法,SDXL Turbo 将快速响应并生成相应的内容,无需其他操作。无论你输…
-
一张照片生成视频,张嘴、点头、喜怒哀乐,都可以打字控制


最近,微软进行的一项研究揭示了视频处理软件PS的灵活程度有多高 在这项研究中,你只要给 AI 一张照片,它就能生成照片中人物的视频,而且人物的表情、动作都是可以通过文字进行控制的。比如,如果你给的指令是「张嘴」,视频中的人物就会真的张开嘴。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费…
-
深入理解图表:ChartLlama,腾讯、南洋理工等开源图表巨兽


在图像理解领域,多模态大模型已经充分展示了其卓越的性能。然而,对于工作中经常需要处理的图表理解与生成任务,现有的多模态模型仍有进步的空间。 尽管目前在图表理解领域中,最先进的模型在简单测试集上表现出色,但是由于它们缺乏语言理解和输出能力,因此无法胜任更为复杂的问答任务。另一方面,基于大语言模型训练的…
-
全球瞩目的「科目三」:梅西、钢铁侠、二次元小姐姐轻松应对


最近一段时间,你可能或多或少的听到过「科目三」,摇花手、半崴不崴的脚,配合着节奏鲜明的音乐,这一舞蹈动作遭全网模仿。 如果相似的舞蹈,让 AI 生成会怎样?就像下图所展示的,不管是现代人、还是纸片人,都做着整齐划一的动作。你可能猜不到的是,这是根据一张图片生成的舞蹈视频。 ☞☞☞AI 智能聊天, 问…
-
微软仅凭「提示工程」让GPT-4成医学专家!超过一众高度微调模型,专业测试准确率首次超90%


微软最新研究再次证明了提示工程的威力—— 无需额外微调,无需专家策划,仅凭提示,GPT-4就能化身“专家”。 使用他们提出的最新提示策略Medprompt,在医疗专业领域,GPT-4在MultiMed QA九个测试集中取得最优结果。 在MedQA数据集(美国医师执照考试题)上,Medprompt让G…
-
大模型应用设计的十个思考
技术不是万能的,但没有技术却可能是万万不能的,对于大模型可能也是如此。基于大模型的应用设计需要聚焦于所解决的问题,在自然语言处理领域,大模型本身在一定程度上只是将各种NLP任务统一成了sequence 到 sequence 的模型。利用大模型, 我们是在解决具体的生产和生活中的问题,产品和技术上的设…
-
练习时长两年半,特斯拉人形机器人Optimus二代上线

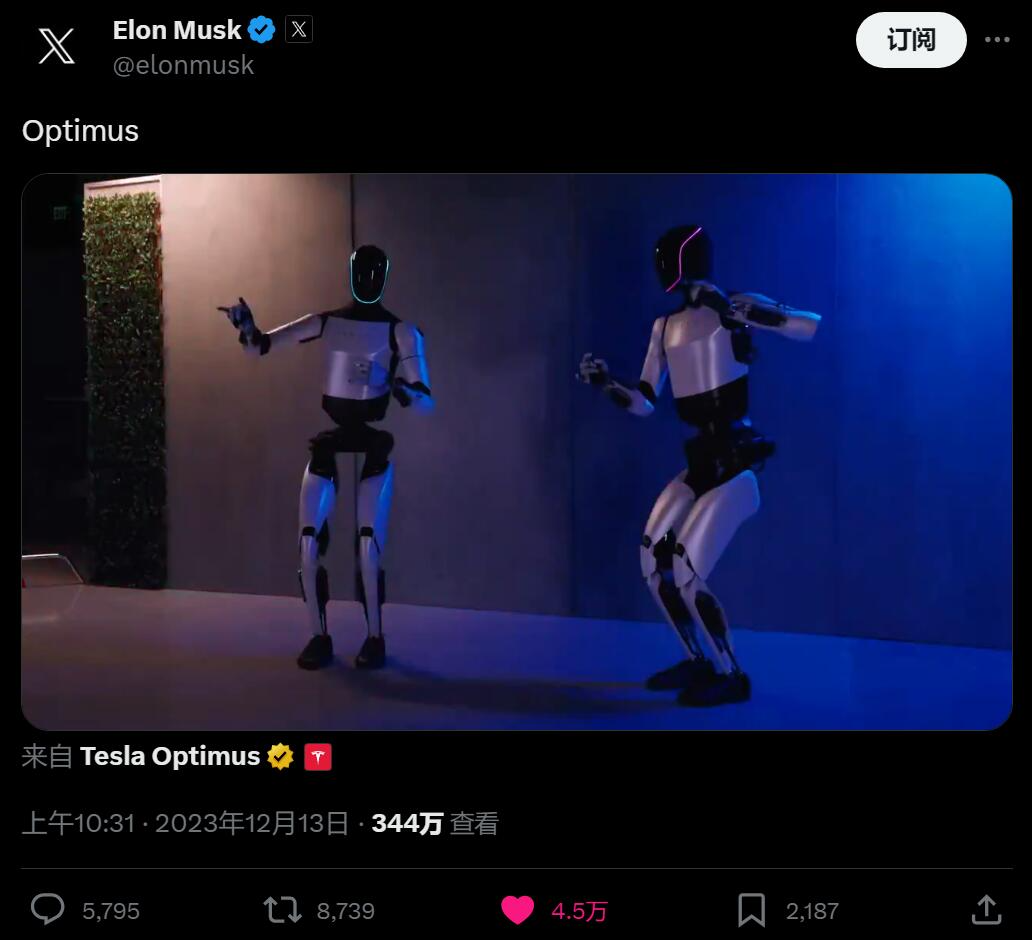
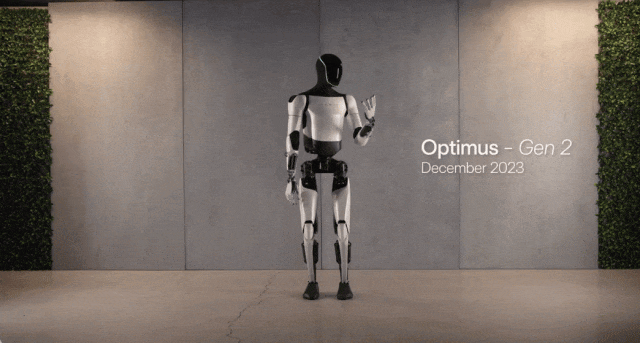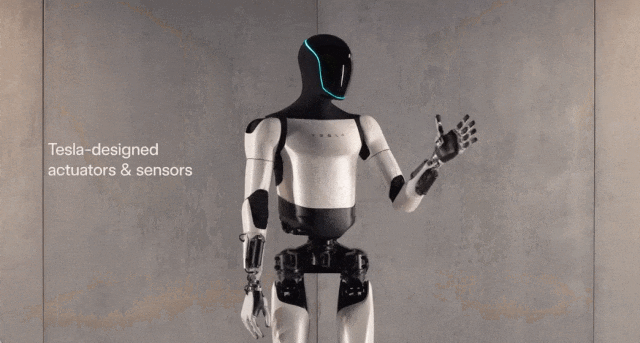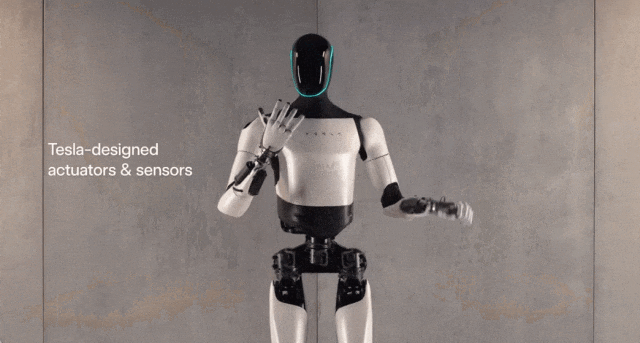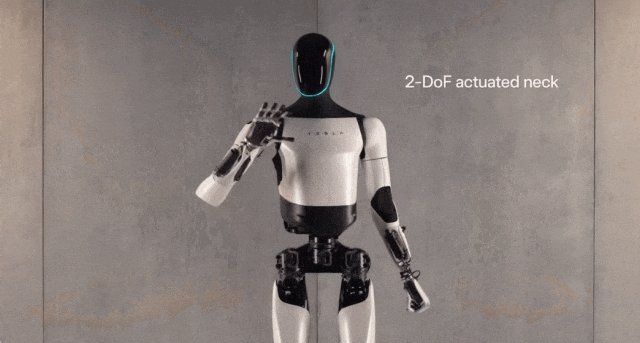
特斯拉人形机器人「Optimus」第二代突然出现,没有提前任何预告 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 12月13日上午,马斯克突然在X平台发布了一段视频: 马斯克不多解释,直接用视频内容展示了 Optimus 的诸多新能力。 从…
-
扩散模型与NeRF结合,清华文生提出3D新方法达到SOTA


用文字合成3d图形的ai模型,又有了新的sota! 近日,清华大学刘永进教授课题组提出了一种基于扩散模型的文生3D新方式。 无论是不同视角间的一致性,还是与提示词的匹配度,都比此前大幅提升。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 图…
-
旷视开源多模态大模型,支持文档级OCR,覆盖中英文,是否标志着OCR的终结?
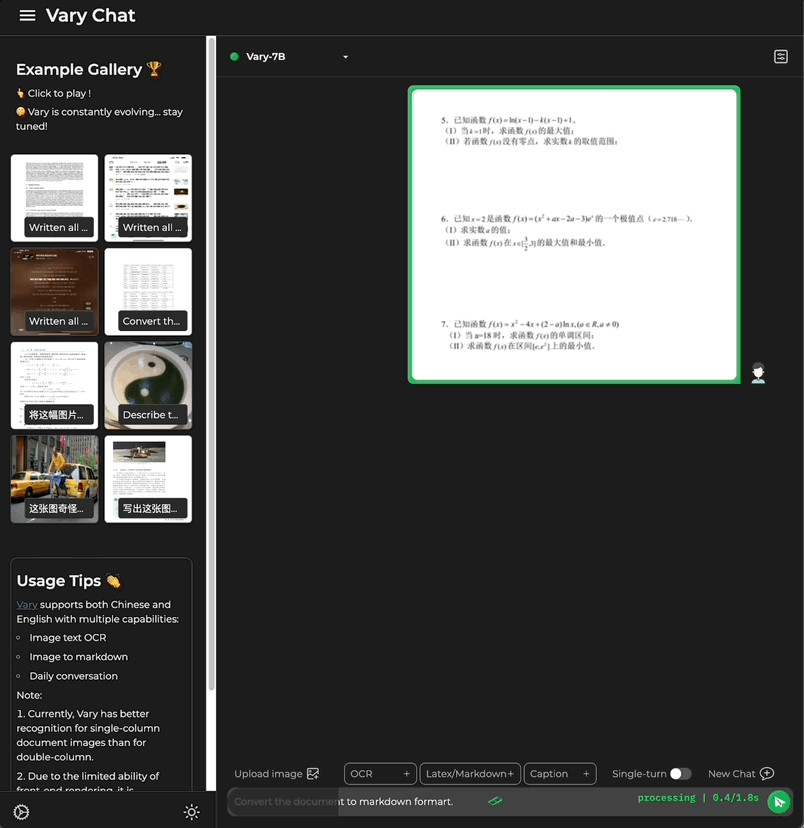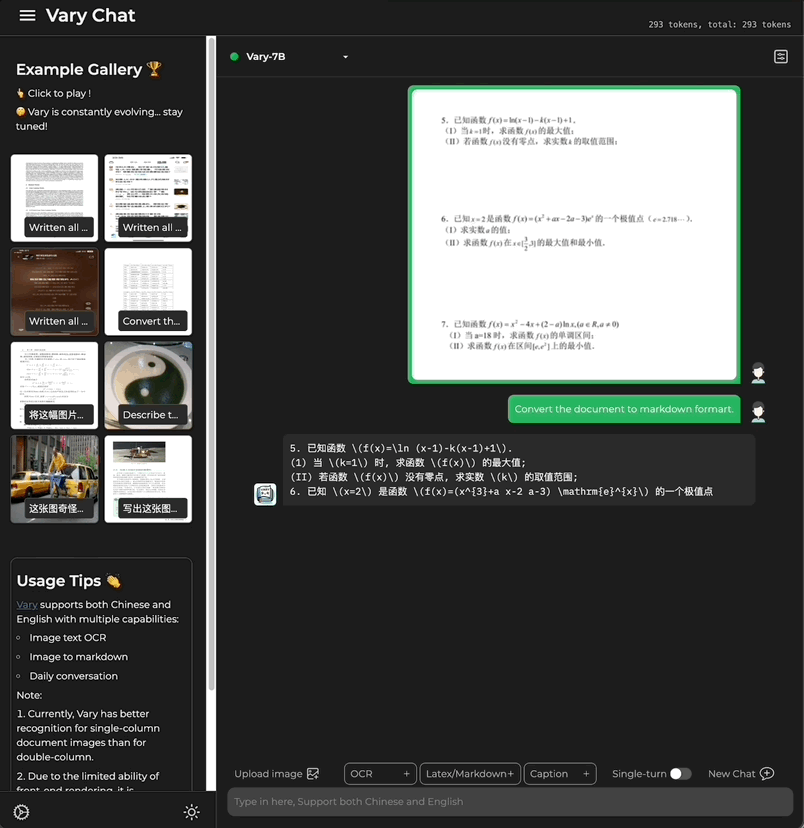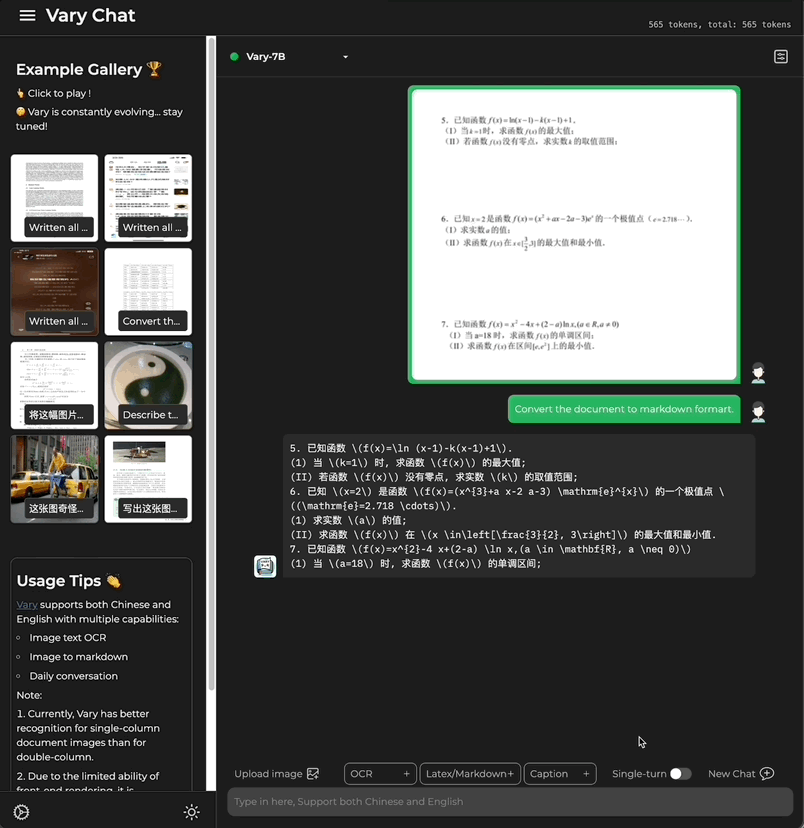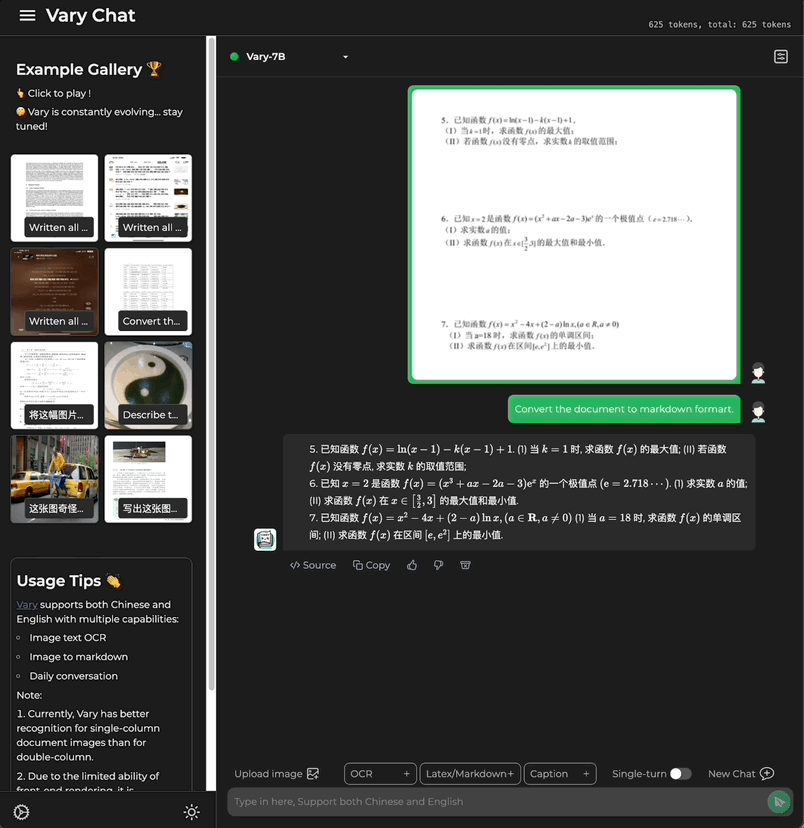
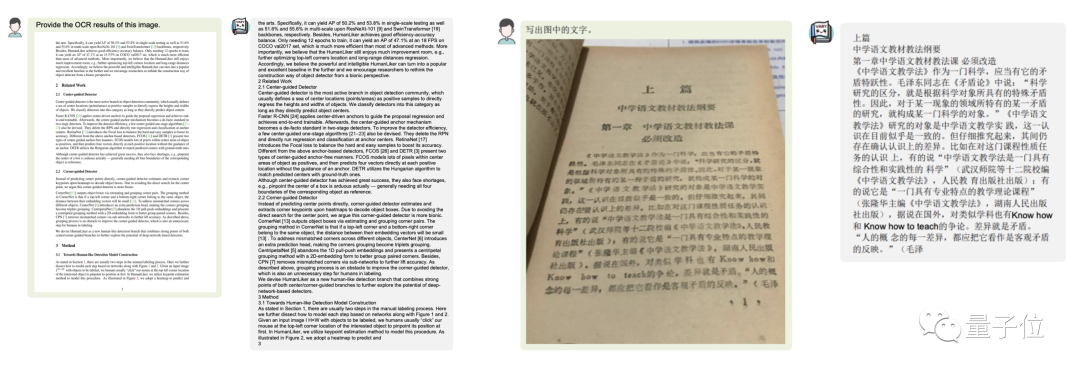
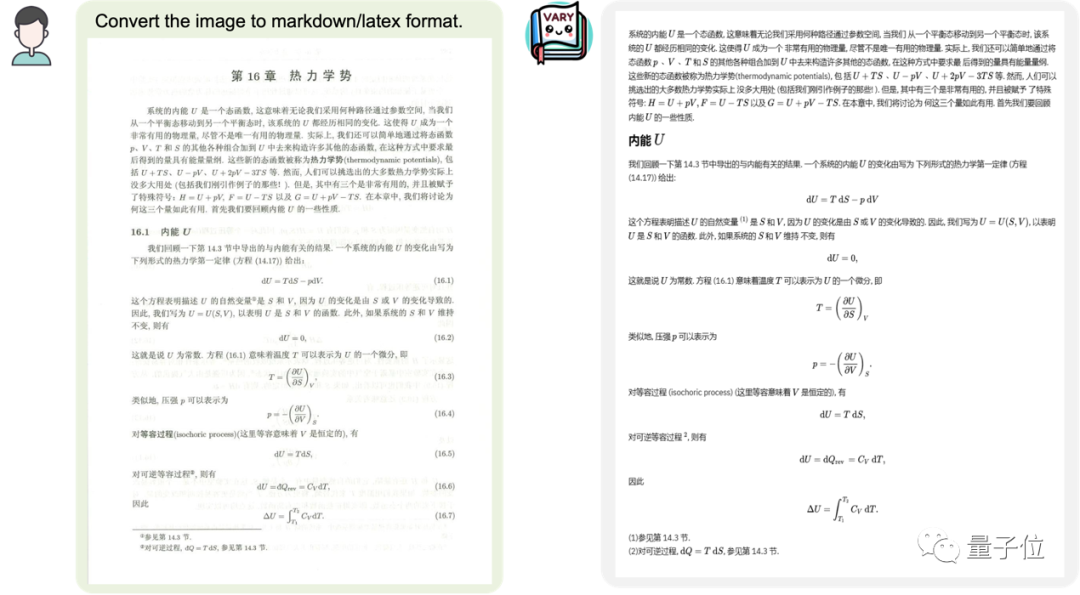
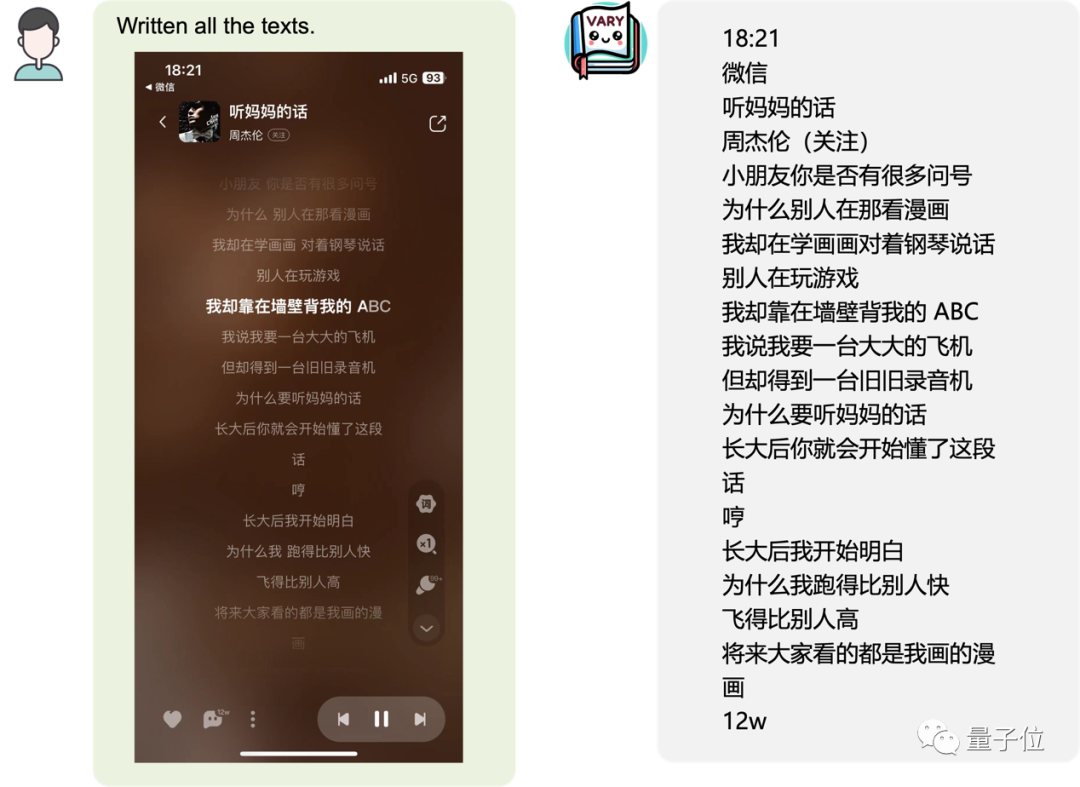
想将一份文档图片转换成markdown格式? 以往这一任务需要文本识别、布局检测和排序、公式表格处理、文本清洗等多个步骤—— 这一次,只需一句话命令,多模态大模型Vary直接端到端输出结果: ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 图…
-
高情商的NPC来了,刚伸出手,它就做好了要配合下一步动作的准备


在虚拟现实、增强现实、游戏和人机交互等领域,经常需要让虚拟人物和屏幕外的玩家互动。这种互动是即时的,要求虚拟人物根据操作者的动作进行动态调整。有些互动还涉及物体,比如和和虚拟人物一起搬动一把椅子,这就需要特别关注操作者手部的精确动作。智能、可交互的虚拟人物的出现,将极大地提升人类玩家与虚拟人物的社交…


