
模型
-
基于LLaMA却改张量名,李开复公司大模型引争议,官方回应来了


前段时间,开源大模型领域迎来了一个新的模型 —— 上下文窗口大小突破 200k,能一次处理 40 万汉字的「Yi」。 创新工场董事长兼 CEO 李开复创立了大模型公司「零一万物」,并且构建了这个大模型,其中包括了 Yi-6B 和 Yi-34B 两个版本 根据 Hugging Face 英文开源社区平…
-
MySQL 中 QueryCache 的锁模型
有同学在问 MySQL中 QueryCache(QC)的锁是 全局锁还是 表锁。这里简要说明一下。 1、 QC基本概念 这个是实现在MySQL层(非引擎层)的一个内存结构,基本规则是将满足一定条件的查询结果缓存在内存中,若同样的查询再执行第二次,而且缓存没有失效,则可以直接返 有同学在问 MySQL…
-
首个支持4-bit浮点量化的LLM来了,解决LLaMA、BERT等的部署难题
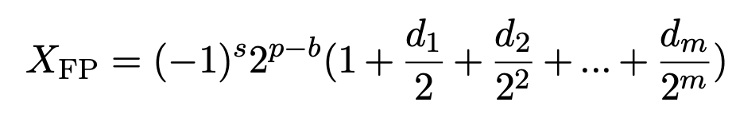
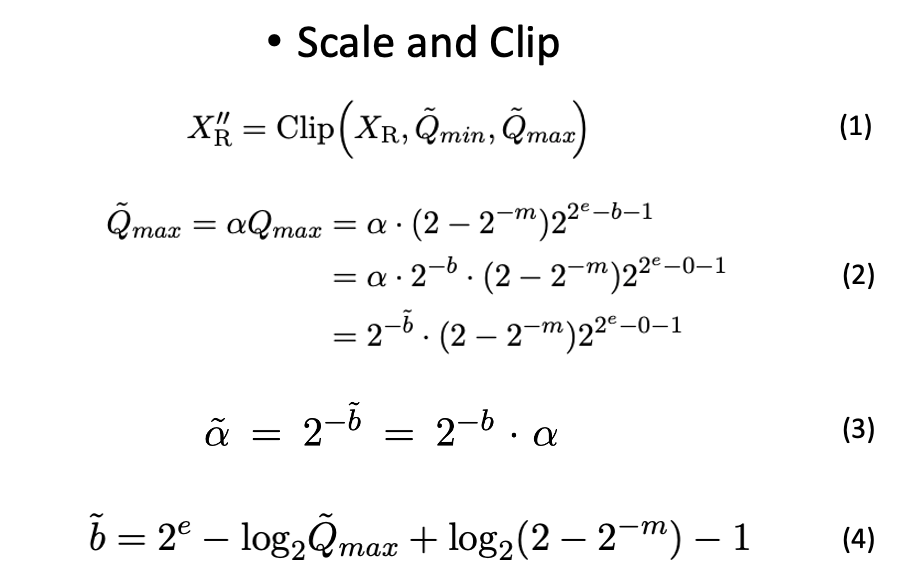
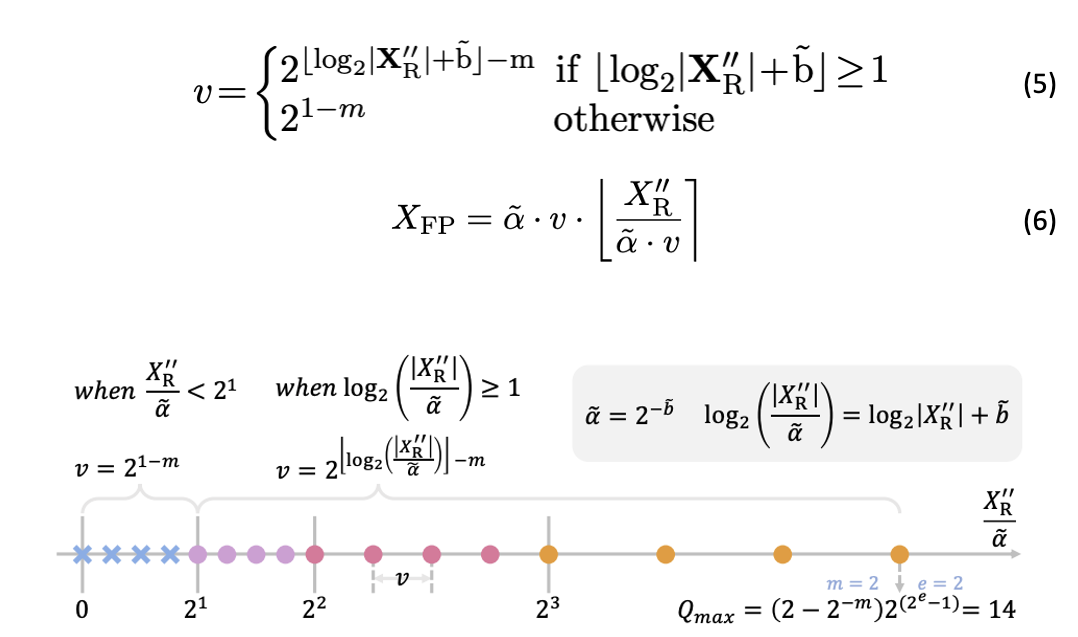
大语言模型 (LLM) 压缩一直备受关注,后训练量化(Post-training Quantization) 是其中一种常用算法,但是现有 PTQ 方法大多数都是 integer 量化,且当比特数低于 8 时,量化后模型的准确率会下降非常多。想较于 Integer (INT) 量化,Floating…
-
从 DeiT-B 到 DeiT-S,块结构化剪枝在深度 ViTs上 的应用 !
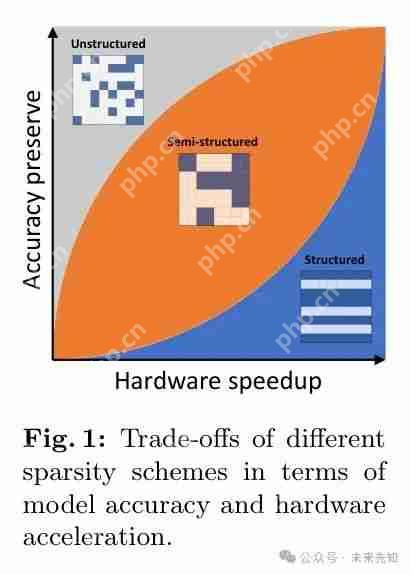
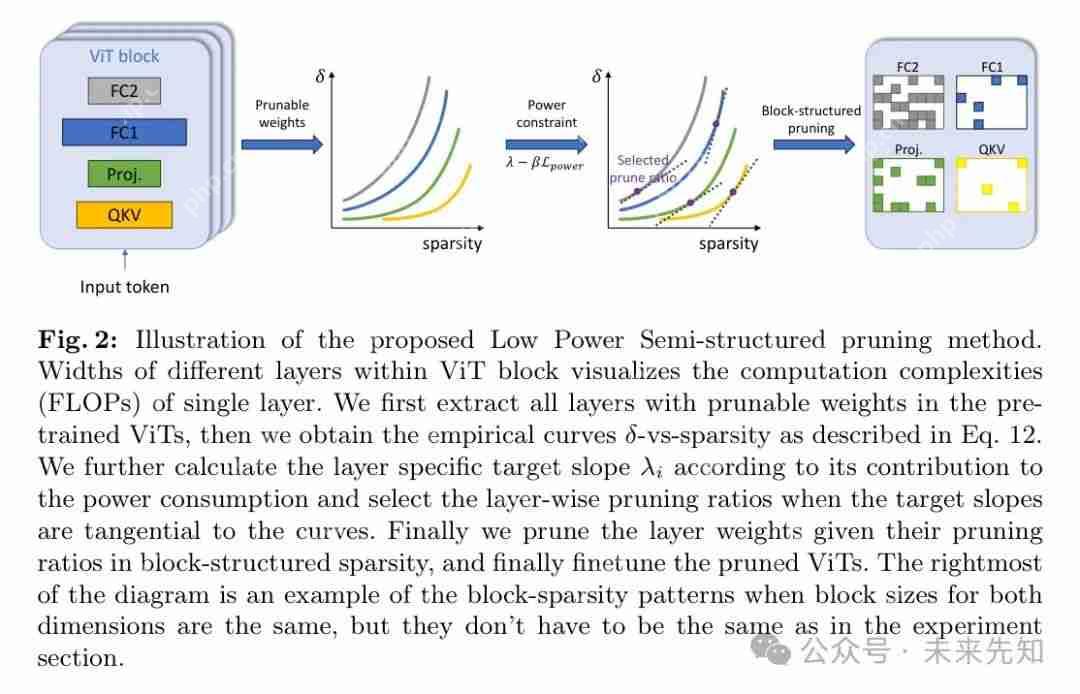
1 Introductions 近期,视觉 transformer (vits)成为一项新兴研究,极大地挑战了占主导地位的卷积神经网络(cnns),在诸如分类[9, 13, 18, 22, 44]、目标检测[1, 3, 61]、语义分割[5, 35]等各种图像分析和理解任务上表现出与cnns相当甚至…
-
「无需配对数据」就能学习!浙大等提出连接多模态对比表征C-MCR


多模态对比表示(MCR)旨在将来自不同模态的输入编码到一个语义对齐的共享空间中 随着视觉-语言领域中CLIP模型的巨大成功,越来越多的模态对比表征开始出现,并在许多下游任务上取得明显的改善,但这些方法严重依赖于大规模高质量的配对数据 为了解决这个问题,来自浙江大学等机构的研究人员提出了连接多模态对比…
-
阿里 8B 模型拿下多页文档理解新 SOTA,324 个视觉 token 表示一页,缩减 80%
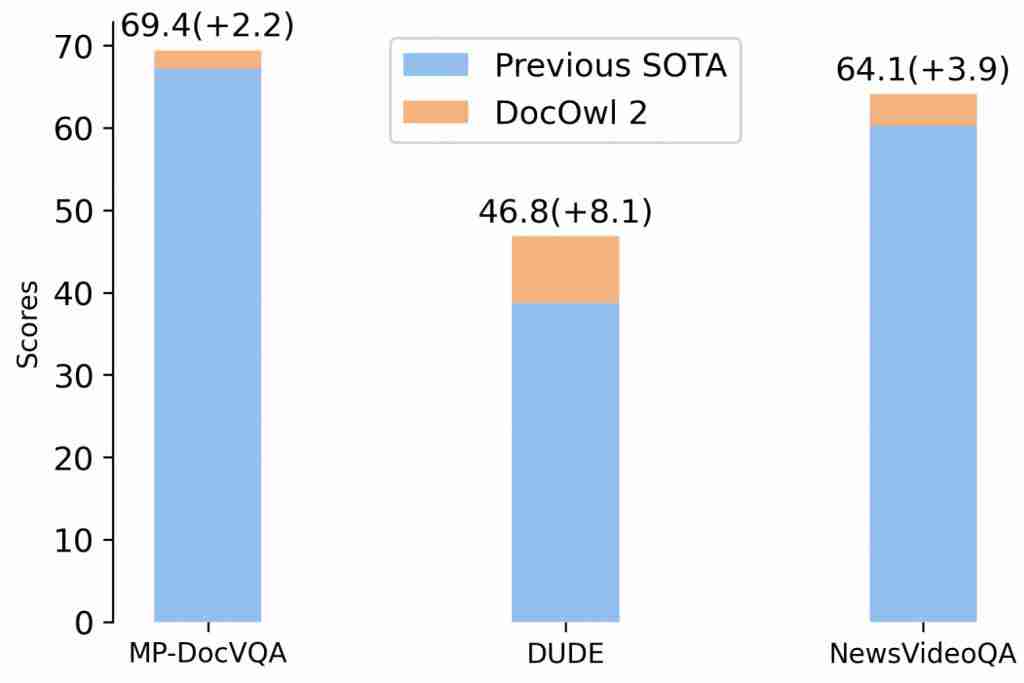
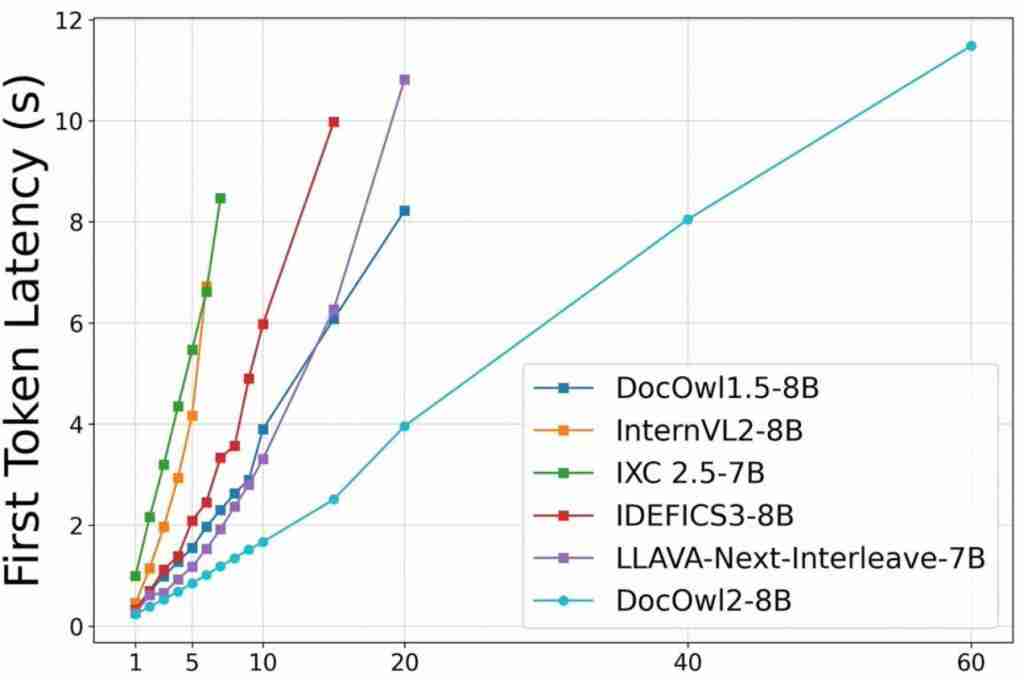
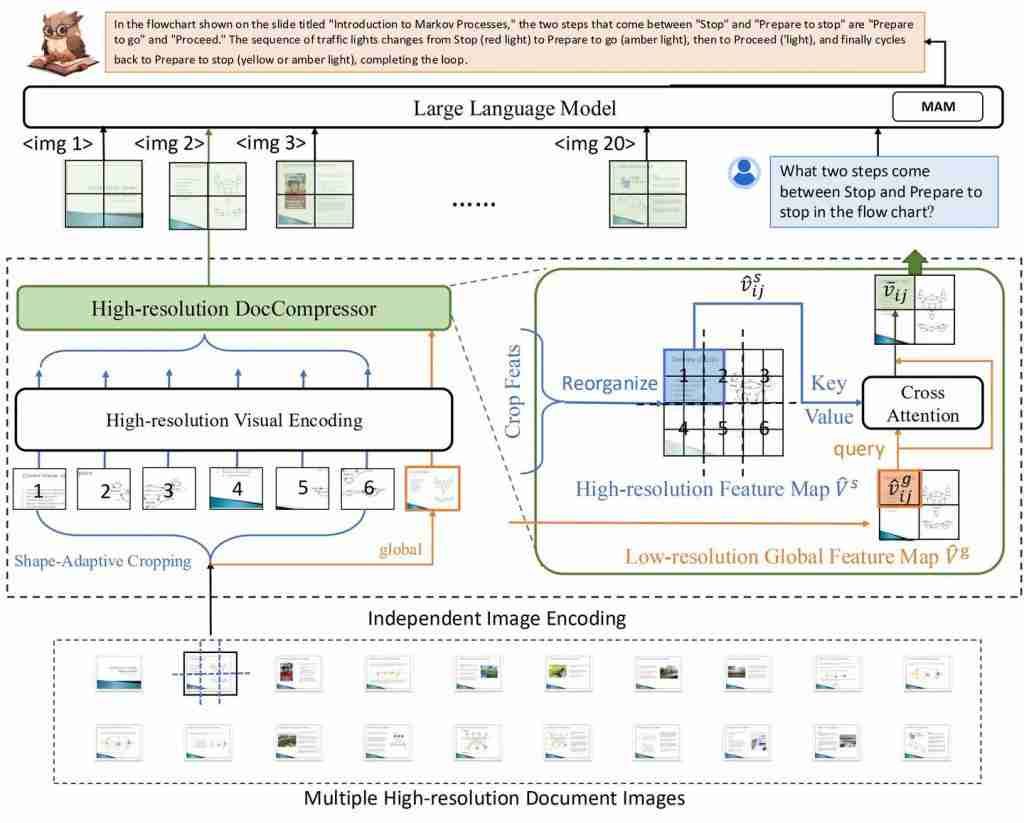
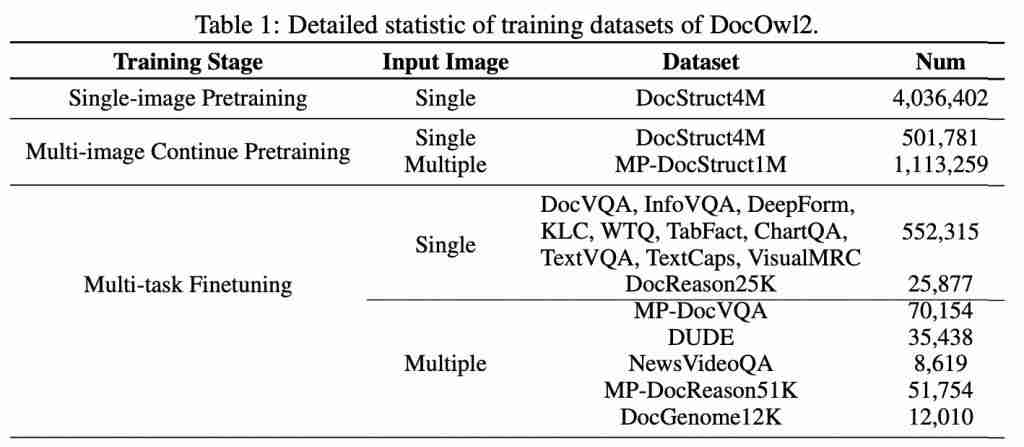
高效多页文档理解,阿里通义实验室 mplug 团队拿下新 sota。 最新多模态大模型mPLUG-DocOwl 2,仅以 324 个视觉 token 表示单个文档图片,在多个多页文档问答 Benchmark 上超越此前 SOTA 结果。 并且在 A100-80G 单卡条件下,做到分辨率为 1653&…
-
Stable Video Diffusion来了,代码权重已上线


AI 画图的著名公司 Stability AI,终于入局 AI 生成视频了。 这周二,基于稳定扩散的视频生成模型 Stable Video Diffusion 推出了,AI 社区立即展开了讨论 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ …
-
深度学习中的代码数据增强:5年89篇研究综述
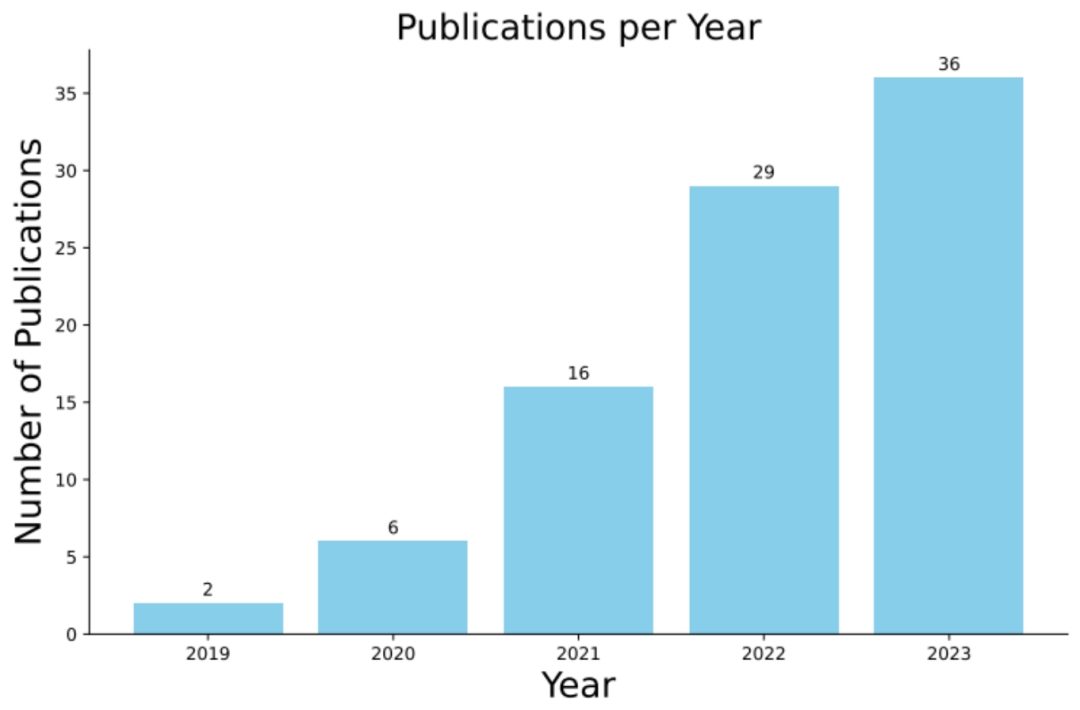
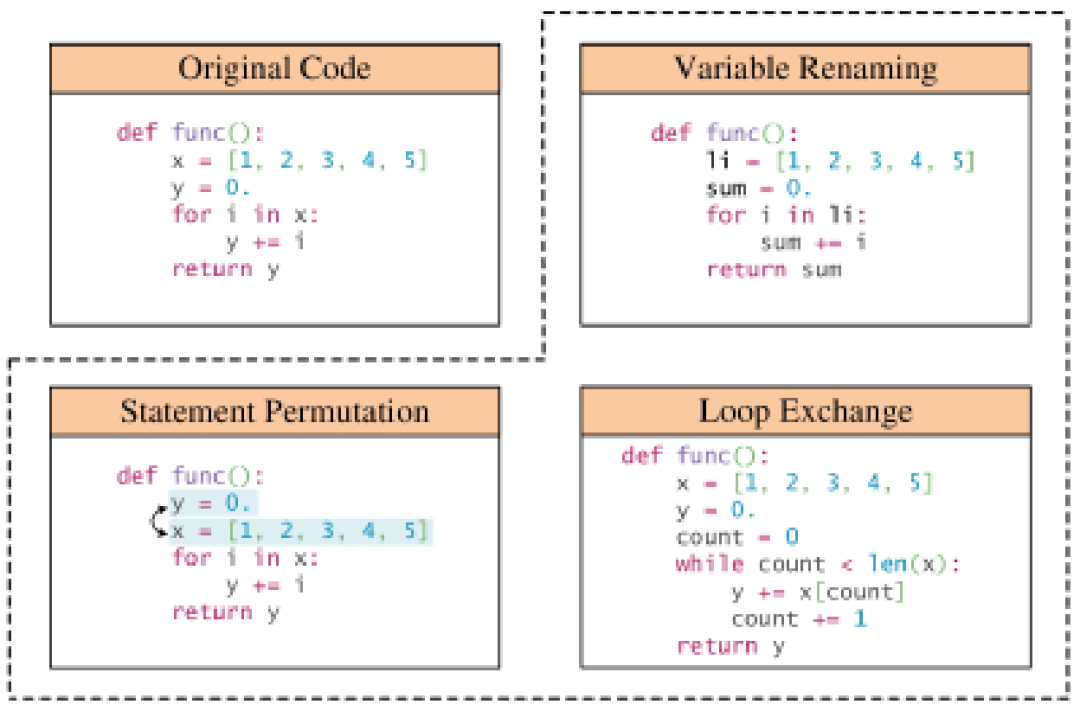
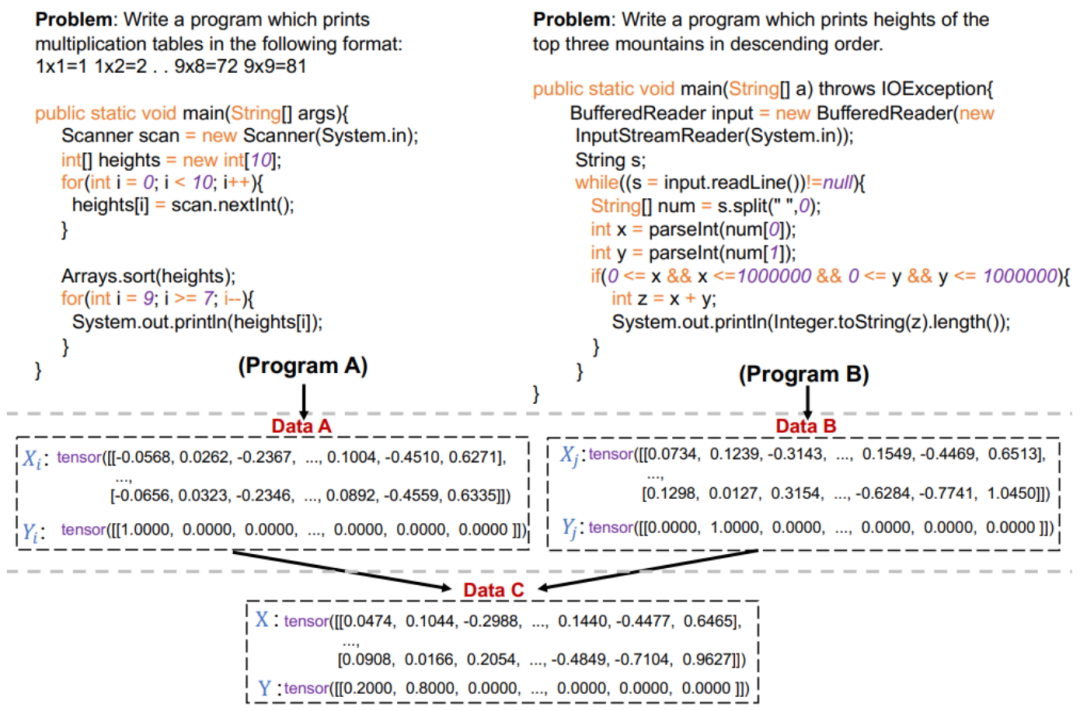
随着深度学习和大型模型的快速发展,对创新技术的追求不断增加。在这个过程中,数据增强技术展现出了不可忽视的价值 最近,由蒙纳士大学、新加坡管理大学、华为诺亚方舟实验室、北京航空航天大学以及澳大利亚国立大学联合进行的对近 5 年的 89 篇相关研究调查,发布了一份关于代码数据增强在深度学习中应用的全面综…
-
新标题:Meta改进Transformer架构:强化推理能力的新注意力机制


大型语言模型(LLM)的强大已经是不容置疑的事实,然而它们有时仍然会犯一些简单的错误,显示出推理能力较弱的一面 举个例子,LLM 可能会因为不相关的上下文或者输入提示中固有的偏好或意见而做出错误的判断。后一种情况表现出的问题被称为「阿谀奉承」,即模型与输入保持一致 是否有任何方法可以缓解这类问题呢?…
-
视频生成新突破:PixelDance,轻松呈现复杂动作与炫酷特效


近期,除了广受关注的大型语言模型持续占据头条,视频生成技术也在不断取得重大突破,多家公司已经相继发布了新的模型 首先,Runway作为最早探索视频生成领域的领头羊之一,升级了其Gen-2模型,带来了电影级别的高清晰度,令人瞩目。同时,视频生成的一致性也得到了重大改进 但是,这种一致性的提升似乎是以牺…

